Was kostet eine nationale KI-Infrastruktur? Eine Modellrechnung
Wie viele GPUs, wie viel Strom und wie viel Geld braucht eine KI, die 7 Millionen Menschen in der Schweiz nutzen? Wir rechnen es mit DeepSeeks veröffentlichten Betriebszahlen durch: 57 Millionen Franken im Jahr im Basisfall, mit Annahmen, Sensitivität und einem Rechner zum Selbstverändern.
Analyse · Veröffentlicht 22.10.2026 · Aktualisiert 22.10.2026 · Joel Barmettler
Worum es geht: was eine nationale KI kosten würde
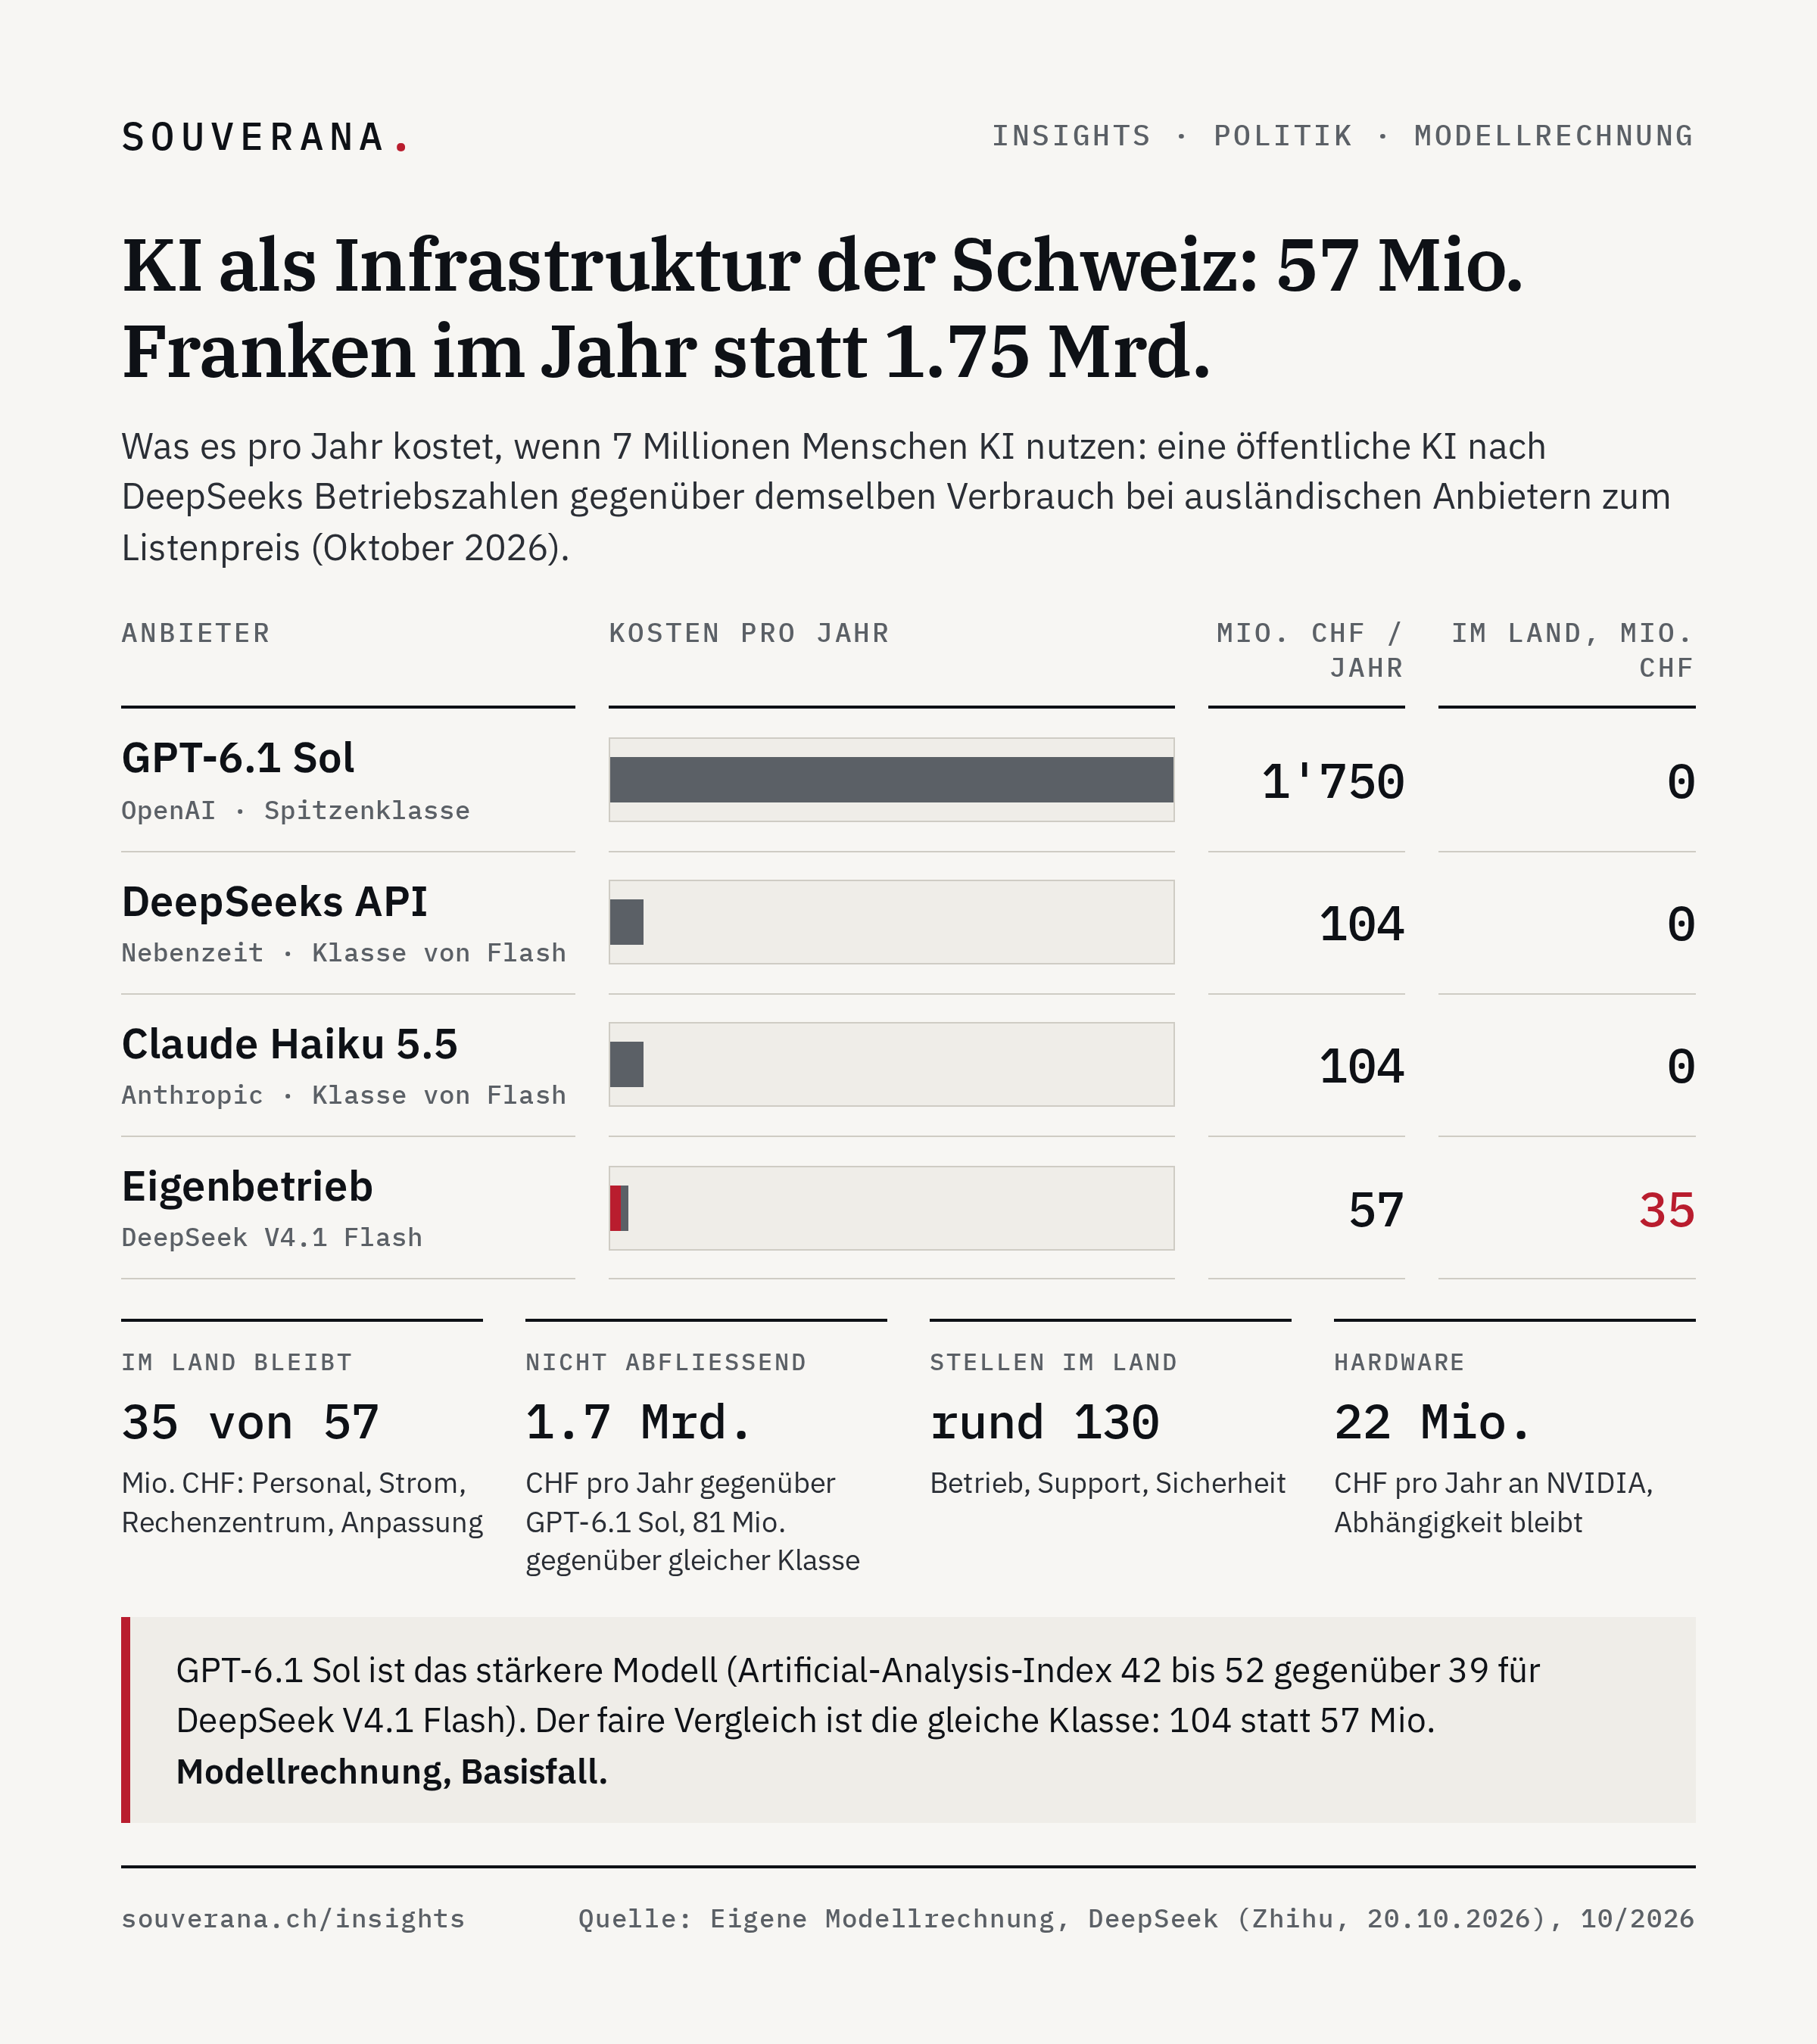
Eine KI, die 7 Millionen Menschen in der Schweiz nutzen, kostet in unserer Modellrechnung 57 Millionen Franken im Jahr. 35 Millionen davon bleiben im Land. Dieselbe Textmenge (gemessen in Tokens) würde bei einem Frontier-Modell wie GPT-6.1 Sol zum Listenpreis 1.75 Milliarden Franken kosten, alles im Ausland.
Das Wichtigste in Kürze
- Nachfrage: 7 Millionen Nutzer verbrauchen pro Tag 11.9 Billionen Eingabe- und 293 Milliarden Ausgabe-Tokens. Die Agenten sind nur 11 Prozent der Nutzer, erzeugen aber zwei Drittel der Eingabe.
- Hardware: Das braucht rund 1’300 GPUs (Reserve eingerechnet) mit 2.6 Megawatt Leistung, ausgelegt auf das 2.75-Fache der mittleren Last, damit auch die Bürospitze bedient wird. Die Hardware kostet einmalig 85 Millionen Franken.
- Kosten: Der Betrieb kostet 57 Millionen Franken im Jahr, CHF 6.29 pro Einwohner. Personal ist mit 26 Millionen der grösste Posten. 35 Millionen bleiben im Land, 22 Millionen gehen als Hardware-Abschreibung ins Ausland.
- Vergleich: Dieselbe Textmenge kostet bei einem Modell derselben Leistungsklasse rund 104 Millionen, der Eigenbetrieb ist also rund 45 Prozent günstiger. Bei GPT-6.1 Sol zum Listenpreis wären es 1.75 Milliarden. Bei 1 Million Nutzern ist der Eigenbetrieb nicht billiger als die API.
- Unternehmen: Bei normaler Büroarbeit sind Tokens eine kleine Position: CHF 263 pro Power-Nutzer und Jahr zum Listenpreis von GPT-6.1 Sol, rund CHF 5 zu den Selbstkosten. Bei Agenten in Produkten sind es CHF 559 gegenüber CHF 32. Günstige, vertrauenswürdige KI aus dem Inland beschleunigt zudem die Einführung, auch in Branchen wie Banken, und die wachsenden KI-Kosten bleiben als Wertschöpfung im Land, statt als Abgabe an einen US-Konzern abzufliessen.
- Sicherheit der Zahlen: Bei jeweils einer geänderten Annahme liegen die Kosten zwischen 42 und 83 Millionen Franken, im ungünstigsten Fall mit mehreren Annahmen zugleich bei 97 Millionen. Am stärksten wirken der Durchsatz pro GPU, der Verbrauch der Agenten und die Bürospitze.
Dieser Beitrag ist die Rechnung hinter unserer Antwort auf die Interpellation 26.4569 (Öffentliche KI für die Schweiz). Dort stehen die politischen Antworten, hier steht, wie die Zahlen entstehen: aus DeepSeeks veröffentlichten Betriebszahlen, Annahmen und einem Rechner, in dem Sie jede Annahme selbst ändern können.[1]
Wir schreiben für Leserinnen und Leser, die ChatGPT schon einmal benutzt haben. Mehr setzen wir nicht voraus. Der Beitrag beginnt bei den Grundlagen und wird Schritt für Schritt technischer. Grosse Tabellen und Grafiken sind aufklappbar.
Grundlagen: was bei jeder KI-Antwort passiert
Dieser Abschnitt erklärt in wenigen Absätzen, was Sie für den Rest brauchen.
Ein Modell läuft auf GPUs
Wenn Sie ChatGPT eine Frage stellen, rechnet ein Sprachmodell in einem Rechenzentrum die Antwort aus. Das Modell ist eine sehr grosse Datei aus Zahlen, den Gewichten. Gerechnet wird auf GPUs, Chips, die ursprünglich für Grafik gebaut wurden und heute die meisten KI-Berechnungen ausführen.
Tokens: wonach abgerechnet wird
Ein Sprachmodell liest und schreibt in Tokens, kleinen Wortstücken. Im Deutschen sind das etwas mehr als vier Zeichen pro Token: Die Bundesverfassung mit rund 126’000 Zeichen umfasst gemessen rund 30’000 Tokens (je nach Modell etwas mehr oder weniger).
Eingabe-Tokens sind alles, was das Modell liest: Ihre Frage, der bisherige Gesprächsverlauf, hochgeladene Dokumente. Ausgabe-Tokens sind die Antwort. Anbieter verrechnen beide getrennt, pro Million Tokens. Wir rechnen in diesem Beitrag nicht mit Monatsabos wie bei Microsoft Copilot, sondern mit dem, was die Nutzung nach verbrauchten Tokens kostet. Die Eingabe ist meist viel länger als die Ausgabe. Besonders lang ist sie bei Agenten, also Programmen, die mit dem Modell mehrere Schritte selbständig erledigen, etwa Code schreiben oder Anträge bearbeiten. Ein Agent liest bei jedem Schritt den ganzen bisherigen Verlauf erneut.
Der Betrieb ist der Kostenblock
Ein Modell zu trainieren kostet einmal sehr viel. Jede einzelne Antwort zu berechnen, die Inferenz, kostet dagegen bei jeder Nutzung Rechenzeit auf einer GPU. Bei Millionen Nutzern ist die Inferenz der laufende Kostenblock. Jede Antwort entsteht in zwei Schritten: Zuerst liest das Modell die ganze Eingabe (Prefill), dann schreibt es die Antwort Token für Token (Decode). Betreiber lassen beide Schritte meist auf getrennten Servern laufen, weil die beiden Schritte die Hardware verschieden belasten. Wie viel ein Token kostet, hängt deshalb davon ab, wie gut ein Betreiber seine GPUs auslastet.
Nicht jedes Modell ist gleich stark
Sprachmodelle spielen in verschiedenen Leistungsklassen. In der Spitzenklasse liegen Modelle wie OpenAIs GPT-6.1 Sol. Eine Klasse darunter liegen Modelle wie DeepSeek V4.1 Flash und Claude Haiku 5.5, die weit günstiger sind. Im Intelligence Index von Artificial Analysis, einem Leistungsvergleich von Modellen, kommt GPT-6.1 Sol je nach Denkaufwand (wie lange das Modell vor der Antwort nachdenkt) auf 42 bis 52 Punkte, Claude Haiku 5.5 auf 34 bis 43 und DeepSeek V4.1 Flash auf 39.[2, 3] Für viele Alltagsaufgaben wie Zusammenfassen, Übersetzen oder Fragen zu Dokumenten genügt oft die zweite Klasse. Bei schwierigen Aufgaben bleibt der Vorsprung der Spitzenklasse real.
Offene und geschlossene Modelle
Ein geschlossenes Modell wie GPT-6.1 Sol erreichen Sie nur über den Dienst des Anbieters. Bei einem offenen Modell veröffentlicht der Entwickler die Gewichte, und jeder kann es auf eigener Hardware betreiben. DeepSeek V4.1 Flash steht unter der MIT-Lizenz, die den Betrieb und die Veränderung erlaubt. Das Schweizer Modell Apertus von ETH Zürich, EPFL und dem Nationalen Hochleistungsrechenzentrum der Schweiz (CSCS) ist ebenfalls offen (Beitrag zu Apertus).[4] Nur ein offenes Modell kann ein Land oder ein Unternehmen auf eigener Hardware selbst betreiben.
Wiederverwenden macht den Betrieb billig
Liest ein Modell einen Text, berechnet es Zwischenergebnisse und legt sie in einem schnellen Zwischenspeicher ab, dem Cache. Wird derselbe Textanfang später noch einmal gesendet, kann das Modell diese Zwischenergebnisse wiederverwenden, und die Kosten sinken stark. DeepSeek liest im Mittel 96 Prozent der Eingabe aus dem Cache.[1] Deshalb kann DeepSeek V4.1 Flash für 0.30 US-Dollar pro Million Eingabe-Tokens anbieten und verdient trotzdem Geld: rund 38 US-Dollar Umsatz bei Hardwarekosten von grob 2 bis 2.50 US-Dollar, jeweils pro GPU und Stunde.[5]
DeepSeeks Betriebszahlen sind der Massstab, weil das Modell zu den effizientesten gehört und seine Zahlen veröffentlicht sind. Wer sie nachprüfen will, findet sie im Beitrag zu DeepSeeks Betrieb.
Was wir rechnen
Wir wollen wissen, was es kosten würde, eine KI für die ganze Schweiz selbst zu betreiben. Die Rechnung hat drei Schritte, und der Beitrag baut sie nach und nach auf.
- Nachfrage: Wie viele Menschen nutzen KI, und wie viele Tokens verbrauchen sie pro Tag?
- Hardware: Wie viele GPUs braucht es, um diese Tokens so zu erzeugen, wie DeepSeek es tut, und wie viel Strom und Platz benötigen diese GPUs?
- Kosten: Was kostet das pro Jahr, wie viel dieser Kosten bleibt im Land, und was würde dieselbe Tokenmenge bei einem ausländischen Anbieter kosten?
Wir rechnen mit einem einzigen Fall: 7 Millionen Nutzerinnen und Nutzer, das sind rund drei Viertel der Einwohner, von der gelegentlichen Chat-Nutzung bis zu KI-Agenten, die in der Wirtschaft laufen. Kleinere Fälle mit 1 und 5 Millionen Nutzern lassen sich im Rechner in Schritt 3 durchspielen. Jede Zahl stammt aus einer genannten Quelle, aus einer Annahme oder aus der Rechnung, und der Beitrag kennzeichnet, aus welcher.
Schritt 1: Wie viele Tokens die Schweiz verbraucht
Wer nutzt wie viel
Die Nutzung ist schon heute hoch. Laut Netzwoche (21. April 2026) nutzen 41 Prozent der Erwerbstätigen generative KI bei der Arbeit, bei den 16- bis 24-Jährigen setzen 79 Prozent sie überhaupt ein.[6] Laut einer Comparis-Umfrage vom März 2026 nutzen 76 Prozent der Erwachsenen regelmässig Chatbots, 2024 waren es 50 Prozent (Netzwoche, 2. April 2026).[7] Eine Studie der Universität Zürich nennt für 2025 einen Anteil von 17 Prozent, die die KI täglich nutzten (ZWP Online).[8]
Nicht alle verbrauchen gleich viel. Damit die Rechnung dem Verbrauch folgt, teilen wir die Nutzer in drei Profile ein. Die Tabelle zeigt, wie viele Tokens ein Nutzer des jeweiligen Profils an einem durchschnittlichen Tag liest und schreibt:
| Profil | Typische Nutzung | Eingabe-Tokens pro Tag | Ausgabe-Tokens pro Tag |
|---|---|---|---|
| Leicht | 15 Fragen mit etwas Verlauf und Suchresultaten | 90’000 | 10’500 |
| Power | 60 Dokument- und E-Mail-Aufgaben mit langem Kontext | 1’500’000 | 72’000 |
| Agent | Coding-Agenten, automatisierte Fallbearbeitung | 10’000’000 | 100’000 |
Power-Nutzer und Agenten lassen das Modell vieles mehrfach lesen. Deshalb stammen 85 Prozent (Power-Nutzer) und 96 Prozent (Agenten) der Eingabe aus dem Zwischenspeicher (Cache). Gerechnet wird mit einem nationalen KI-Angebot, das auch Unternehmen offensteht. Im Basisfall gibt es 7 Millionen Nutzer: 3.8 Millionen leichte, 2.4 Millionen Power-Nutzer und 0.8 Millionen im Agenten-Profil (Programme, die in Produkten und Abläufen der Wirtschaft laufen).
Was daraus an Verbrauch folgt
Aus den Profilen ergibt sich der Verbrauch des ganzen Landes pro Tag:
Kennzahl
11.9 Bio.Quelle: Eigene Modellrechnung, 20. Oktober 2026, 7 Millionen Nutzer
Die Agenten sind nur 11 Prozent der Nutzer, erzeugen aber zwei Drittel aller Eingabe-Tokens. Chatten ist billig. Teuer wird es, wo viele Agenten arbeiten.
Schritt 2: Welche Hardware das braucht
DeepSeek nennt Werte pro GPU. Beim Lesen der Eingabe (Prefill) schafft eine GPU 60’000 Tokens pro Sekunde, mit Cache-Treffern 1.5 Millionen. Beim Schreiben der Antwort (Decode) schafft sie 14’000 Tokens pro Sekunde.[1] Aus dem täglichen Verbrauch an Tokens folgt, wie viele GPUs nötig sind.
Wir rechnen mit festen Hardware-Blöcken, damit sich die Kapazität in gleichen Einheiten planen lässt. Ein Block besteht aus einem Rack mit 72 GPUs für Decode (NVIDIA GB300 NVL72, 64 GPUs arbeiten, 8 sind Reserve) und aus 8 Servern mit zusammen 64 GPUs für Prefill (NVIDIA HGX B300). Mit je 64 aktiven GPUs für Prefill und Decode entspricht der Block DeepSeeks Verhältnis von etwa 1:1. Die 8 Reserve-GPUs jedes Racks sind in allen GPU-Zahlen dieses Beitrags enthalten: 11 Racks zu 72 plus 63 Server zu 8 GPUs ergeben 1’296. Ein Block hat 136 GPUs, kostet rund 8.6 Millionen Franken und braucht rund 275 Kilowatt.[9–12]
Wir planen nicht für den Durchschnitt, sondern für die Spitze, denn in der Schweiz arbeiten alle in einer Zeitzone zur gleichen Zeit. Die stärkste Stunde trägt 9 Prozent des Tagesverkehrs, das 2.2-Fache des Durchschnitts. Die GPUs sollen dann höchstens zu 80 Prozent ausgelastet sein, wie bei DeepSeek. Die Hardware muss deshalb für das 2.75-Fache des durchschnittlichen Verkehrs reichen.
Für 7 Millionen Nutzer ergibt das 11 Decode-Racks und 63 Prefill-Server, zusammen 1’296 GPUs, also rund zehn Hardware-Blöcke. Zusammen brauchen diese GPUs 2.6 Megawatt Leistung und 8.9 Petabyte Speicher für den Cache. Diese Kapazität ist die Grundlage für die Kosten in Schritt 3.
Kennzahl
1'296Quelle: Eigene Modellrechnung, 20. Oktober 2026. Alps: CSCS
Welches Modell wir rechnen
Die Interpellation erwähnt Apertus als das Modell, das der Bund über den ETH-Bereich finanziert. Wir rechnen mit DeepSeek V4.1 Flash, weil es zu den effizientesten Modellen gehört: Es ist stark genug für die meisten Anwendungen, auch für Agenten, und lässt sich so günstig betreiben, dass ein Angebot für die ganze Bevölkerung finanzierbar wird. Laut DeepSeek schlägt es das frühere Flaggschiff V4 Pro.[13]
DeepSeek V4.1 Flash wäre das Standardmodell, Apertus läuft daneben, und jedes Modell durchläuft vor der Freigabe eine Schweizer Testsuite. Wie ein Schweizer Team das Standardmodell anpassen könnte, steht im Beitrag Öffentliche KI für die Schweiz.
Schritt 3: Was der Betrieb kostet
Was der Betrieb pro Jahr kostet
Im Basisfall kostet der Betrieb für 7 Millionen Nutzer 57 Millionen Franken im Jahr, rund CHF 6.29 pro Einwohner. Die Hardware kostet einmalig 85 Millionen Franken und ist in den Jahreskosten über vier Jahre abgeschrieben.
Die Tabelle zeigt, woraus die 57 Millionen Franken bestehen.
| Posten | Millionen Franken pro Jahr | Grundlage |
|---|---|---|
| Hardware (Abschreibung und Zins) | 22.2 | 85 Millionen Franken über 4 Jahre, 2 % Zins |
| Strom | 2.6 | 17.2 Gigawattstunden zu 15 Rappen pro Kilowattstunde |
| Rechenzentrum (Fläche und Kühlung, ohne Strom) | 3.1 | CHF 1.2 Mio. pro Megawatt IT-Last und Jahr |
| Personal | 26.0 | rund 130 Vollzeitstellen zu CHF 200’000 |
| Modell-Anpassung | 3.3 | Erstanpassung abgeschrieben plus Nachführung |
| Gesamt | 57.2 | rund CHF 0.68 pro Nutzer und Monat |
Zur Einordnung: Eine Million Tokens kostet im Eigenbetrieb im Mittel 1.3 Rappen, Eingabe und Ausgabe zusammen. Personal ist der grösste Posten, weil die Teile, die DeepSeek nicht veröffentlicht hat (Cache-Verwaltung und Load Balancing), ein Schweizer Team selbst bauen und betreiben müsste.
Woher die Position «Modell-Anpassung» kommt
Ein offenes Modell lässt sich mit Schweizer Daten nachtrainieren (Fine-Tuning). Dafür braucht es Anfrage-Antwort-Paare: eine Frage mit der gewünschten Antwort, die als Trainingsdaten dienen. Wozu das dient und wie das Vorgehen aussieht, steht im Beitrag Öffentliche KI für die Schweiz (Frage 4). Die Zahlen sind geschätzt, aufgebaut aus Aufwand und Preisannahmen. Im Basisfall kostet die Erstanpassung 5.0 Millionen Franken (Spanne: tief 2.7, hoch 10.1). Rund vier Fünftel der Kosten entfallen auf Personal und Daten (3.5 von 4.2 Millionen Franken vor der Reserve), nur 0.3 Millionen auf Rechenzeit. Allein die Daten kosten rund 2.3 Millionen: 0.8 für Zensur und Verzerrungen, 0.5 für Schweizer Werte und 1.0 für Rätoromanisch.
Dazu kommt die Nachführung: Die Anpassung muss bei neuen DeepSeek-Versionen wiederholt werden. Jede neue Version braucht einen neuen Durchlauf mit den vorhandenen Daten, gerechnet wird mit zwei Versionen im Jahr zu je rund 1.0 Millionen Franken, also 2.0 Millionen pro Jahr. Die Erstanpassung gilt pro Modellgeneration, hier für die V4-Reihe. Wir verteilen sie auf 4 Jahre (2 % Zins), das ergibt 1.31 Millionen pro Jahr. Zusammen sind das 3.3 Millionen Franken pro Jahr (tief 1.2, hoch 7.2), 6 Prozent der Jahreskosten im Basisfall.
Was dieselbe Menge im Ausland kosten würde
Als Gegenprobe haben wir dieselben Tokens zu den Listenpreisen ausländischer Anbieter gerechnet.[5, 16–20] Der Vergleich ist nur fair zwischen Modellen derselben Leistungsklasse. Die dritte Spalte zeigt, wie viel vom jeweiligen Betrag ins Ausland fliesst.
| Dieselbe Menge Tokens bei | Millionen Franken pro Jahr | davon ins Ausland |
|---|---|---|
| Eigenbetrieb (DeepSeek V4.1 Flash) | 57 | 22 (Hardware) |
| DeepSeeks API, Nebenzeit | 104 | 104 |
| Claude Haiku 5.5, Listenpreis | 104 | 104 |
| GPT-6.1 Sol, Listenpreis | 1’750 | 1’750 |
DeepSeeks API kostet in der Spitzenzeit das Doppelte der Nebenzeit, also rund 207 Millionen.[5] Wer DeepSeeks API nutzt, zahlt für dieselbe Menge schon in der Nebenzeit etwa das Doppelte des Eigenbetriebs, im Ausland und ohne Kontrolle über die Daten.
«Dieselbe Menge» ist der Tokenverbrauch aus Schritt 1: 11.9 Billionen Eingabe- und 293 Milliarden Ausgabe-Tokens pro Tag, rund 4.5 Billiarden Tokens im Jahr. Umgerechnet kostet eine Million Tokens im Eigenbetrieb im Mittel 1.3 Rappen, bei DeepSeeks API 2.3 Rappen (Nebenzeit) bis 4.6 Rappen (Spitzenzeit) und bei GPT-6.1 Sol 39 Rappen.
Zwei Vergleiche, die man nicht vermischen sollte:
- Gleiche Leistungsklasse: Gegenüber Claude Haiku 5.5 oder DeepSeeks API (je 104 Millionen) ist der Eigenbetrieb rund 45 Prozent günstiger. Es fliessen rund 81 Millionen Franken im Jahr weniger ins Ausland (104 Millionen gegenüber den 22 Millionen für die Hardware). Das ist der faire Vergleich.
- Frontier-Modell: GPT-6.1 Sol ist stärker (siehe Grundlagen) und kostet gut das 30-Fache des Eigenbetriebs. Gegenüber dem Listenpreis fliessen rund 1.7 Milliarden weniger ins Ausland. Die Zahl zeigt die Grössenordnung, nicht eine Prognose der Ausgaben.
Und wenn die Nutzer ein Abo haben?
Die meisten Menschen zahlen nicht pro Token, sondern ein Abo: ChatGPT Plus kostet in der Schweiz CHF 20 im Monat, ChatGPT Pro CHF 83 (Preisseite von OpenAI, Oktober 2026).[21] Das sind CHF 240 und CHF 996 im Jahr. Die Tabelle stellt sie den Tokenkosten der drei Profile aus Schritt 1 gegenüber, gerechnet zum Listenpreis von GPT-6.1 Sol und für 365 Tage:
| Profil | API, GPT-6.1 Sol | Abo | Verhältnis |
|---|---|---|---|
| Leicht | CHF 46 | Plus: CHF 240 | Abo rund 5-mal so teuer |
| Power | CHF 384 | Plus: CHF 240 | Abo rund 40 Prozent günstiger |
| Agent | CHF 816 | Pro: CHF 996 | Abo rund 20 Prozent teurer |
Für den Basisfall mit 7 Millionen Nutzern ergibt das:
| Szenario | Millionen Franken pro Jahr | Vielfaches des Eigenbetriebs |
|---|---|---|
| Eigenbetrieb (DeepSeek V4.1 Flash) | 57 | 1 |
| Alle 7 Millionen mit Plus-Abo | 1’680 | rund 29 |
| 6.2 Millionen (leicht und Power) mit Plus, 800’000 Agenten über die API | 2’140 | rund 37 |
| Wie zuvor, die Agenten mit Pro-Abo | 2’290 | rund 40 |
| Dieselbe Menge über die API von GPT-6.1 Sol | 1’750 | rund 31 |
Ein Abo ändert die Grössenordnung also nicht. Pro Nutzer und Monat kostet Plus CHF 20, der Eigenbetrieb CHF 0.68. Wer zahlt, ist ein anderer Punkt: Bei einem Abo trägt die Nutzerin die Kosten selbst, und leichte Nutzer zahlen für Spielraum, den sie nicht brauchen. Die Abos haben ausserdem Grenzen, die OpenAI nicht als Tokenmenge nennt. Ob Plus ein Power-Profil mit 1.5 Millionen Eingabe-Tokens pro Tag trägt, wissen wir nicht, und die Agenten sind in der Praxis Programme in Produkten, die über die API laufen. Auch nicht alle 7 Millionen Nutzer haben ein Abo, viele nutzen die Gratisversion.
Was im Land bleibt
Von den 57 Millionen Franken bleiben 35 im Land: Personal für rund 130 Vollzeitstellen, Strom, Rechenzentrumsfläche und die Anpassung des Modells. 22 Millionen gehen als Abschreibung der Hardware ins Ausland. Damit bleiben 61 Prozent der Kosten im Land. Bei einem Betrieb für 1 Million Nutzer liegt der Anteil bei 79 Prozent: Das Personal wiegt bei einem kleinen Betrieb schwerer, die Hardware macht einen kleineren Teil der Kosten aus. Ob das Geld, das nicht abfliesst, gespart oder anders ausgegeben würde, entscheiden die Nutzer. Aus der Rechnung folgt nur, dass es nicht an einen ausländischen Anbieter fliesst.
Was der Vergleich nicht zeigt
- Bei Listenpreisen von GPT-6.1 Sol würde die Schweiz nicht dieselbe Menge verbrauchen: Viele Agenten-Anwendungen rechneten sich nicht. Der Vergleich stellt gleiche Mengen und ist keine Prognose der Ausgaben.
- Grosskunden verhandeln Rabatte. Der Listenpreis ist die Obergrenze.
- Selbstkosten sind keine Preise. Ein Dienst für Unternehmen bräuchte Aufschläge für Vertrieb, Support und Risiko, die in den 57 Millionen nicht stecken.
- Modellstärke und Antwortqualität haben wir nicht verglichen. Auch die Tokenmenge ist nicht eins zu eins vergleichbar: Tokenizer unterscheiden sich, und Denk-Tokens werden bei GPT als Ausgabe verrechnet. Dieselbe Tokenmenge ist deshalb nicht dieselbe Arbeit.
- Die Abo-Rechnung geht davon aus, dass ein Plus-Abo die Menge des Power-Profils und ein Pro-Abo die des Agenten-Profils abdeckt. OpenAI nennt dafür keine Tokenlimits. Die Abopreise sind Preise von OpenAI, die Selbstkosten sind keine.
- Die Preise von GPT-6.1 Sol und Claude Haiku 5.5 stammen aus Sekundärquellen und sind nicht auf den Preisseiten der Anbieter geprüft (Stand Oktober 2026).[16, 19]
Was das für Schweizer Unternehmen im internationalen Wettbewerb heisst
Die folgende Einschätzung stützt sich auf Zahlen aus der Rechnung. Sie setzt voraus, dass ein nationaler Betrieb seine Leistung zu den Selbstkosten anbietet. Ein solches Angebot gibt es nicht, und mit Aufschlägen läge der Preis höher.
Bei normaler Büroarbeit sind Tokens eine kleine Position. Ein Mitarbeiter im Power-Profil kostet bei GPT-6.1 Sol zum Listenpreis rund CHF 263 im Jahr (250 Arbeitstage), zu den Selbstkosten des nationalen Betriebs (den Kosten ohne Aufschläge) rund CHF 5. Ein Agent (10 Millionen Tokens pro Tag, 96 Prozent Cache-Treffer) kostet zum Listenpreis rund CHF 559 im Jahr, zu den Selbstkosten rund CHF 32. Zum Vergleich: In der Rechnung kostet eine Vollzeitstelle CHF 200’000. Entscheidend sind fünf Dinge:
- Preis, wo Tokens Produktkosten sind. Bei einem Agenten ist der Listenpreis 17-mal so hoch wie die Selbstkosten. Das wirkt erst bei grossen Mengen: 1’000 Agenten kosten zum Listenpreis 0.56 Millionen Franken im Jahr, zu Selbstkosten 0.03 Millionen. Wer Agenten oder Massenverarbeitung in ein Produkt einbaut, hat damit einen Kostenvorteil, den ein Wettbewerber ohne Zugang zum Selbstkostenpreis nicht hat.
- Tempo bei der Einführung. Günstige KI senkt die Hürde, Prozesse und Produkte von Grund auf mit KI zu denken («AI first»). Weil der Betrieb vollständig in der Schweiz läuft und vertrauenswürdig ist, könnten auch Branchen mit hohen Anforderungen wie Banken KI schnell einführen, ohne zuerst die Frage nach dem ausländischen Anbieter zu klären.
- Daten. Bei einem Betrieb in der Schweiz dürfen Daten ins Modell, die bei einem ausländischen Anbieter an Grenzen stossen (keine Rechtsberatung), etwa Berufsgeheimnisse, Gesundheitsdaten und Geschäftsgeheimnisse. Das erweitert, was ein Unternehmen mit KI tun darf, und dürfte für Banken, Kanzleien, Spitäler und die Industrie mehr zählen als der Tokenpreis. Der Vorteil gilt allerdings für jeden Betrieb in der Schweiz, auch für private Schweizer Hoster. Ein öffentlicher Dienst schafft ihn nicht allein.
- Wertschöpfung im Land. Mit der KI-Nutzung wachsen auch die Technologiekosten der Unternehmen, vor allem für Tokens. Bei einem ausländischen Anbieter sind sie eine Abgabe an einen US-Konzern. Beim Betrieb in der Schweiz werden sie zu Löhnen, Aufträgen und Gewinnen im Land, die sich hier versteuern lassen. Das gilt für jeden Betrieb in der Schweiz. Ein öffentlicher Dienst zum Selbstkostenpreis erzeugt selbst keinen Gewinn, aber Löhne und Aufträge.
- Verlässlichkeit. Bei der Software ist ein Schweizer Betrieb von den Preislisten und Lieferbedingungen eines Modellanbieters unabhängig. Bei der Hardware bleibt die Abhängigkeit von NVIDIA und den US-Exportregeln.[22, 23]
Gegenüber ausländischen Konkurrenten, die zum Listenpreis bei einem Anbieter der Spitzenklasse kaufen, hätten Schweizer Unternehmen mit Zugang zum Selbstkostenpreis einen Kostenvorteil. Gegenüber solchen, die ein Modell derselben Stufe über eine günstige API nutzen (Claude Haiku 5.5 oder DeepSeeks API, beide rund 104 Millionen für dieselbe Menge), ist der Kostenvorteil deutlich kleiner: Der nationale Betrieb ist dann noch rund 45 Prozent günstiger. Der grössere Vorteil läge dann bei Daten und Verlässlichkeit.
Wie sicher die Zahlen sind
Die Rechnung beruht auf Annahmen, etwa zu Hardwarepreisen, Strompreis und Durchsatz. Um zu sehen, wie stark das Ergebnis von ihnen abhängt, haben wir jede Annahme einzeln verändert. Die Kosten liegen dann zwischen rund 42 und 83 Millionen Franken im Jahr. Kommen mehrere ungünstige Annahmen zusammen, sind es bis zu 97 Millionen, das sind CHF 5 bis 11 pro Einwohner. Der Strompreis verschiebt das Ergebnis um knapp 1 Million, der Hardwarepreis um etwa 6 Millionen, die Modell-Anpassung um minus 2 bis plus 4 Millionen. Stärker wirken drei Annahmen:
- Durchsatz des Betreibers: Das ist die Menge an Tokens, die eine GPU verarbeitet. Erreicht ein Schweizer Team nur die Hälfte von DeepSeeks Durchsatz pro GPU, steigen die Kosten um 26 Millionen.
- Verbrauch der schweren Nutzer: Brauchen Agenten 30 statt 10 Millionen Tokens pro Tag, steigen die Kosten um 17 Millionen.
- Bürospitze: Das ist der Verkehr zu Bürozeiten, für den die Anlage ausgelegt sein muss. Ohne sie sinken die Kosten um 15 Millionen.
Die Bürospitze kostet rund 15 Millionen Franken im Jahr (57 gegenüber 42 bei gleichmässiger Last), weil die installierte Leistung im Mittel nur zu rund einem Drittel ausgelastet ist. DeepSeek gleicht die schwache Auslastung mit weltweitem Verkehr und mit halbierten Preisen ausserhalb der Spitzenzeit.[1, 5] Ein Schweizer Dienst könnte die Nacht mit zeitunkritischen Aufträgen füllen: Massenverarbeitung von Dokumenten für die Verwaltung, Forschungsaufträge, Evaluationsläufe und Kapazität für Schweizer Unternehmen zum Selbstkostenpreis. Ob sich die Nachtkapazität für Fine-Tuning von Apertus eignet, haben wir nicht geprüft.
Selbst rechnen
Im Rechner verteilen Sie die 9.1 Millionen Einwohner auf vier Gruppen (Nutzen KI nicht, leichte Nutzer, Power-Nutzer, Agenten), die zusammen immer die ganze Bevölkerung ergeben. Darunter stehen die Annahmen als echte Werte, zum Beispiel der Durchsatz pro GPU in Tokens pro Sekunde, der GPU-Preis in US-Dollar oder die Modell-Anpassung in Millionen Franken. Sie können jeden Wert durch Ihren eigenen ersetzen und mit einem Klick auf die Standardannahmen zurückgehen. Ein zweiter Regler legt fest, über wie viele Jahre die Hardware verteilt wird. Das Ergebnis besteht aus drei Zahlen: den Kosten für den Kauf der Hardware, den laufenden Kosten des Betriebs pro Jahr und den Kosten pro aktivem Nutzer und Monat. Der Vergleich mit dem Ausland rechnet dieselbe Tokenmenge pro Jahr zu den Listenpreisen von GPT-6.1 Sol und zum Nebenzeit-Preis von DeepSeeks API. Die drei Voreinstellungen entsprechen den Stufen des Fahrplans im Beitrag «Öffentliche KI für die Schweiz»: 1 Million Nutzer (Verwaltung, Schulen, Hochschulen), 5 Millionen (alle, die KI schon nutzen) und 7 Millionen (Basisfall). Bei 1 Million Nutzern ist der Eigenbetrieb nicht billiger als DeepSeeks API, weil bei dieser Grösse mehr als die Hälfte der Kosten auf das Personal entfällt. Wo zwischen 1 und 5 Millionen Nutzern die Schwelle liegt, haben wir nicht gerechnet.
Was wir nicht prüfen konnten
-
DeepSeeks Beitrag nennt die Hardware nicht, auf der die Durchsatzzahlen entstanden.[1] Stammen sie von älteren Chips, leistet die B300 mehr als hier angenommen. Stammen sie von einem Team, das sein Modell besser kennt als jedes andere, wird ein neuer Schweizer Betreiber zuerst schlechter abschneiden. Beide Möglichkeiten sind in der Tabelle der getesteten Annahmen aufgeführt.
-
Wie viel die Schweiz heute für Tokens ins Ausland zahlt, wissen wir nicht.
-
Die Index-Werte von Artificial Analysis, mit denen wir die Stärke der Modelle vergleichen, haben wir nicht eigenständig geprüft.[3]
-
Für Claude Haiku 5.5 gilt in der Rechnung der Preis bis 100’000 Tokens pro Anfrage. Darüber gilt ein höherer Preis, die Zahl liegt also zu tief.[19, 20]
-
Wir haben angenommen, dass OpenAI bei diesen Profilen dieselben Cache-Trefferquoten erreicht wie DeepSeek.
-
DeepInfer ist seit dem 20. Oktober öffentlich. Wie ausgereift es ausserhalb von DeepSeeks eigener Infrastruktur ist, wissen wir nicht.
-
Die Nutzerprofile und die Grösse der drei Fälle (1, 5 und 7 Millionen Nutzer) sind Annahmen, gestützt auf Umfragedaten. Der tatsächliche Tokenverbrauch pro Person, besonders bei Agenten, kann um den Faktor drei oder mehr abweichen.
-
Die Kosten der Modell-Anpassung sind eine Schätzung aus Aufwand und Preisannahmen. Weder Perplexity noch jemand sonst hat für ein solches Projekt Kosten veröffentlicht. Wie stark die Anpassung die Leistung des Modells verändert, ist offen.
-
Der Spitzenfaktor (das Verhältnis von Spitzenlast zu Durchschnittslast) gilt in der Rechnung für den gesamten Verkehr, auch für Agenten, die nicht an Bürozeiten gebunden sind. Für diese Annahme gibt es bei den 800’000 Agenten-Nutzern im Basisfall keine Quelle. Auch die Kosten eines zweiten Standorts und eines Pilot-Betriebs sind nicht hergeleitet.
-
Anlagekosten, Personalzahlen und Spitzenfaktor sind Schätzungen. Ausschreibungspreise und im Pilot gemessener Verkehr sollten sie ersetzen.
-
Die Angaben zur Interpellation, zu den Modelldaten von V4.1 Flash, zu den Exportregeln, zu Alps und zu den Strompreisen stammen aus den unten genannten Quellen.[23, 24, 26–29] Wir haben sie nicht einzeln gegen die Originaldokumente geprüft.
Was Sie daraus mitnehmen
Die Rechnung liefert für die Politik einen Massstab: Eine öffentliche KI mit 7 Millionen Nutzern kostet in der Grössenordnung von 57 Millionen Franken im Jahr (Spanne 42 bis 97 Millionen). Das sind rund 45 Prozent weniger, als dieselbe Nutzung bei einem gleich starken Modell über eine ausländische API kosten würde. Was daraus für Trägerschaft, Finanzierung und Abhängigkeit folgt, steht im Beitrag Öffentliche KI für die Schweiz.
Für Unternehmen und Hoster ergibt sich daraus ein Richtwert: Bei 5 bis 7 Millionen Nutzern kostet ein Token im Eigenbetrieb 28 bis 66 Prozent des API-Listenpreises von DeepSeek.[5] Ein Schweizer Hoster, der deutlich mehr als diesen Wert verlangt, sollte den Aufpreis begründen können: mit tieferer Auslastung, höherem Spitzenfaktor oder höheren Personalkosten. Für ein einzelnes Unternehmen gilt dieser Richtwert nicht unverändert, denn kleine Betreiber lasten ihre GPUs weniger aus. Die Zahlen sind ein Massstab für Rückfragen, keine Offerte.
Für die Geschäftsleitung
Dieses Dossier als PDF
Den vollständigen Beitrag plus eine kompakte Management-Zusammenfassung und Checkliste, als PDF zum Speichern und Weiterleiten.
Sie erhalten das PDF sofort. Mit dem Absenden stimmen Sie zu, dass Souverana Sie zu diesem Thema kontaktieren darf. Verarbeitung in der Schweiz/EU, keine Weitergabe an Dritte, Widerruf jederzeit (revDSG).
Diesen Beitrag teilen
Fertig formatierte Grafiken und ein Textvorschlag für Ihren LinkedIn-Post: herunterladen, kopieren, posten.
Textvorschlag
Was kostet es, wenn 7 Millionen Menschen in der Schweiz eine öffentliche KI nutzen? Wir haben es mit den Betriebszahlen durchgerechnet, die DeepSeek am 20. Oktober 2026 für V4.1 Flash veröffentlicht hat.

Im Basisfall braucht der Betrieb rund 1'300 GPUs und kostet 57 Millionen Franken im Jahr (Modellrechnung), davon bleiben 35 Millionen im Land. Dieselbe Tokenmenge kostet bei einem Modell derselben Leistungsklasse rund 104 Millionen, bei GPT-6.1 Sol zum Listenpreis 1.75 Milliarden. Unser Schluss: Der Eigenbetrieb ist gegenüber gleich starken Modellen rund 45 Prozent günstiger, der grössere Gewinn liegt bei Daten, Verfügbarkeit und Arbeit im Land.

Im Beitrag: die Nachfrage pro Nutzerprofil, die Hardware-Bemessung, die Sensitivität der Annahmen (42 bis 97 Millionen) und ein Rechner, in dem Sie jede Annahme selbst verändern. Link in den Kommentaren.

#KI #Schweiz #Infrastruktur #DeepSeek #Datensouveränität