Apertus: das Schweizer Sprachmodell und wie es gebaut wurde
Bei Llama 4, Qwen3 und Gemma 3 bleibt unklar, womit sie trainiert wurden. Beim Schweizer Modell Apertus ist es veröffentlicht, samt dem, was der Verzicht auf Daten mit unklarer Lizenz an Leistung kostet. Dazu zehn Fragen an jeden Modellanbieter.
Analyse · Veröffentlicht 14.10.2026 · Aktualisiert 21.10.2026 · Joel Barmettler
Was ist Apertus?
Beim Schweizer Sprachmodell Apertus (ETH Zürich, EPFL, CSCS) können Sie nachprüfen, womit es trainiert wurde. Von fünf verglichenen offenen Modellen geht das nur noch bei OLMo 3. Der Preis: Bei Mathematik und Code liegt Apertus hinter OLMo 3, und der Verzicht auf Daten mit unklarer Lizenz kostete im Versuch 5.8 Prozent Leistung.
Das Wichtigste in Kürze
- Lesen Sie Ranglisten mit Vorsicht. Das Team hat bewusst auf Daten mit unklarer oder nicht kommerzieller Lizenz verzichtet und gemessen, was das kostet: im Schnitt 5.8 Prozent Leistung (Versuch mit Apertus 8B im Fine-Tuning, Tech Report 1.0).
- Wenn Sie belegen müssen, womit ein Modell trainiert wurde, geht das bei Apertus und OLMo 3: Trainingsdaten, Pipeline und Zwischenstände sind öffentlich. Llama 4, Qwen3 und Gemma 3 legen nur die Gewichte offen (Stand: Modellkarten, Oktober 2026).
- Testen Sie Fachanwendungen an eigenen Fällen. In einer Studie des Teams mit Modellen von 1.5 Milliarden Parametern kosteten die Opt-outs beim Allgemeinwissen fast nichts, bei biomedizinischen Aufgaben dagegen messbar Leistung.
- Wer Apertus selbst betreibt, braucht einen eigenen Schutz für Personendaten in den Antworten. Vor dem Training werden nur E-Mail-Adressen, IP-Adressen und IBAN-Nummern ersetzt, und einen Filter für die Ausgaben hat das Modell laut Modellkarte nicht.
- Verlangen Sie von jedem Modellanbieter die Zusammenfassung der Trainingsdaten, die der EU AI Act vorschreibt. Die Zusammenfassung von Apertus erhielt im März 2026 bei einer Prüfung durch Forschende des Trinity College Dublin und der Mozilla Foundation die Bestnote. Von OpenAI, Google und xAI lag damals keine vor.
Zwei Tage nach der Veröffentlichung im September 2025 titelte der Blog clickomania: «So wird das nichts mit dem Schweizer ChatGPT-Killer».[1] Die NZZ schrieb im März 2026: «Nett, aber nicht praxistauglich».[2] Im Oktober 2026 fragte SRF, warum Apertus der kommerziellen Konkurrenz hinterherhinkt.[3] Alle drei messen ein Forschungsprojekt an fertigen Produkten.
Dieser Beitrag liest Apertus anders: als die Fähigkeit der Schweiz, grosse Sprachmodelle selbst zu trainieren, und als Reihe dokumentierter Entscheidungen darüber, welche Daten ein Modell rechtmässig lernen darf. Er eröffnet unsere dreiteilige Serie «Apertus verstehen».
Die Modellfamilie von 1.0 bis 2.0
| Version | Erschienen | Grössen | Was neu ist |
|---|---|---|---|
| 1.0 | 2. September 2025 | 8B, 70B | 15 Billionen Tokens Training, Kontext 65’536 Tokens[4] |
| Mini (1.1) | Mai und Juni 2026 | 0.5B, 1.5B, 4B | aus dem 8B destilliert, 16 Modelle inklusive Quantisierungen für Endgeräte[5] |
| 1.5 | 24. Juli 2026 | 8B, 70B | Bilder als Eingabe, Audio experimentell, Denkmodus, Kontext 262’144 Tokens[6] |
| 2.0 | geplant Q1 2027 | «eine Grössenordnung grösser» | laut Roadmap unter anderem ein gerechteres Vokabular für alle Sprachen |
«8B» steht für 8 Milliarden Parameter. Version 1.5 setzt das Training der Version 1.0 fort, mit rund 4 Billionen zusätzlichen Tokens beim 8B und 2 Billionen beim 70B.[6] Seither ist Apertus multimodal: Es liest Bilder, antwortet aber nur in Text. Das erste Quartal 2027 für Version 2.0 nennt das Team ausdrücklich einen Zielwert, der sich verschieben kann.
Labor: was die Schweiz mit Apertus aufgebaut hat
Die Fähigkeit, selbst zu trainieren. Das Training des 70B-Modells verteilte das Team auf bis zu 4’096 Grafikprozessoren des Supercomputers Alps im CSCS.[4]
Kennzahl
80 %Quelle: CSCS, An Engineering Journey Training Large Language Models at Scale on Alps, arXiv:2604.12973, April 2026; Tech Report Apertus 1.0
Woran es dabei hakte, beschreibt das CSCS in einem eigenen Bericht: an Engpässen beim Speicher und an der Stabilität der Verbindungen zwischen den Rechnern.[7] Am Bericht zu Apertus 1.0 stehen 103 Namen, am Bericht zu Version 1.5 sind es 138 aus acht Institutionen.[4, 6]
Gewichte, auf denen andere bauen. Weil das 8B-Modell bereits existierte, war die Familie Apertus Mini günstig. Ein Team um Martin Jaggi (EPFL) und Dan Alistarh (IST Austria) hat daraus per Destillation Modelle mit 0.5, 1.5 und 4 Milliarden Parametern abgeleitet. Die ganze Familie brauchte weniger als 12 Prozent des Rechenaufwands, den das 8B-Modell im Pretraining gekostet hatte.[5]
Eine schmale Basis. An der ersten Version arbeiteten laut SRF «lediglich zwei Leute Vollzeit, unterstützt von ein paar Dutzend Forschenden».[3] Wer das Projekt bezahlt und was die Schweiz damit politisch kauft, untersucht der zweite Teil der Serie.
Was bei Apertus offenliegt und bei anderen nicht
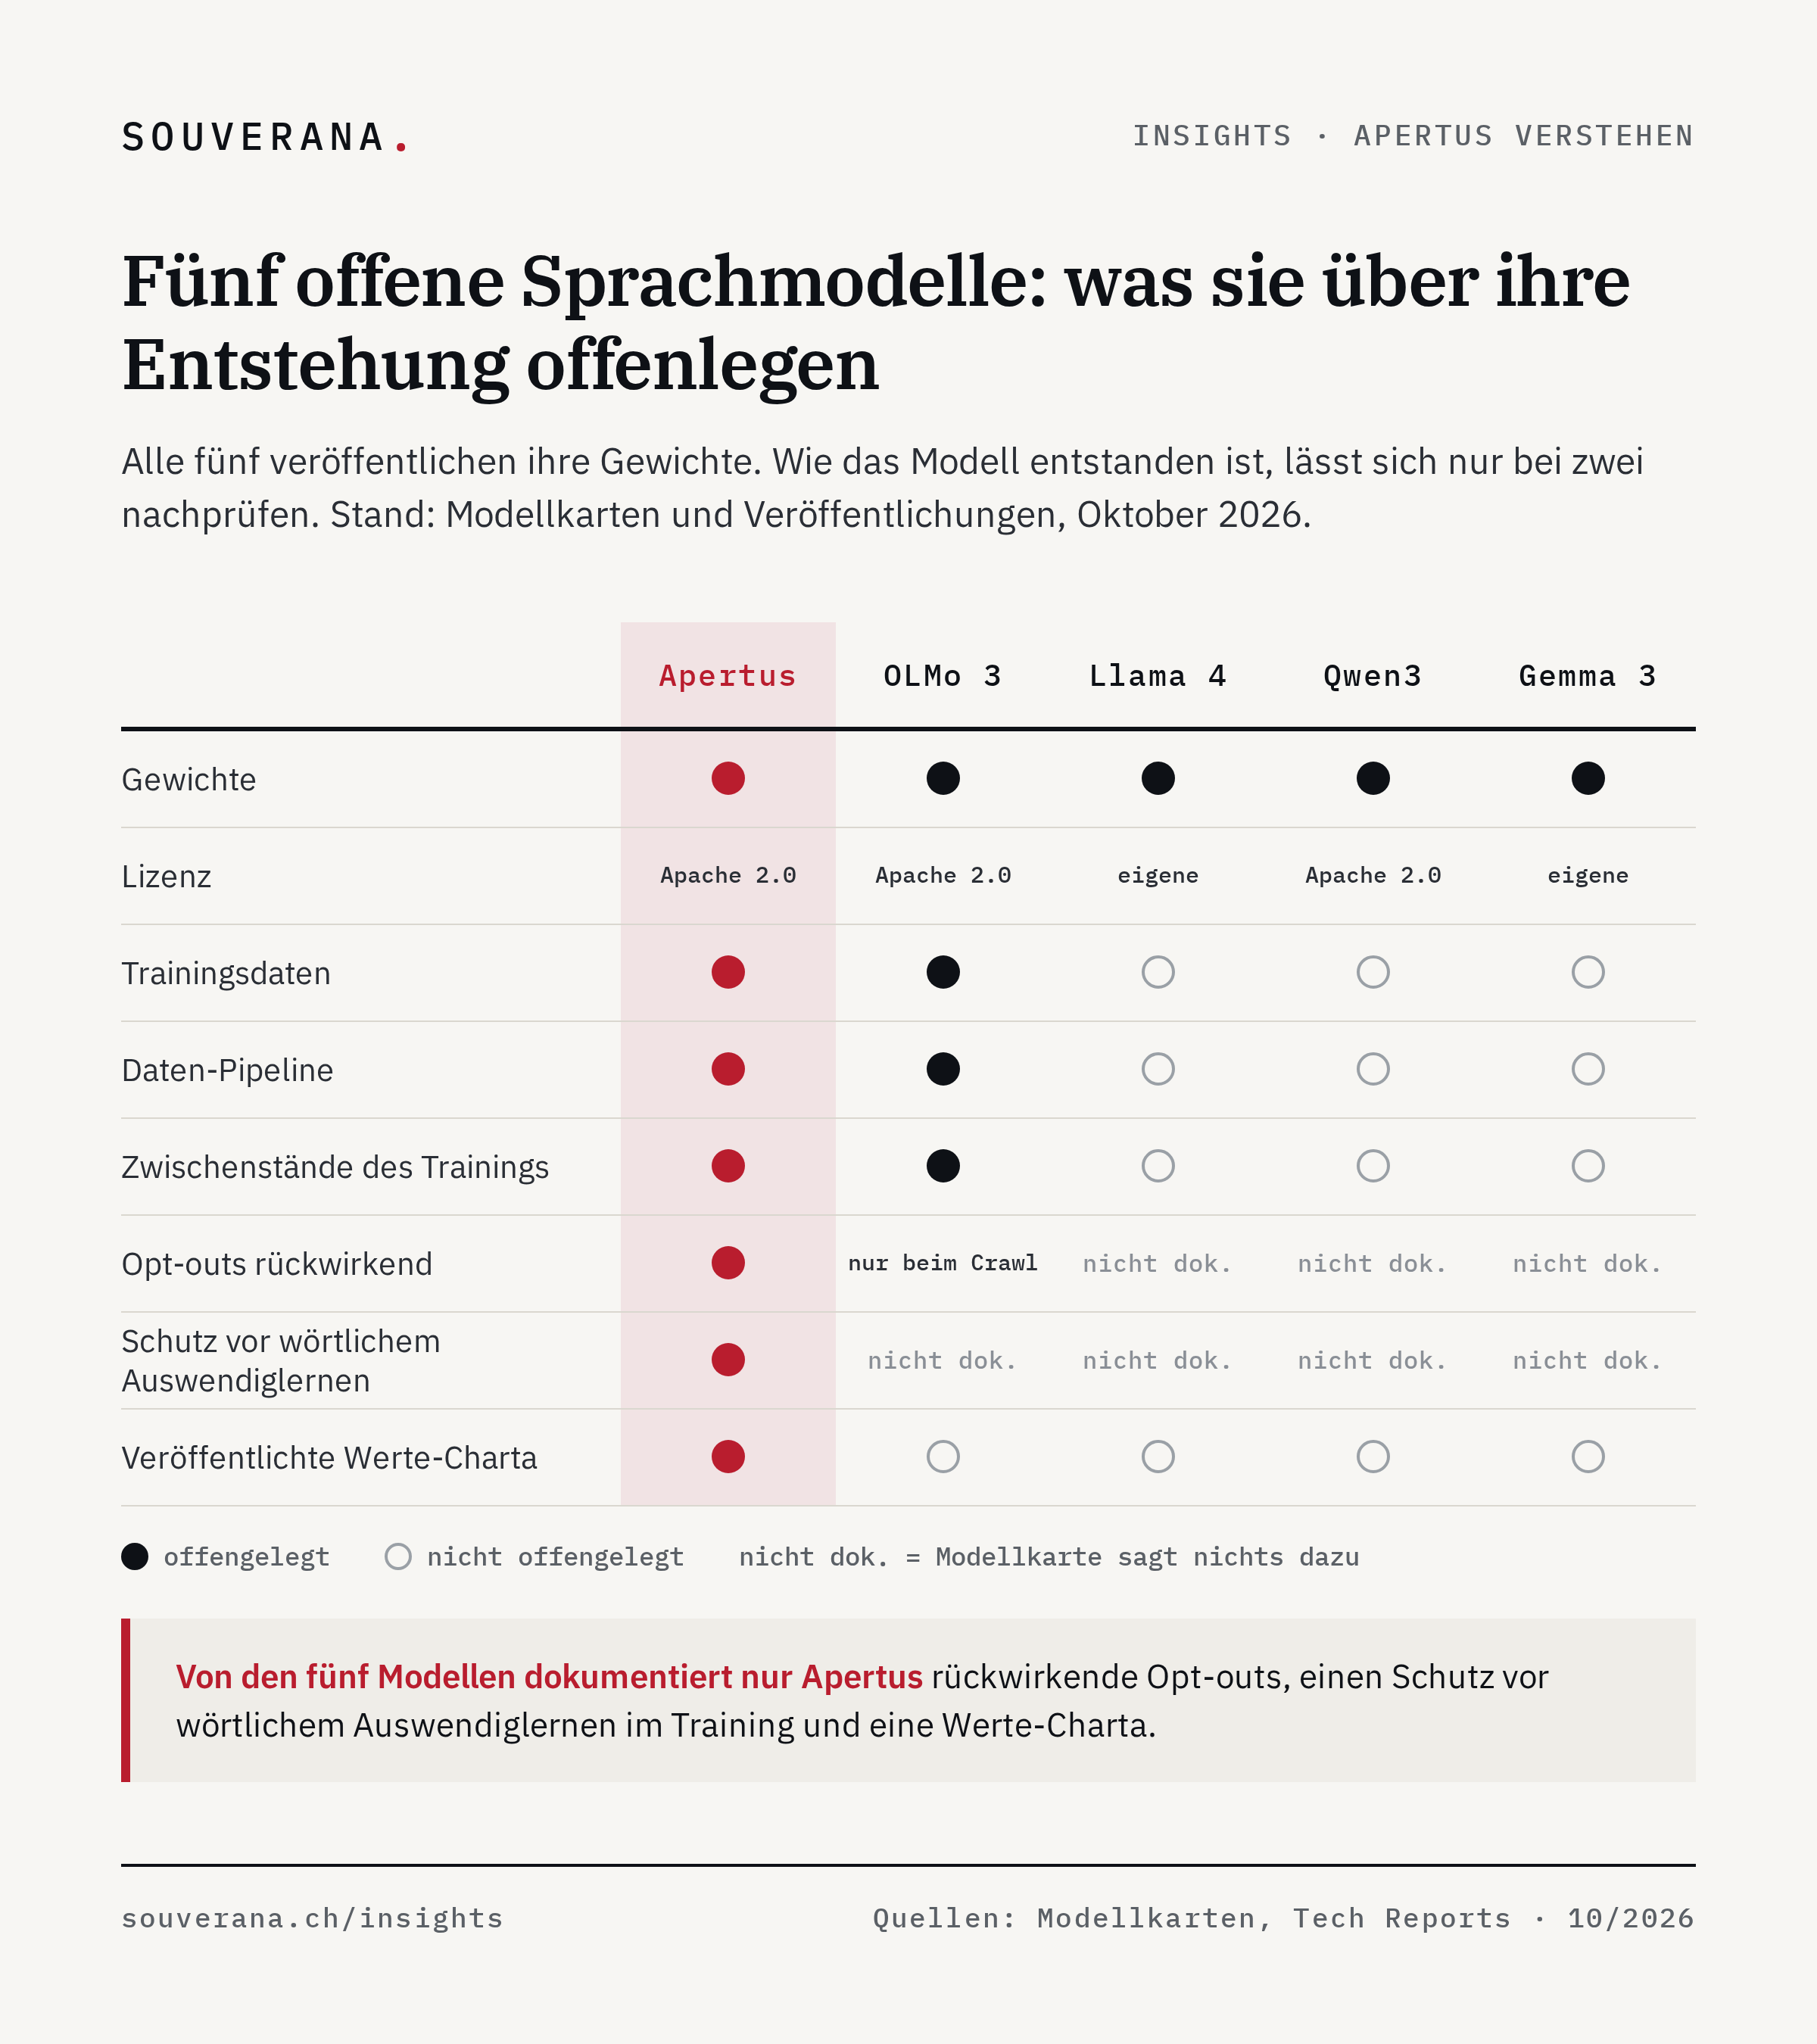
Bei Sprachmodellen steht «offen» für zwei verschiedene Dinge. Offene Gewichte heisst: Sie dürfen das fertige Modell herunterladen und betreiben. Open Source heisst zusätzlich, dass nachvollziehbar ist, wie das Modell entstanden ist. Warum dieser Unterschied für die Souveränität eines Unternehmens zählt, steht in unserer Serie zu souveräner KI.
| Offengelegt | Apertus | OLMo 3 | Llama 4 | Qwen3 | Gemma 3 |
|---|---|---|---|---|---|
| Gewichte | ja | ja | ja | ja | ja |
| Lizenz | Apache 2.0 | Apache 2.0 | eigene | Apache 2.0 | eigene |
| Trainingsdaten | ja[4] | ja[8] | nein | nein | nein[9] |
| Daten-Pipeline | ja | ja | nein | nein | nein |
| Zwischenstände des Trainings | ja | ja | nein | nein | nein |
| Rückwirkende Opt-outs | ja | nur beim Crawl | nicht dokumentiert | nicht dokumentiert | nicht dokumentiert |
| Schutz vor wörtlichem Auswendiglernen | ja | nicht dokumentiert | nicht dokumentiert | nicht dokumentiert | nicht dokumentiert |
| Werte-Charta | ja[10] | nein | nein | nein | nein |
«Nicht dokumentiert» heisst: Modellkarte und Veröffentlichung sagen nichts dazu. Ob es den Schutz gibt, bleibt offen.[11]
Bei Llama, Qwen und Gemma muss man dem Hersteller glauben, welche Daten im Training waren. Meta beschreibt sie in der Modellkarte von Llama 4 als «publicly available, licensed data and information from Meta’s products and services».[11] Bei Apertus und OLMo lässt sich das über die veröffentlichte Pipeline nachvollziehen.[4, 8] Wie die rückwirkenden Opt-outs und der Schutz vor wörtlichem Auswendiglernen funktionieren, beschreibt der nächste Abschnitt.
Labor: welche Daten ins Training durften
Sperren auch rückwirkend beachtet. In einer Datei namens robots.txt legt eine Website fest, welche Crawler ihre Seiten lesen dürfen. Viele Websites sperren inzwischen die Crawler von KI-Firmen, etwa GPTBot von OpenAI oder Google-Extended. Laut Bericht beachten Trainingsdatensätze solche Sperren meist nur im Moment des Crawls. Was vorher gesammelt wurde, bleibt im Datensatz.[4]
Im Januar 2025 hat das Apertus-Team die robots.txt von zwei Millionen Domains abgefragt: der einen Million mit dem meisten englischen Text und der einen Million mit dem meisten Text in anderen Sprachen. Sperrte eine Domain einen KI-Crawler, entfernte das Team ihre Inhalte aus allen Crawls von 2013 bis 2024. Am häufigsten gesperrt war GPTBot. Im englischen Datensatz FineWeb-Edu blieben so von 4.9 Billionen Tokens noch 4.5 Billionen übrig, im mehrsprachigen FineWeb-2 von 47 noch 45 Billionen. Das Team beziffert den Verlust auf rund 8 Prozent der englischen und 4 Prozent der mehrsprachigen Daten.[12]
Ob ein Modell mit weniger Webdaten weniger weiss, haben die drei Projektleiter Martin Jaggi, Antoine Bosselut und Imanol Schlag mit vier weiteren Forschenden untersucht. Den Leistungsunterschied zwischen Training mit und ohne gesperrte Daten nennen sie «Data Compliance Gap». Bei Modellen mit 1.5 Milliarden Parametern lag er beim Allgemeinwissen nahe null. In Fachgebieten wie der biomedizinischen Forschung fehlten die Texte grosser Verlage, und die Werte sanken. Die Studie erschien 2025 an der Konferenz COLM.[12]
Wörtliches Wiedergeben unterdrückt. Sprachmodelle können Trainingstexte auswendig lernen und später wörtlich ausgeben, etwa einen ganzen Zeitungsartikel. Fachleute nennen das Memorisierung. Apertus wurde deshalb mit dem Goldfish-Loss trainiert. Dieses Verfahren blendet beim Lernen 2 Prozent der Tokens aus, bei jeder Wiederholung eines Textes an denselben Stellen. Weil dem Modell diese Stücke fehlen, kann es lange Passagen nicht lückenlos wiedergeben. Laut Bericht wirkt das auch bei grossen Modellen und bei Texten, die 128-mal im Training vorkamen.[4]
Personendaten und toxische Inhalte. Vor dem Training ersetzt eine Mustersuche E-Mail-Adressen, IP-Adressen und IBAN-Nummern durch Platzhalter. Der Bericht nennt das selbst «best-effort». Nach Namen oder Wohnadressen sucht der Filter nicht. In neun Sprachen, darunter Deutsch, Französisch und Italienisch, hat das Team zudem jeweils die 5 Prozent der Dokumente entfernt, die ein Klassifikator als am stärksten beleidigend oder diskriminierend einstufte. Code-, Mathematik- und Bildungsdatensätze blieben von diesem Filter ausgenommen.[4]
Nur klare Lizenzen im Fine-Tuning. Im Fine-Tuning lernt ein Modell, Anweisungen zu befolgen. Dafür liess das Team nur Datensätze zu, deren Lizenz Weitergabe und kommerzielle Nutzung erlaubt, etwa CC-BY oder Apache 2.0. Daten mit nicht kommerzieller Lizenz (NC), mit Share-Alike-Lizenz (SA) oder ohne klare Lizenz fielen weg. Was das kostet, hat das Team in einem Versuch gemessen. Es hat einen Zwischenstand des 8B-Modells nach 10 Billionen Tokens zweimal per Fine-Tuning nachtrainiert: mit der verbreiteten Trainingsmischung Tulu 3 und mit deren lizenzgefilterter Fassung.[4]
Kennzahl
−5.8 %Quelle: Tech Report Apertus 1.0, arXiv:2509.14233, Tabelle 10
| Test | ohne Lizenzfilter | mit Lizenzfilter | Veränderung |
|---|---|---|---|
| Schnitt über 13 Tests | 0.443 | 0.417 | −5.8 % |
| Wissenstest mit Lösungsweg (MMLU-CoT) | 0.513 | 0.253 | −51 % |
| Wissen über die Schweiz (SwitzerlandQA) | 0.590 | 0.579 | −1.9 % |
| Wahrheitstreue der Antworten (TruthfulQA MC2) | 0.486 | 0.518 | +6.6 % |
Über alle mehrsprachigen Tests sank der Schnitt um 4.3 Prozent. Das Team schreibt dazu, es nehme diesen Zielkonflikt in Kauf, «as necessary for responsible open-source model development».[4]
Land: wie eine Schweizer Rechtsauffassung ins Modell kam
Für die rechtliche Grundlage verweist der Bericht auf eine Analyse zum Training mit Inhalten Dritter nach Schweizer Recht. Verfasst haben sie David Rosenthal und Livio Veraldi von der Zürcher Kanzlei VISCHER. Beide sind im Bericht als Berater des Projekts aufgeführt.[4] Die Analyse erschien 2025 in der Fachzeitschrift Jusletter IT.[13]
Die Datenregeln folgen dem Prinzip der Widerspruchslösung. Wer der Nutzung seiner Inhalte widerspricht, wird respektiert, auch nachträglich. Wer nicht widerspricht, gilt als einverstanden: Fehlt eine robots.txt, verwendet das Team die Daten. Abgefragt wurden zudem nur die Domains mit dem meisten Text. Eine kleine Website, die KI-Crawler sperrt, kann deshalb trotzdem im Training gelandet sein. Aus Beratersicht ist der Ansatz dennoch ein Fortschritt. Eine Rechtsauffassung, die sonst in Gutachten steht, lässt sich hier an Code und Daten überprüfen.
In der EU ist die Offenlegung bereits Pflicht. Der EU AI Act verlangt in Art. 53 von Anbietern von Allzweckmodellen eine öffentliche Zusammenfassung ihrer Trainingsdaten nach einer Vorlage der EU-Kommission. Forschende des Trinity College Dublin und der Mozilla Foundation haben im März 2026 für Tech Policy Press fünf veröffentlichte Zusammenfassungen geprüft. Apertus erhielt in allen Kriterien die Bestnote. Von OpenAI, Google und xAI lag damals keine Zusammenfassung vor.[14]
Damit hat eine öffentlich finanzierte Schweizer Institution gezeigt, dass die Transparenzregel der EU erfüllbar ist. Für die Debatte, wie die Schweiz das Training mit fremden Inhalten regeln will, liefert Apertus zudem gemessene Kosten. Darauf können sich Rechteinhaber und Modellbauer gleichermassen beziehen. Diese Einordnung ist keine Rechtsberatung.
Labor, Land, Betrieb: wie die Serie Apertus liest
Jede Entscheidung des Projekts lässt sich auf drei Ebenen lesen. Jeder Teil der Serie geht sie in dieser Reihenfolge durch.
| Ebene | Frage | Beispiel aus diesem Teil |
|---|---|---|
| Labor | Was hat das Team gebaut, erforscht und gemessen? | rückwirkende Opt-outs, Goldfish-Loss, Lizenzfilter mit −5.8 % |
| Land | Was bedeutet das für die Schweiz, politisch und rechtlich? | eine Schweizer Rechtsauffassung zum Training, an Code prüfbar |
| Betrieb | Was heisst das für ein Unternehmen, das KI einsetzt? | Prüffragen an jeden Modellanbieter |
Dieser erste Teil beschreibt, was Apertus ist und wie es gebaut wurde. Der zweite fragt, wer das Projekt finanziert und was es der Schweiz an Unabhängigkeit bringt. Der dritte prüft, für welche Aufgaben sich das Modell im Betrieb eignet, wo es läuft und was es dort kostet.
Was das für Ihr Unternehmen heisst
Aus Beratersicht verändert der Lizenzversuch, wie man Modellvergleiche liest. Modelle, die in Tests besser abschneiden, sind zum Teil deshalb besser, weil sie aus Material gelernt haben, auf das Apertus bewusst verzichtet. Wie gross dieser Anteil bei einem bestimmten Modell ist, lässt sich nur messen, wenn dessen Trainingsdaten offenliegen. Für welche Aufgaben Apertus im Betrieb trotzdem die richtige Wahl ist, prüft der dritte Teil der Serie.
Gibt das Modell trotz der Filter einen Namen oder eine Telefonnummer wieder, muss Ihre eigene Anwendung das abfangen. Löschbegehren von Betroffenen nimmt das Team unter llm-privacy-requests@swiss-ai.org entgegen.[4]
Die Berichte von Apertus taugen auch dann als Messlatte, wenn Sie ein anderes Modell einsetzen. Für ein erstes Gespräch mit einem Anbieter genügen vier Fragen:
- Gibt es eine veröffentlichte Zusammenfassung der Trainingsdaten nach EU AI Act, und wo steht sie?
- Wurden Sperren von Websites beachtet, auch rückwirkend für ältere Crawls?
- Was verhindert, dass das Modell Trainingstexte wörtlich wiedergibt?
- Welche Personendaten wurden vor dem Training entfernt, und filtert jemand die Ausgaben?
Apertus beantwortet alle vier öffentlich. Halten Sie die Antworten des Anbieters schriftlich fest. Zehn Fragen mit den Antworten von Apertus als Vergleich stehen als Arbeitsblatt im PDF.
Quellen
Für die Geschäftsleitung
Dieses Dossier als PDF
Den vollständigen Beitrag plus eine kompakte Management-Zusammenfassung und Checkliste, als PDF zum Speichern und Weiterleiten.
Sie erhalten das PDF sofort. Mit dem Absenden stimmen Sie zu, dass Souverana Sie zu diesem Thema kontaktieren darf. Verarbeitung in der Schweiz/EU, keine Weitergabe an Dritte, Widerruf jederzeit (revDSG).
Häufige Fragen
- Was ist Apertus?
- Apertus ist ein offenes Sprachmodell von ETH Zürich, EPFL und dem Supercomputing-Zentrum CSCS. Version 1.0 erschien am 2. September 2025, Version 1.5 am 24. Juli 2026, jeweils mit 8 und 70 Milliarden Parametern. Die Gewichte stehen unter der Apache-2.0-Lizenz, Daten-Pipelines, Trainingscode und Zwischenstände des Trainings sind öffentlich.
- Ist Apertus Open Source?
- Ja, im strengen Sinn. Neben den Gewichten sind Daten-Pipeline, Trainingscode, Zwischenstände des Trainings und eine Werte-Charta öffentlich. Llama 4, Qwen3 und Gemma 3 veröffentlichen die Gewichte, aber weder Trainingsdaten noch Pipeline. Ähnlich offen wie Apertus ist etwa OLMo 3 vom Allen Institute for AI (Stand Oktober 2026).
- Mit welchen Daten wurde Apertus trainiert?
- Apertus 1.0 lernte aus 15 Billionen Tokens, vor allem aus öffentlichen Web-Datensätzen wie FineWeb und FineWeb-2 sowie aus Code und Mathematik. Inhalte von Websites, die KI-Crawler sperren, wurden auch aus älteren Crawls entfernt. Im Fine-Tuning waren nur Daten mit klarer, kommerziell nutzbarer Lizenz zugelassen. Die Pipeline ist öffentlich.
- Was kostet der Verzicht auf heikle Trainingsdaten an Leistung?
- Die rückwirkenden Opt-outs kosteten rund 8 Prozent der englischen und 4 Prozent der mehrsprachigen Webdaten. Im Fine-Tuning-Versuch mit Apertus 8B senkte der Verzicht auf nicht kommerziell oder unklar lizenzierte Daten den Schnitt über 13 Tests um 5.8 Prozent. Ein Test zur Wahrheitstreue stieg dabei um 6.6 Prozent.
- Erfüllt Apertus die Transparenzpflicht des EU AI Act?
- Laut einer Prüfung von Forschenden des Trinity College Dublin und der Mozilla Foundation vom März 2026 ja. Sie bewerteten fünf veröffentlichte Zusammenfassungen von Trainingsdaten nach Art. 53 EU AI Act. Apertus erhielt in allen Kriterien die Bestnote. Von OpenAI, Google und xAI lag damals keine Zusammenfassung vor.
- Ist Apertus ein Schweizer ChatGPT?
- Nein. Apertus ist ein Foundation Model, auf dem Unternehmen und Verwaltungen eigene Anwendungen bauen. Laut dem Bericht zu Version 1.5 liegt Apertus bei Mathematik und Code hinter dem offenen Modell OLMo 3, beim Befolgen von Anweisungen vor allen verglichenen Modellen.
Diesen Beitrag teilen
Fertig formatierte Grafiken und ein Textvorschlag für Ihren LinkedIn-Post: herunterladen, kopieren, posten.
Textvorschlag
Wissen Sie, womit das Sprachmodell trainiert wurde, das Ihre Firma einsetzt?

Beim Schweizer Modell Apertus von ETH, EPFL und CSCS lässt sich das nachprüfen. Von fünf verglichenen offenen Modellen geht das nur noch bei OLMo 3. Bei Llama 4, Qwen3 und Gemma 3 sind nur die Gewichte offen (Modellkarten, Oktober 2026).

Der Preis dafür steht im Bericht des Teams. Bei Mathematik und Code liegt Apertus hinter OLMo 3 (Bericht zu Version 1.5). Im Bericht zu Version 1.0 steht auch, was das Team beim Training weggelassen hat. Inhalte von Websites, die KI-Crawler sperren, hat es aus allen Crawls seit 2013 entfernt. Das kostete rund 8 Prozent der englischen Webdaten. In einem Versuch mit dem 8B-Modell liess es im Fine-Tuning Daten mit nicht kommerzieller oder unklarer Lizenz weg. Über 13 Tests sank die Leistung dadurch um 5.8 Prozent, in einem Wissenstest mit Lösungsweg um die Hälfte.

Unser Schluss: Ein Teil des Vorsprungs anderer Modelle stammt aus Material, auf das Apertus verzichtet hat. Wer vergleicht, sollte das wissen. Nachprüfen lässt es sich nur, wo Daten und Pipeline offenliegen.

Im Beitrag: die Modellfamilie bis zur geplanten Version 2.0, die rechtliche Grundlage der Zürcher Kanzlei VISCHER, die Prüfung nach EU AI Act durch das Trinity College Dublin und ein Arbeitsblatt mit zehn Fragen an jeden Modellanbieter. Link in den Kommentaren.

#Apertus #KI #Urheberrecht #Schweiz #Datensouveränität