Prompt Caching: Warum Agenten in der Schweiz teurer laufen
Bei jeder Nachricht an ein Sprachmodell wird der ganze bisherige Gesprächsverlauf noch einmal mitgeschickt. Bei langen Gesprächen und KI-Agenten macht das alles langsam und teuer. Manche Anbieter verrechnen den schon verarbeiteten Verlauf bis zu 50-mal günstiger, die von uns geprüften Schweizer Hoster nicht. Wie das funktioniert, erfahren Sie hier.
Analyse · Veröffentlicht 06.10.2026 · Aktualisiert 06.10.2026 · Joel Barmettler
Warum ein KI-Agent bei jedem Schritt alles noch einmal liest
Prompt Caching heisst: Der Anbieter merkt sich, was er schon gelesen hat, und liest es beim nächsten Schritt nicht neu. DeepSeek verlangt dafür bei seinem Modell V4 Flash 2 Prozent des Eingabepreises. Der Schweizer Hoster Phoeniqs führt in seiner Preisliste vom 1. Oktober 2026 keinen Preis für wiederholte Eingaben auf und verrechnet sie voll. Bei einem KI-Agenten, der in jedem Schritt den ganzen Verlauf erneut schickt, macht das in unserem Rechenbeispiel das 17-Fache aus.
Das Wichtigste in Kürze
- Ein KI-Agent ist ein Programm, das eine Aufgabe in vielen Schritten selbstständig abarbeitet, zum Beispiel ein Assistent, der Programmcode schreibt. Bei jedem Schritt schickt er dem Sprachmodell den gesamten bisherigen Verlauf noch einmal mit, dazu nur wenig Neues. In einer Beispielrechnung weiter unten (50 Schritte, am Ende 500’000 Tokens Text) sind 96.5 Prozent der Eingabe Wiederholung. Ein Token ist ein Textstück, meist kürzer als ein Wort.
- Beim Prompt Caching speichert der Anbieter den schon gelesenen Text zwischen. Findet er ihn beim nächsten Schritt wieder (ein Treffer), liest er ihn nicht neu. Bei DeepSeek V4 Flash kostet das 0.0025 statt 0.125 Franken je Million Tokens. Wir rechnen in diesem Beitrag in Franken, mit dem Tarif ausserhalb der Spitzenzeiten und zum Kurs der Europäischen Zentralbank vom 1. Oktober 2026 (1 US-Dollar = 0.8353 Franken).
- Phoeniqs (kvant) ist ein Schweizer Hoster, also ein Anbieter, der offene KI-Modelle auf eigenen Servern betreibt und verkauft, darunter DeepSeek V4 Flash. Seine Preisliste vom 1. Oktober 2026 nennt keinen Preis für wiederholte Eingaben. Sie kosten deshalb den vollen Eingabepreis von 0.1462 Franken je Million Tokens. Ohne Wiederholungen sind beide Anbieter etwa gleich teuer (0.125 gegen 0.146 Franken je Million Eingabe-Tokens). Der Unterschied entsteht durch die Verrechnung der wiederholten Eingaben. Weil bei einem Agenten 96.5 Prozent der Eingabe Wiederholung sind, wird er gross: Dieselbe Beispiel-Session kostet bei Phoeniqs das 17-Fache.
- Den Zwischenspeicher betreibt der Anbieter, der Kunde hat darauf keinen Einfluss. Der Platz ist begrenzt. Wartet ein Agent einige Minuten, etwa auf einen Test oder auf die Freigabe durch einen Menschen, kann sein Text verdrängt sein. Der Anbieter liest ihn beim nächsten Schritt neu und verrechnet den vollen Preis. Der Kunde sieht das nur auf der Rechnung.
Dieser Beitrag ist der zweite Teil unserer Serie zum Einkauf von Inferenz. Der erste Teil zeigte, warum der Preis pro Token wenig über die Rechnung aussagt. Dieser rechnet den grössten Hebel durch.
Was Inferenz ist und worauf es dem Hoster ankommt
Ein Sprachmodell zu trainieren dauert Monate und kostet Millionen. Danach beginnt der Alltag. Jede Frage an ChatGPT, jeder Aufruf eines Coding-Assistenten und jede Antwort eines internen Chatbots ist Inferenz, also die Anwendung des fertigen Modells. Dafür zahlen Kunden pro Token, getrennt nach Eingabe und Ausgabe.
Die meisten Unternehmen kaufen Inferenz bei einem grossen US-Anbieter ein, direkt bei OpenAI, Anthropic oder Google oder über deren Clouds Azure und AWS. Daneben ist eine Branche entstanden, die offene Modelle betreibt und per Schnittstelle verkauft. Fireworks und Together AI sitzen in den USA, Infomaniak, Phoeniqs und Swisscom in der Schweiz.
In diesem Beitrag heisst Kunde, wer ein Sprachmodell über eine Schnittstelle nutzt und pro Token zahlt, also meist Sie als Leser. Hoster oder Anbieter heisst die Firma, die Server und Modell betreibt. Wo wir allgemein eine Firma meinen, etwa DeepSeek oder Anthropic mit dem eigenen Modell, sagen wir Anbieter. Der Kunde kann nur wählen, wen er bezahlt, und auf der Rechnung ablesen, was der Hoster verrechnet.
Hoster trainieren keine Modelle. Sie laden offene Modelle wie Apertus oder
Qwen herunter und betreiben sie auf Servern mit Grafikkarten (GPUs). Was so ein
Server wert ist, zeigt als Richtwert Infomaniaks Preisliste für gemietete Maschinen. Ein Server
mit einer Nvidia A100 (Instanztyp nva100_sxm180g_a128_ram240_disk0) kostet
1’057.91 Franken im Monat, rund 1.45 Franken pro Stunde. Nehmen wir an, ein Hoster
bündelt acht davon, um ein Modell wie Apertus zu betreiben. Dann stehen rund 12
Franken pro Stunde im Raum, die derselbe Server einbrächte, wenn der Hoster ihn
roh vermietete.
Betreibt er stattdessen ein Modell und rechnet pro Token ab, muss er im Schnitt mehr als diese 12 Franken pro Stunde einnehmen. Für den Preis braucht er drei Zahlen. Wie viele Tokens verarbeitet der Server pro Stunde? Wie viele davon sind Eingabe, wie viele Ausgabe? Und wie gut ist er ausgelastet? Daraus folgt der Preis je Million Tokens.
Ein Rechenbeispiel zeigt die Grössenordnung. Phoeniqs verlangt für Apertus 1.5 70B 2.2201 Franken je Million Ausgabe-Tokens und 0.6195 Franken je Million Eingabe-Tokens (Preisliste vom 1. Oktober 2026). Um allein die 12 Franken pro Stunde zu decken, müssten acht A100 in jeder Stunde rund 5.4 Millionen Ausgabe-Tokens liefern, das sind etwa 1’500 Tokens pro Sekunde. Mit Eingabe-Tokens allein wären es rund 19 Millionen pro Stunde, etwa 5’400 pro Sekunde. Das Beispiel nimmt acht A100 an. Wie Phoeniqs sein Modell tatsächlich betreibt, ist nicht öffentlich.
Ein Hoster verdient an der Differenz zwischen dieser Stundenrechnung und seinen Einnahmen je Token. Er muss deshalb in jeder Stunde möglichst viele Tokens aus derselben Maschine herausholen. Die Konkurrenz ist hart. Infomaniak, Swisscom und Phoeniqs bieten alle Apertus an, und nach unserer Einschätzung kostet ein Wechsel zwischen ihnen kaum etwas, weil die Schnittstellen weitgehend gleich sind. Dafür gibt es zwei Hebel, die wir nacheinander erklären: Batching und Caching.
Jede Antwort hat zwei Phasen
Eine Anfrage läuft in zwei Phasen ab, die technisch wenig gemeinsam haben. Zuerst kommt der Prefill. Das Modell liest die gesamte Eingabe in einem einzigen Durchgang. Das ist viel Rechenarbeit, aber gut parallelisierbar, und Grafikkarten sind dafür gebaut. Dann beginnt der Decode. Das Modell schreibt die Antwort Token für Token, und jedes Token hängt vom vorherigen ab. Bei einer einzelnen Anfrage kann die Karte nichts parallel erledigen.
Man kann sich das als Aktenstapel und Diktat vorstellen. Die Akte überblickt man zügig, weil man viele Seiten gleichzeitig sieht. Das Diktat läuft Wort für Wort.
Damit die Grafikkarte die Antwort schreiben kann, muss sie die Eingabe nicht nur lesen, sondern auch behalten. Das Ergebnis des Prefill liegt im KV-Cache, einem Bereich im Grafikspeicher. Je länger die Eingabe, desto mehr Platz belegt sie. Die folgende Grafik zeigt, was auf dem Server passiert, wenn Nutzer Anfragen schicken. Zuerst die Bausteine:
- Nutzer stehen unten und tragen einen Buchstaben. Ein Nutzer kann eine Person im Chat sein oder ein Agent. Er erscheint nur, solange er auf eine Antwort wartet. Im ersten Beispiel gibt es nur Nutzer A, in Rot.
- Anfrage heisst das farbige Kästchen. Es enthält alles, was der Nutzer dem Modell schickt: den bisherigen Verlauf und die neue Nachricht. Die Höhe des Kästchens steht für die Länge dieser Eingabe.
- Antwort sind die Kreise. Jeder Kreis ist ein Token, das die Grafikkarte schreibt.
Der Weg der Anfrage führt über drei Stationen auf dem Server:
- Eingang. Die Anfrage wandert nach links oben und wartet, bis im Speicher Platz ist.
- KV-Cache. Sie rückt in den Speicher der Grafikkarte, der zehn Einheiten hoch ist. Dort wird die Eingabe gelesen, die Anfrage füllt sich dabei mit Farbe. Das ist der Prefill.
- Decode. Danach schreibt die Grafikkarte die Antwort rechts davon, ein Kreis pro Sekunde. Hier sind es fünf Kreise. Sind sie fertig, fliessen sie zurück zum Nutzer, und die Anfrage verlässt den Speicher.
Nutzer A stellt dem Modell vier Fragen nacheinander. Das Modell merkt sich nichts. Mit jeder neuen Anfrage geht deshalb das gesamte bisherige Gespräch noch einmal mit, sonst wäre «Und von Österreich?» nicht zu beantworten. Seine Anfrage wird in jeder Runde um zwei Einheiten höher, denn die letzte Antwort und die neue Frage kommen dazu. Der Server liest sie jedes Mal von vorn. Bei einem Agenten kommen Werkzeugbeschreibungen, Projektregeln und Dateien hinzu, das Prinzip bleibt dasselbe. Spielen Sie die Grafik ab und achten Sie auf die Wartezeit bis zum ersten Kreis:
Die Wartezeit wächst von Runde zu Runde, obwohl die Antwort immer gleich lang ist. Der Grund ist der Prefill: Jede Runde liest zuerst den ganzen, immer längeren Verlauf. Neu ist an jeder Eingabe nur das letzte Stück.
Batching: Warum viele Nutzer die Karte besser auslasten
Beim Decode muss die Grafikkarte für jedes Token die gesamten Modellgewichte aus ihrem Speicher holen, also die Milliarden Zahlenwerte, die das Modell gelernt hat. Das Rechnen dauert kurz, das Warten auf den Speicher lang. Ein Lesevorgang genügt aber für viele Anfragen zugleich: Die Karte holt die Gewichte einmal und schreibt damit für jede laufende Anfrage ein Token. Bedient sie hundert Nutzer gleichzeitig, reicht ein Lesevorgang für alle hundert. Man bündelt die Anfragen wie einen Stapel Aufträge, der in einem Durchgang erledigt wird. Das heisst Batching. Moderne Server nehmen laufend neue Anfragen in den Stapel auf und werfen fertige hinaus.
Je mehr Anfragen im Stapel sind, desto mehr Tokens schafft die Karte pro Sekunde, denn jede laufende Anfrage liefert in jedem Schritt ein Token. Eine volle Karte arbeitet effizient, eine halbleere verschenkt Leistung. Die Grenze setzt der Speicher: Jede laufende Anfrage braucht dort Platz für ihren Text. Viele kurze oder wenige lange Anfragen füllen ihn gleich schnell. Der freie Platz entscheidet, wie viele Anfragen gleichzeitig laufen, und damit, wie gut die Karte ausgelastet ist.
Auch das hat einen Preis. Wartet eine Anfrage, bis Platz frei wird, sieht der Nutzer das erste Wort später (Time to first token, die Wartezeit bis zum ersten Wort der Antwort).
Wie das aussieht, zeigt dieselbe Grafik mit fünf Nutzern. Der Decode schreibt höchstens drei Antworten gleichzeitig (in Wirklichkeit sind es weit mehr, hier bleibt die Zahl klein, damit man sie sieht), und der Prefill liest immer nur eine Anfrage auf einmal. Zwei Grenzen sind zu beobachten. Passt eine Anfrage nicht mehr in den Speicher, wartet sie im Eingang, bis eine andere fertig ist. Bei fünf Nutzern stauen sich dort bis zu drei Anfragen. Passen mehr als drei Anfragen hinein, schreibt die Karte trotzdem nur an dreien, die übrigen warten im Speicher auf einen freien Platz.
Ist der Speicher voll, steigt die Wartezeit bis zum ersten Kreis. Jede Eingabe muss erst gelesen werden, und der Prefill liest jeweils nur eine Anfrage.
Was Prompt Caching ist und was es spart
Die Grafik oben zeigt die Verschwendung: In Runde 2 liest der Server Text, den er in Runde 1 schon einmal gelesen hat. Der Anfang beider Eingaben ist Token für Token gleich, nur das Ende ist neu. Eine Sachbearbeiterin, die vor jedem Telefonat das ganze Dossier von vorn liest und sich keine Notizen macht, arbeitet genauso.
Prompt Caching spart genau diese Wiederholung. Der Anbieter lässt die gelesene Anfrage nach der Antwort im KV-Cache liegen, statt sie zu verwerfen. Beginnt die nächste Anfrage mit denselben Tokens, übernimmt er diesen Teil aus dem Cache und berechnet nur den neuen Rest. Das ist ein Cache-Treffer. Wie lange der Anbieter den Anfang aufbewahrt, heisst Haltedauer. Der Anfang muss Token für Token übereinstimmen. Darum heisst das Verfahren in der Fachsprache auch Prefix-Caching, Präfix steht für Anfang. Schon ein Zeitstempel ganz vorne ergibt einen anderen Anfang, und der Cache greift nicht mehr.
Dieselbe Sitzung noch einmal, jetzt mit Cache. Schalten Sie zwischen den Varianten um. Mit Cache bleibt die Anfrage nach der Antwort mit gepunktetem Rand im Speicher liegen. In der nächsten Runde übernimmt die Grafikkarte den schraffierten Teil und liest nur die neuen Einheiten:
Ohne Cache wächst die Wartezeit von 4 auf 10 Sekunden. Mit Cache bleibt sie bei 4 Sekunden, weil nur die zwei neuen Einheiten gelesen werden, die letzte Antwort und die neue Frage. Das gilt, solange die Anfrage im Speicher liegen bleibt. Wie lange das der Fall ist, kommt weiter unten.
Wie viel das ausmacht, zeigt eine lange Coding-Session. In jeder Runde kommen 9’000 Tokens Eingabe dazu, etwa Werkzeugergebnisse, Dateien und Anweisungen, und das Modell schreibt 1’000 Tokens Antwort. Die Antwort gehört in der nächsten Runde zum Verlauf, der Kontext wächst also um 10’000 Tokens pro Runde. Neu lesen muss der Anbieter davon nur die 9’000 Tokens Eingabe, denn die Antwort hat er beim Schreiben schon verarbeitet. Die erste Grafik zeigt für die ersten fünf Runden die gesamte Eingabe und den Teil davon, den der Anbieter aus dem Cache liest, solange dieser erhalten bleibt:
Coding-Session mit lebendem Cache
- Anfrage 1 9'000 voller Preis
- Anfrage 2 9'000 voller Preis
- Anfrage 3 9'000 voller Preis
- Anfrage 4 9'000 voller Preis
- Anfrage 5 9'000 voller Preis
Zum vollen Preis verarbeitet: 45'000 von 145'000 Tokens (31 %)
Über diese fünf Runden summiert sich die Eingabe auf 145’000 Tokens, von denen der Anbieter nur 45’000 neu berechnen muss. Fällt der Cache nach Runde 2 weg, etwa weil der Agent auf einen Test oder eine Freigabe wartet, sieht dieselbe Session so aus:
Dieselbe Session, Cache nach Runde 2 verfallen
- Anfrage 1 9'000 voller Preis
- Anfrage 2 9'000 voller Preis
- Anfrage 3 29'000 voller PreisPause länger als die Haltedauer, alles neu
- Anfrage 4 9'000 voller Preis
- Anfrage 5 9'000 voller Preis
Zum vollen Preis verarbeitet: 65'000 von 145'000 Tokens (45 %)
Ein einziger Cache-Verlust verteuert die fünf Runden um fast die Hälfte. Der Anbieter muss jetzt 65’000 Tokens zum vollen Preis berechnen, vorher waren es 45’000. Bei 50 Runden wächst der Kontext auf 500’000 Tokens. Die Session verarbeitet dann insgesamt 12’700’000 Eingabe-Tokens. Bei durchgehend lebendem Cache fallen davon nur 450’000 zum vollen Preis an, das sind 3.5 Prozent. Dazu kommen 50’000 Ausgabe-Tokens.
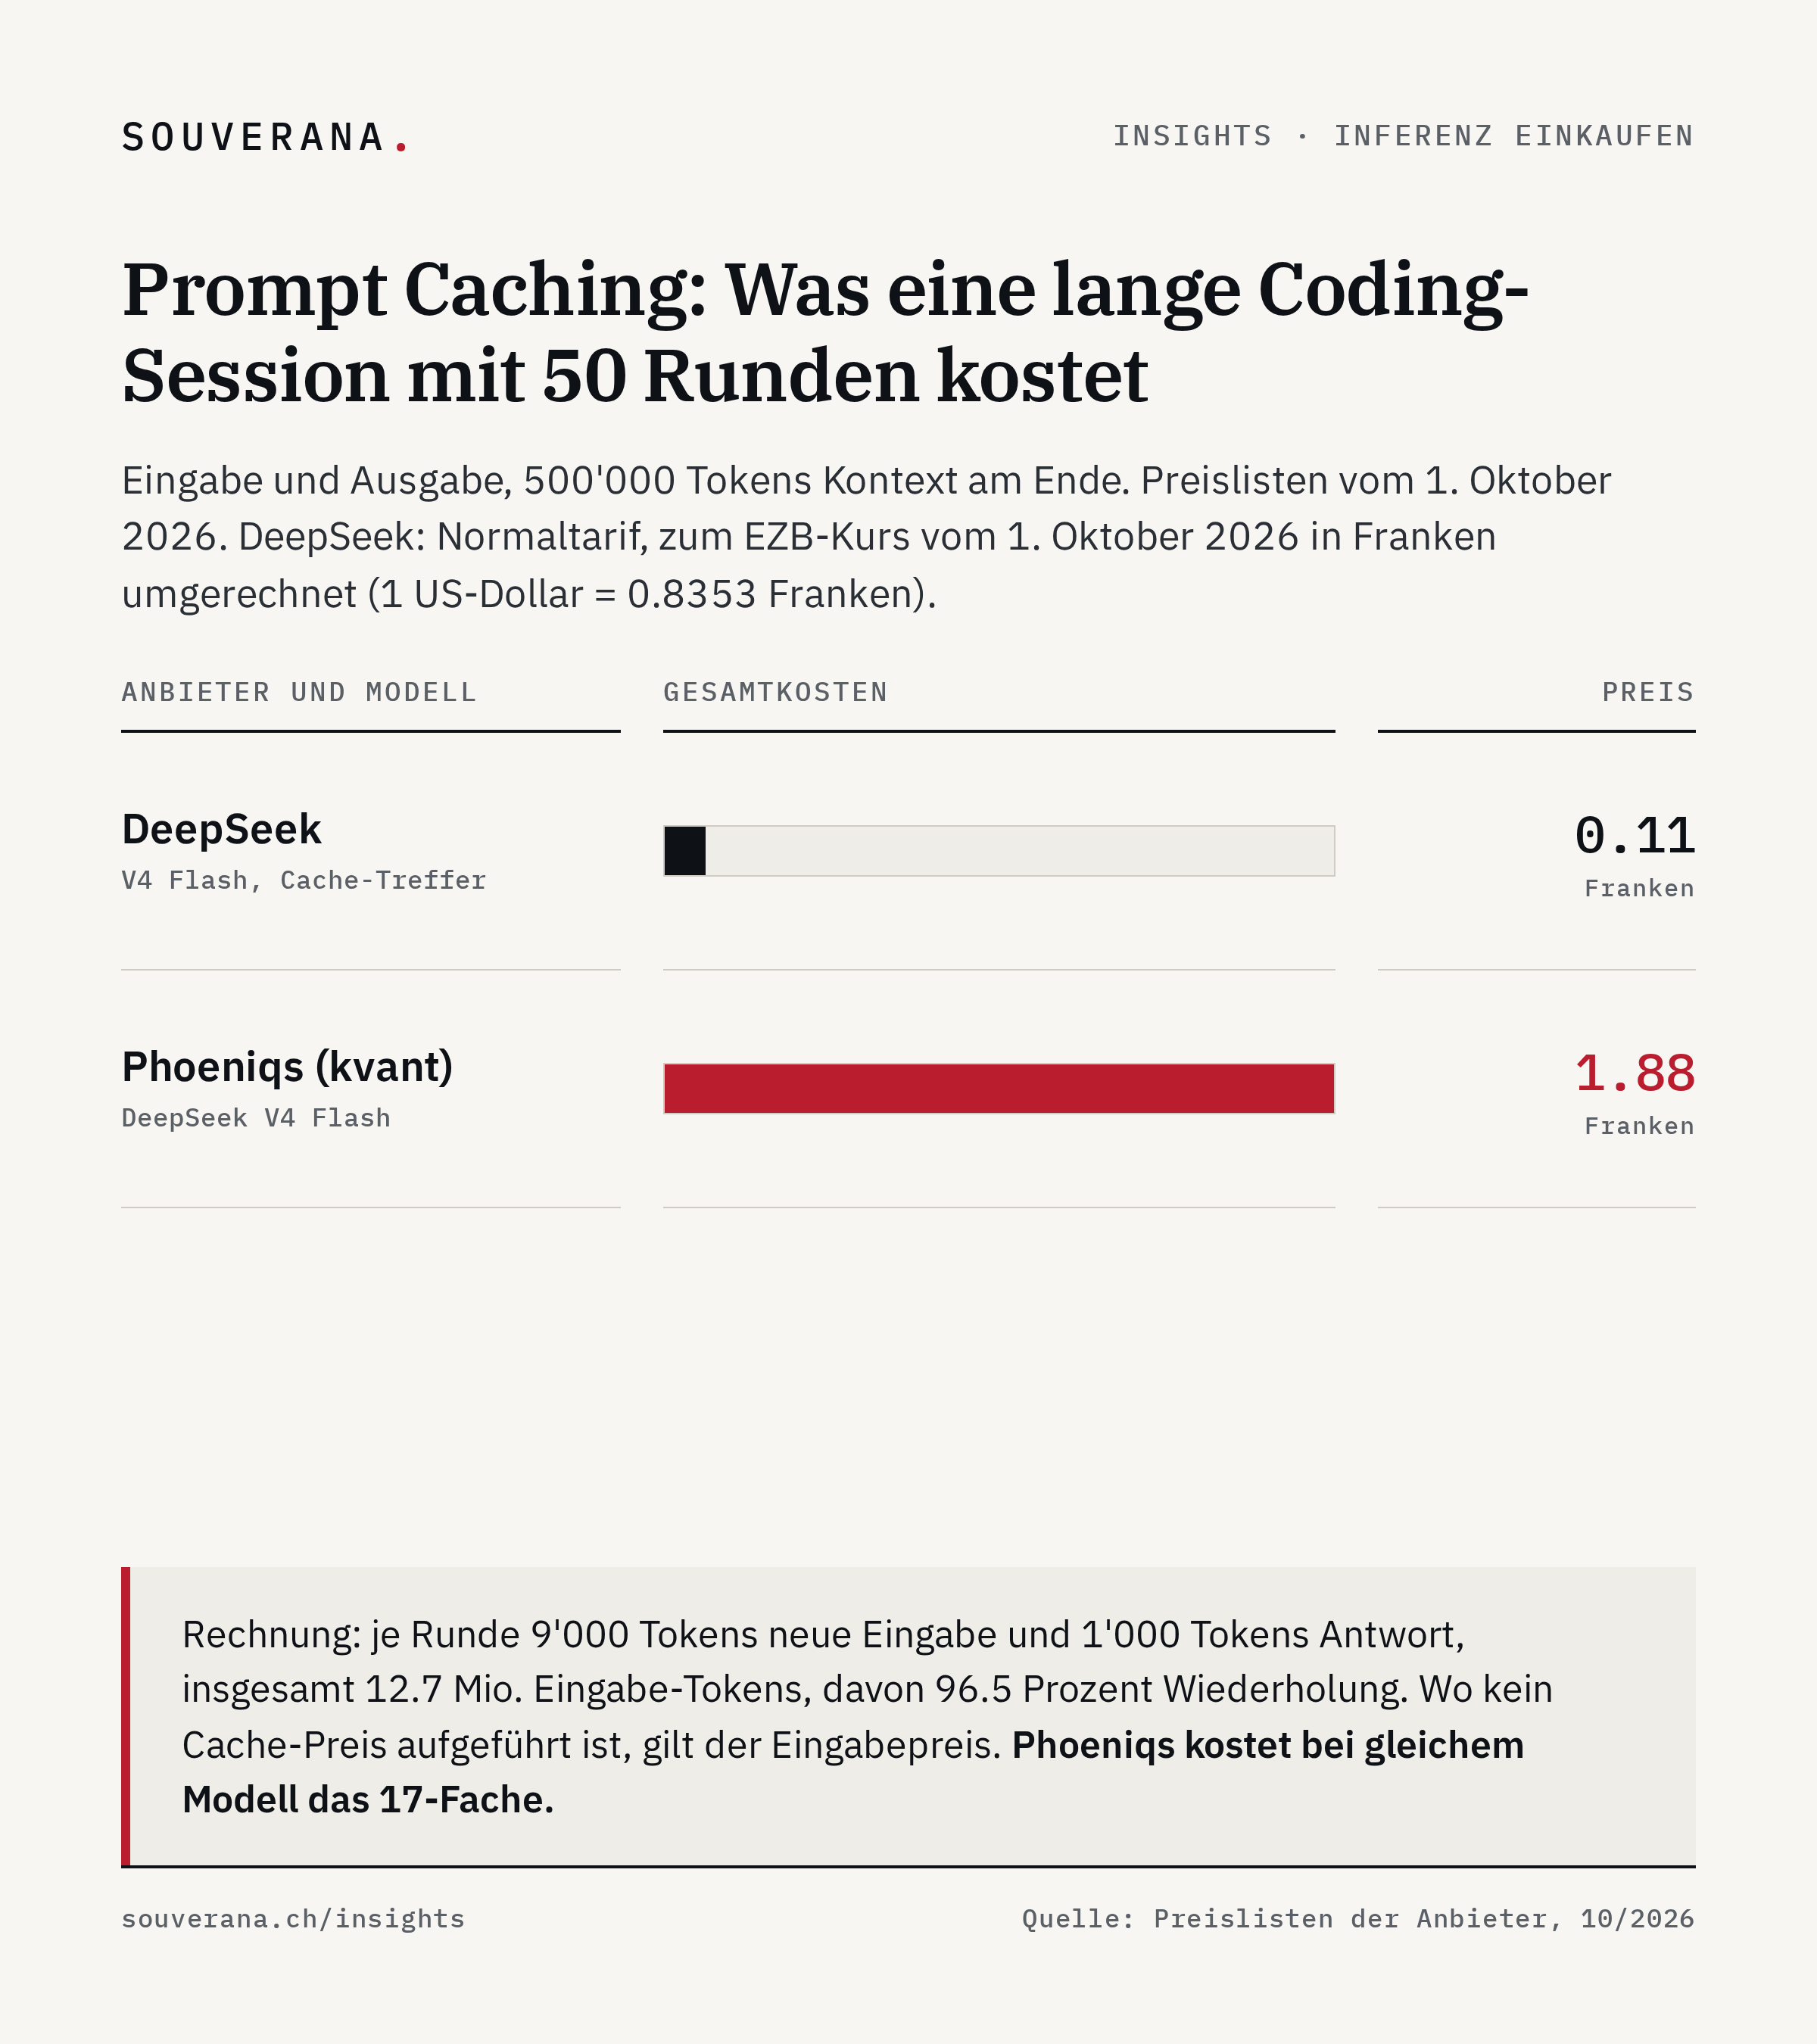
Was die Session am Ende kostet, zeigt die Tabelle. Sie folgt den Preislisten vom 1. Oktober 2026. DeepSeek ist zum Kurs der Europäischen Zentralbank vom 1. Oktober 2026 in Franken umgerechnet (1 US-Dollar = 0.8353 Franken):
| Anbieter und Modell | Eingabe | Ausgabe | Gesamt |
|---|---|---|---|
| DeepSeek V4 Flash, mit Cache | 0.087 Franken | 0.025 Franken | 0.112 Franken |
| Phoeniqs, DeepSeek V4 Flash | 1.857 Franken | 0.020 Franken | 1.876 Franken |
Wir rechnen mit dem Normaltarif von DeepSeek, weil er knapp 80 Prozent der Woche gilt. In der Spitzenzeit (Montag bis Freitag, sieben Stunden am Tag) verdoppelt DeepSeek alle Preise, der Abstand halbiert sich dann auf etwa das 8-Fache. Bei einem Chatbot, der pro Anfrage einen frischen Kontext bekommt, wäre der Abstand kaum zu spüren.
Für vertrauliche Daten empfehlen wir die DeepSeek-API nicht. Sie dient in diesem Beitrag nur als Preisreferenz.
Als Balken sieht der Abstand so aus:
Gesamtkosten einer Coding-Session mit 50 Runden
- DeepSeek V4 Flash, mit Cache0.11 Franken
- Phoeniqs DeepSeek V4 Flash1.88 Franken
Auch Anthropic bietet Prompt Caching an, mit einem anderen Preismodell. Bei den meisten Modellen kostet dort ein Cache-Treffer ein Zehntel des Eingabepreises. Das Schreiben in den Cache, also das erste Verarbeiten eines neuen Anfangs, kostet das 1.25-Fache des Eingabepreises, bei der Standard-Haltedauer (TTL) von fünf Minuten. Bei DeepSeek kostet das Schreiben nichts.
Warum der Cache nicht immer da ist
Ob ein Cache wirkt, entscheidet der Hoster. Der Kunde schickt Anfragen und sieht auf der Rechnung, was dabei herauskommt. Für den Hoster ist das Einschalten einfach, die gängige Server-Software bringt Prefix-Caching mit, und auf einem einzelnen Gerät wirkt es. In unserer eigenen Messung mit Apertus-8B, 8’000 Tokens geteiltem Kontext und acht Nutzern fiel die Wartezeit von 17.9 auf 0.9 Sekunden, bei 76.7 Prozent Trefferquote. Alle acht Nutzer fragen dort im selben Moment, der Cache bleibt warm.
Ein Agent macht Pausen. Zwischen zwei Schritten läuft ein Test, wartet eine Freigabe oder tippt ein Mensch. Bei Platzmangel löscht die Server-Software zuerst den Eintrag, der am längsten nicht benutzt wurde. Jeder neue Kunde braucht Platz. Auf einem ausgelasteten Server kann der Cache eines Agenten deshalb nach einer Pause von Minuten durch die Gespräche anderer Kunden verdrängt sein. Das haben wir nicht gemessen. Wie lange ein Hoster einen Text aufbewahrt, bestimmt er selbst. Anthropic setzt fünf Minuten als Standard-Haltedauer und berechnet für eine Stunde Haltedauer einen Aufpreis. Aufbewahren kostet Geld.
Ein Hoster, der Texte länger aufbewahren will, lagert den Cache aus dem teuren Grafikspeicher in grössere und langsamere Speicher aus, zum Beispiel in den Arbeitsspeicher des Servers. Das nennt man Offloading. Die nächste Grafik spielt das mit fünf Nutzern nach, die zwischen den Runden kurz pausieren. Liegt der Cache nur im Grafikspeicher, verdrängt jede Anfrage die eines anderen Nutzers, bevor dieser zurückkommt. Im Modell gibt es deshalb keinen einzigen Treffer, und die Wartezeiten bleiben wie ohne Cache. Schalten Sie auf «Cache mit RAM». Verdrängte Einträge wandern dann in den viel grösseren Arbeitsspeicher des Servers, der oben über dem KV-Cache steht, und kommen in der nächsten Runde zurück. Das Zurückholen kostet im Modell eine Sekunde Kopierzeit und ersetzt das Neulesen.
Wie ein Hoster das technisch einrichtet und was er neben dem Speicher sicherstellen muss, beschreiben wir im Beitrag Prompt Caching im Betrieb.
Was das für Ihren Einkauf heisst
Wir haben die Preisliste von Phoeniqs am 1. Oktober 2026 geprüft, die von Infomaniak führt ebenfalls keinen Cache-Preis auf. Swisscom und die übrigen Hoster, die Apertus anbieten, haben wir nicht ausgewertet. Unser Rechenbeispiel nutzt Phoeniqs, weil dort dasselbe Modell läuft wie bei DeepSeek und sich der Vergleich so auf den Cache-Preis beschränkt. Wo eine Preisliste keinen Cache-Preis aufführt, rechnen wir wiederholte Eingaben zum regulären Eingabepreis.
Wer Agenten einsetzt, sollte vor der Wahl eines Hosters vier Dinge klären: ob der Anfang einer Anfrage zwischengespeichert wird, was ein Treffer kostet, wie lange der Eintrag hält und ob die Antwort pro Anfrage meldet, wie viele Tokens Treffer waren. Die Fragen stehen als Arbeitsblatt im PDF dieses Beitrags. Ob die Antworten stimmen, prüfen Sie mit dem folgenden Test.
So messen Sie selbst
Ob ein Anbieter cacht, wissen Sie nach wenigen Minuten. Sie schicken dieselbe
Anfrage zweimal und lesen im Antwortfeld usage ab, wie viele Tokens als Treffer
galten. Bei DeepSeek heisst das Feld prompt_cache_hit_tokens, bei
OpenAI-kompatiblen Schnittstellen oft cached_tokens. Die Haltedauer zeigt die
Wiederholung nach Pausen von 5 und 30 Minuten. Sie brauchen dafür nur einen
API-Zugang, die Schnittstelle muss aber Treffer in usage melden.
Das Vorgehen in vier Schritten:
- 01
Lange Anfrage vorbereiten
Schreiben Sie einen festen Anfang von mindestens 5'000 Tokens, etwa ein Handbuch oder einen Systemprompt, und setzen Sie die Frage ganz ans Ende. Am Anfang darf sich nichts ändern, auch kein Zeitstempel.
- 02
Zweimal senden, Zeit messen
Senden Sie dieselbe Anfrage zweimal direkt hintereinander. Notieren Sie bei beiden die Zeit bis zum ersten Token und den Wert im Feld usage.
- 03
Pausen einlegen
Wiederholen Sie den Test nach 5 und nach 30 Minuten. So sehen Sie, wie lange der Cache hält und ob er auf einem belebten Server noch da ist.
- 04
Rechnung prüfen
Meldet das Feld Treffer, die Rechnung verbilligt sie aber nicht, zahlen Sie den vollen Preis für Arbeit, die der Anbieter gar nicht geleistet hat.
Danach wissen Sie, ob Ihr Anbieter cacht, wie lange der Cache hält und ob der Anbieter den Vorteil weitergibt. Auf dem eigenen Server lohnt dieselbe Messung.
Für die Geschäftsleitung
Dieses Dossier als PDF
Den vollständigen Beitrag plus eine kompakte Management-Zusammenfassung und Checkliste, als PDF zum Speichern und Weiterleiten.
Sie erhalten das PDF sofort. Mit dem Absenden stimmen Sie zu, dass Souverana Sie zu diesem Thema kontaktieren darf. Verarbeitung in der Schweiz/EU, keine Weitergabe an Dritte, Widerruf jederzeit (revDSG).
Häufige Fragen
- Was ist Prompt Caching?
- Der Anbieter behält im KV-Cache, einem Zwischenspeicher, die Rechenergebnisse zur bisherigen Eingabe. Beginnt die nächste Anfrage mit denselben Textstücken (Tokens), rechnet er nur den neuen Rest. Das spart Rechenzeit. Geld spart es nur bei Anbietern, die den Vorteil weitergeben, etwa DeepSeek bei V4 Flash mit 2 Prozent des Eingabepreises (Stand 1. Oktober 2026).
- Warum ist Prompt Caching bei Agenten so wichtig?
- Ein Agent sendet bei jedem Schritt Werkzeugbeschreibungen, Regeln und Verlauf erneut. In unserem Rechenbeispiel (Coding-Session, 50 Runden mit je 9'000 Tokens neuer Eingabe) sind 96.5 Prozent der Eingabe Wiederholung. Mit Cache kostet die Session bei DeepSeek V4 Flash 0.11 Franken, bei Phoeniqs ohne Cache-Preis 1.88 Franken (Preislisten vom 1. Oktober 2026, DeepSeek zum EZB-Kurs vom 1. Oktober 2026 umgerechnet, 1 US-Dollar = 0.8353 Franken).
- Bieten Schweizer Hoster Prompt Caching an?
- Bei den von uns geprüften Schweizer Hostern führt Phoeniqs (kvant) in der Preisliste vom 1. Oktober 2026 nur einen Eingabepreis auf, die von Infomaniak ebenfalls keinen Cache-Preis. Wiederholte Eingaben rechnen wir deshalb zum vollen Preis, bei Phoeniqs etwa 0.1462 Franken je Million Tokens für DeepSeek V4 Flash. Fragen Sie schriftlich nach dem Preis für Cache-Treffer und der Haltedauer, oder prüfen Sie es mit dem Test in diesem Beitrag.
Diesen Beitrag teilen
Fertig formatierte Grafiken und ein Textvorschlag für Ihren LinkedIn-Post: herunterladen, kopieren, posten.
Textvorschlag
Setzen Sie KI-Agenten ein, die bei jedem Schritt denselben langen Kontext erneut senden? Dann zahlen Sie bei Phoeniqs jedes Mal den vollen Eingabepreis, denn die Preisliste vom 1. Oktober 2026 führt keinen Cache-Preis auf, also keinen Preis für wiederholte Eingaben.

DeepSeek V4 Flash berechnet eine Eingabe, die der Anbieter aus dem Zwischenspeicher liest (Cache-Treffer), mit 0.0025 Franken je Million Tokens, ohne Treffer sind es 0.125 (Tarif ausserhalb der Spitzenzeit, zum EZB-Kurs vom 1. Oktober 2026 umgerechnet).

Unser Rechenbeispiel ist eine lange Coding-Session mit 50 Runden: je 9'000 Tokens neue Eingabe, 1'000 Tokens Antwort, am Ende 500'000 Tokens Kontext. Bei DeepSeek kostet sie 0.11 Franken. Phoeniqs betreibt dasselbe Modell und verrechnet Wiederholungen voll. Dieselbe Session kostet dort 1.88 Franken, etwa das 17-Fache.

Wir schliessen daraus, dass für Agenten der Cache-Preis neben den Listenpreis in jeden Anbietervergleich gehört.

Im Beitrag: wie ein Modell die Eingabe liest (Prefill), die Antwort schreibt (Decode) und viele Nutzer gleichzeitig bedient (Batching), wie Prompt Caching die Wiederholung spart, warum ein Cache bei Agenten mit Pausen verdrängt wird und ein Test, mit dem Sie Ihren Anbieter in einer knappen Stunde prüfen. Link in den Kommentaren.

#KI #LLM #Inferenz #Schweiz #PromptCaching