Ollama, llama.cpp oder vLLM: die richtige Engine wählen
Ob Ollama, llama.cpp oder vLLM: Die Wahl hängt von zwei Fragen ab. Wie viele Menschen arbeiten gleichzeitig auf dem Modell, und wie viel Grafikspeicher haben Sie im Verhältnis zum Wunschmodell? Drei Werkzeuge, auf derselben Hardware gemessen.
Technik · Veröffentlicht 14.08.2026 · Aktualisiert 14.08.2026 · Joel Barmettler
Ollama, llama.cpp oder vLLM: welche Engine brauche ich?
Ollama, llama.cpp und vLLM sind Programme, die ein KI-Modell auf eigener Hardware ausliefern. Die Wahl hängt an zwei Fragen: Wie viele Menschen arbeiten gleichzeitig darauf, und passt das Modell ganz in den Grafikspeicher? Eine Person arbeitet mit Ollama am bequemsten, bei knappem Speicher oder einem Team passt llama.cpp, bei vielen Nutzern und reichlich Speicher vLLM.
Das Wichtigste in Kürze
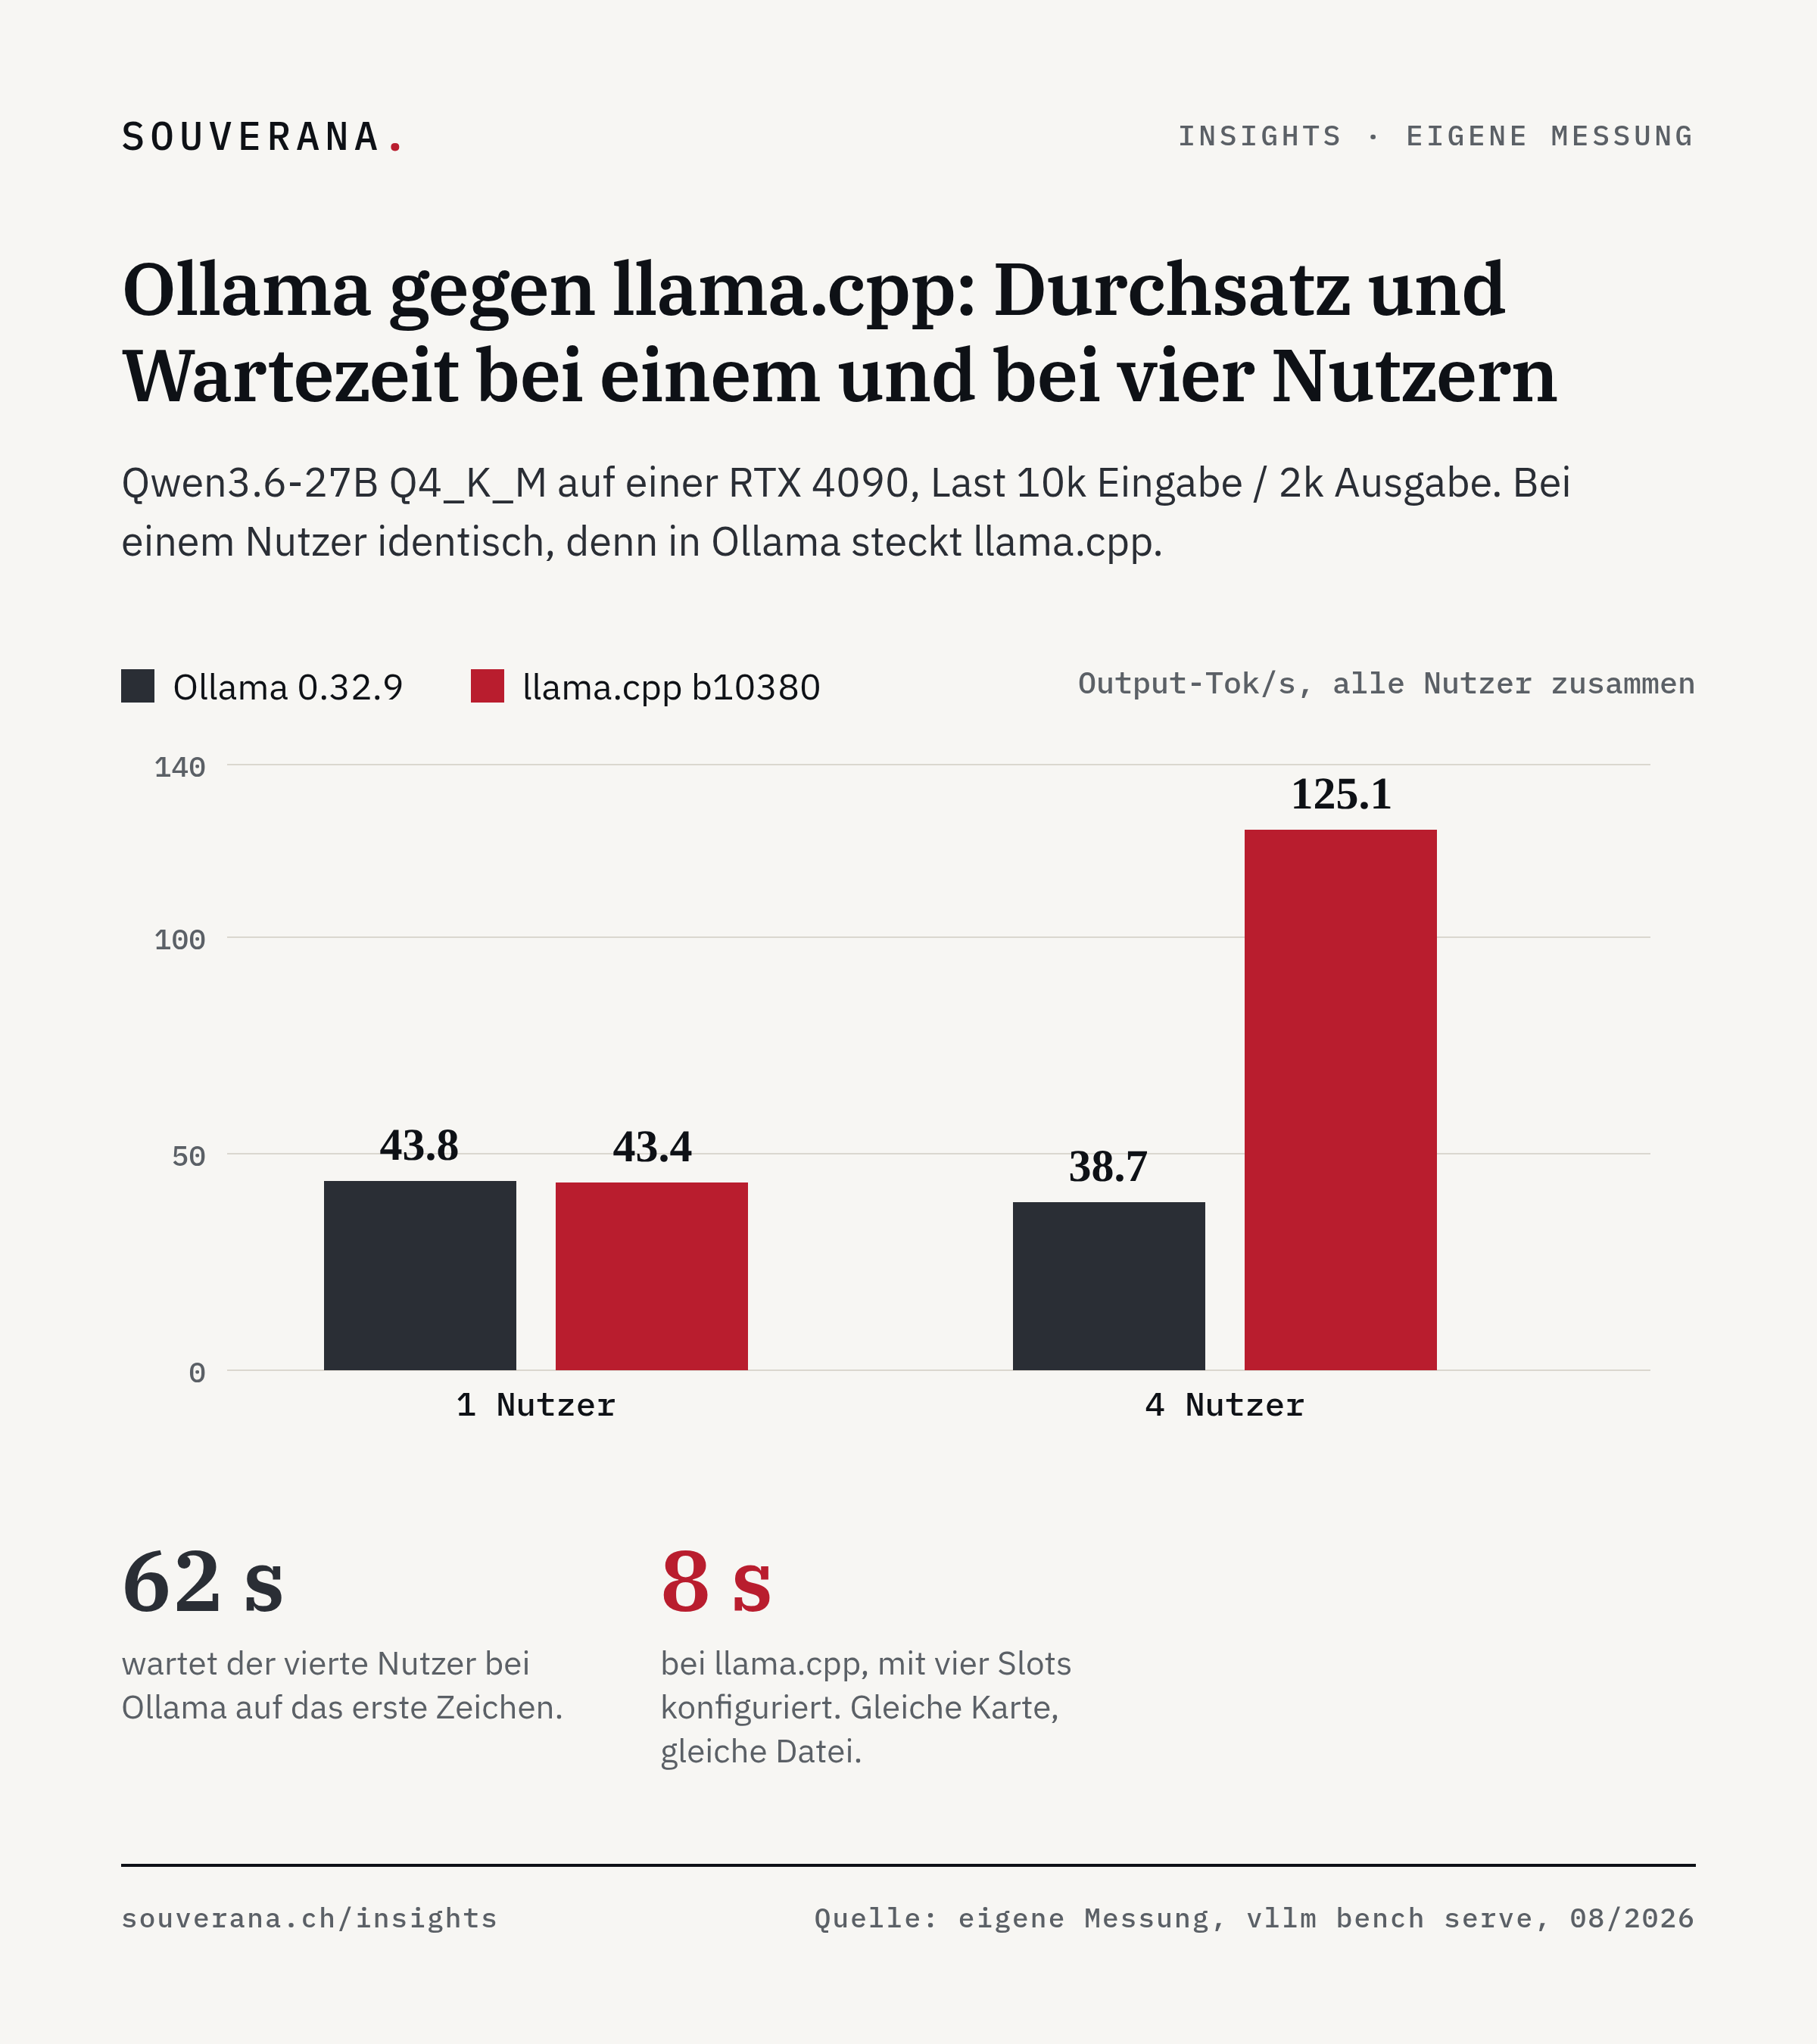
- Ollama arbeitet Anfragen nacheinander ab. In unserer Messung mit vier gleichzeitigen Nutzern wartete der vierte 62 Sekunden auf das erste Zeichen der Antwort. llama.cpp bediente dieselben vier Nutzer mit derselben Modelldatei auf derselben Grafikkarte nach 8 Sekunden.
- Für eine einzelne Person ist Ollama die angenehmste Wahl. Es ist in Minuten installiert, und die erste Antwort kam nach 0.9 Sekunden.
- Wer ein möglichst grosses Modell auf kleiner Hardware betreiben will, nimmt llama.cpp. Nur dort lassen sich die Experten eines MoE-Modells in den Arbeitsspeicher auslagern (Mixture of Experts: ein Modell aus vielen Teilnetzen, den Experten, von denen je Token nur wenige rechnen).
- vLLM lohnt sich bei vielen gleichzeitigen Nutzern und einem Modell, das bequem in den Grafikspeicher passt. Bei acht Nutzern lieferte es 240 Tokens pro Sekunde, llama.cpp 165.
- SGLang ist eine weitere Engine, die auf Anfragen mit geteiltem Kontext spezialisiert ist. Unser Hybridmodell (es mischt zwei Arten von Schichten) startete darauf nicht. Prüfen Sie deshalb vor der Wahl von vLLM oder SGLang, ob Ihr Modell unterstützt ist.
Zwei Messungen stehen am Anfang. Dieselbe Modelldatei, dieselbe Grafikkarte (eine RTX 4090), ein Nutzer: Ollama liefert 43.8 Tokens pro Sekunde (ein Token ist ein Textbaustein von wenigen Zeichen), llama.cpp 43.4. Praktisch identisch. Dieselbe Datei, dieselbe Karte, vier Nutzer: Ollama fällt auf 38.7, llama.cpp steigt auf 125.1.
Diese zwei Messungen zeigen die erste Achse der Wahl: die Zahl gleichzeitiger Nutzer. Die zweite Achse ist Ihr Grafikspeicher im Verhältnis zum Wunschmodell. Bei ihr stehen sich die beiden grossen Engines gegenüber. vLLM ist für Maschinen gebaut, in deren Grafikspeicher das Modell bequem passt, und verwandelt den übrigen Grafikspeicher in Durchsatz. llama.cpp ist für den umgekehrten Fall gebaut und holt aus knappem Grafikspeicher das grösstmögliche Modell heraus.
Die Engine ist dabei die Software, die ein Modell lädt, Anfragen entgegennimmt und die Grafikkarte auslastet. Auf die Klugheit der Antworten hat sie keinen Einfluss. Wir haben drei Werkzeuge auf derselben Hardware vermessen, dazu einen Spezialisten, der es nicht bis zur Messung geschafft hat.
Dieser Artikel ist der vierte Teil unserer Serie über lokale Inferenz. Nach Maschine, Speicher und Quantisierung geht es um die Software, die das Modell ausliefert.
Für den Einzelplatz: Ollama
Ollama installiert sich in Minuten, lädt Modelle mit einem Befehl und verwendet intern dieselben Rechenkerne wie llama.cpp. Die identischen 43.8 gegen 43.4 Tokens pro Sekunde bei einem Nutzer sind der Beleg: gleiche Kerne, gleiche Quantisierung, gleiche Karte.
Für die Person, die allein damit arbeitet, antwortet es sogar am schnellsten: Die erste Antwort kam nach 0.92 Sekunden, bei llama.cpp mit unseren Server-Einstellungen erst nach 3.65.
Mit dem zweiten gleichzeitigen Nutzer beginnt das Problem:
Bei vier gleichzeitigen Nutzern verliert Ollama sogar leicht Durchsatz, und die Wartezeit bis zum ersten Zeichen springt von 0.92 auf 62 Sekunden. Das ist das Muster einer Warteschlange: Der vierte Nutzer wartet, bis die ersten drei fertig sind. llama.cpp, mit vier Slots (vier parallelen Bearbeitungsplätzen) konfiguriert, verarbeitet dieselben vier Anfragen gemeinsam auf der Karte.
Wir haben auch die Einstellung geprüft, die die Dokumentation dafür anbietet.
Mit OLLAMA_NUM_PARALLEL=4 blieb der Durchsatz bei vier Nutzern unverändert
(38.6 Tokens pro Sekunde), und der Einzelnutzer wurde deutlich langsamer (26.6
gegenüber 43.8). Möglicherweise teilten sich dabei die vier Slots den
eingestellten Kontext, was die Verschlechterung erklären würde. Sicher ist nur,
dass sich der Durchsatz mit den Mitteln der Dokumentation nicht auf den Wert
von llama.cpp bringen liess.
Ollama ist ein Einzelplatzwerkzeug und für diesen Platz gut.
Für den kleinen Server: llama.cpp
llama.cpp ist die Software, die Ollama intern verwendet, ohne dessen Komfort und ohne dessen Grenzen: ein einzelnes Programm, das GGUF-Dateien lädt, eine OpenAI-kompatible Schnittstelle anbietet und Anfragen bündelt. Der Server war in unseren Läufen rund fünf Sekunden nach dem Start bereit, was Modellwechsel und Experimente schnell macht.
Zwei Fähigkeiten machen es zur ersten Wahl für ein kleines Team mit einem eigenen Server.
Es bündelt Anfragen. Die 125.1 Tokens pro Sekunde bei vier Nutzern aus der Grafik oben sind fast das Dreifache der 43.4 Tokens pro Sekunde bei einem Nutzer, auf derselben einzelnen Karte. Die Wartezeit bis zum ersten Zeichen blieb bei 8.1 Sekunden, während Ollama dieselben vier Nutzer 62 Sekunden warten liess.
Es holt aus knappem Grafikspeicher das grösste Modell. llama.cpp legt die
selten gebrauchten Experten eines MoE-Modells gezielt in den Arbeitsspeicher (--n-cpu-moe, ausführlich in
Teil 2). Damit lief bei uns ein 35-Milliarden-Modell in
4.5 GB Grafikspeicher, und ein 284-Milliarden-Modell mit 9.6 Tokens pro Sekunde
auf zwei Consumer-Karten. vLLM kennt zwar ebenfalls eine Auslagerung, aber eine
undifferenzierte: 8 GB eines Dense-Modells (ein
Modell, bei dem für jedes Token alle Parameter rechnen) auszulagern kostete dort
Faktor 22 beim Tempo. Von den drei Werkzeugen bietet nur llama.cpp eine
Auslagerung, die brauchbar bleibt.
Dafür konfigurieren Sie selbst. Kontextlänge, Parallelität, Offload und Flash-Attention stellen Sie über Startoptionen (Flags) ein, und die Voreinstellungen passen selten. Die Kommandos, mit denen unsere Messungen liefen, stehen im Anhang.
Für den Betrieb: vLLM
vLLM ist für den Fall gebaut, in dem das Modell bequem in den Grafikspeicher passt und die Karte ständig ausgelastet ist: viele Nutzer, lange Eingaben, Dauerbetrieb. Es fährt kontinuierliches Batching (neue Anfragen steigen mitten in laufende Berechnungen ein), liest AWQ- und FP8-Formate und verwaltet den KV-Cache seitenweise.
Auf zwei Karten mit realistischer Last (10’000 Tokens Eingabe, 2’000 Ausgabe):
Bei vier Nutzern liefert vLLM das Doppelte von llama.cpp, bei acht bleiben 46 Prozent Vorsprung. Dem stehen zwei Nachteile gegenüber. Beim Einzelnutzer erschien das erste Zeichen nach 3.5 Sekunden, bei llama.cpp nach 0.6. Und der erste Start dauerte Minuten, weil vLLM seine Kernel kompiliert, während llama.cpp nach fünf Sekunden bereit war.
Am meisten bringt vLLM bei Lasten, die sich einen Kontext teilen, also bei RAG und Agenten mit festem Systemprompt. Sein Prefix-Caching verarbeitet den geteilten Teil nur einmal: In unserer Messung mit 8’000 Tokens geteiltem Kontext und acht Nutzern fiel die Wartezeit bis zum ersten Zeichen von 17.9 auf 0.9 Sekunden, Faktor 19 durch einen einzigen Schalter.
Der Spezialist, der nicht startete: SGLang
SGLang ist auf geteilte Kontexte spezialisiert und wäre für Agenten-Lasten der vierte Kandidat gewesen. Auf unserem Modell kam es nie so weit: Der Start scheiterte an einem seit Juli offenen Fehler mit Hybridmodellen (GitHub-Issue #30178); der dokumentierte Workaround behob den ersten Absturz, danach blieb die erste Anfrage in einem Timeout hängen.
Über SGLang als Ganzes sagt das wenig, auf reinen Attention-Modellen berichten andere gute Zahlen. Der Fall zeigt die Werkzeugreife bei neuen Architekturen: Bei neuen Modellbauarten ist die Auswahl an Engines, die sie tatsächlich unterstützen, nach unserer Erfahrung klein. Prüfen Sie die Kombination aus Modell und Engine, bevor Sie eine der beiden festlegen.
Die Zuordnung
| Ihre Situation | Werkzeug | Der Messwert dahinter |
|---|---|---|
| Eine Person, eigener Rechner | Ollama | erste Antwort nach 0.9 s, Tempo identisch mit llama.cpp |
| Kleines Team, ein Server | llama.cpp | verdreifacht den Durchsatz bei vier Nutzern, startet in 5 s |
| Modell grösser als der Grafikspeicher | llama.cpp | 35 Milliarden Parameter in 4.5 GB, 284 Milliarden auf zwei Karten |
| Modell passt bequem, viele Nutzer | vLLM | 240 Tokens pro Sekunde bei acht Nutzern |
| RAG und Agenten mit festem Kontext | vLLM mit Attention-Modell | Wartezeit um Faktor 19 gesenkt |
Jedes der drei Werkzeuge schlägt in einem Fall die anderen. Die falsche Wahl kostete in unseren Messungen 62 Sekunden Wartezeit, auf einer Karte, die schon nach 0.9 Sekunden antworten konnte.
So starten Sie
Vier Schritte führen von der ersten Prüfung bis zum Dauerbetrieb.
- 01
Mit Ollama das Modell prüfen
Für die Frage, ob das Modell Ihre Aufgaben kann, ist der Einzelplatz genau richtig. Diese Prüfung kostet einen Nachmittag und braucht keinen Server.
- 02
Für den Team-Test auf llama.cpp wechseln
Dieselbe GGUF-Datei läuft dort weiter. Setzen Sie Kontextlänge und Parallelität bewusst, die Startkommandos aus dem Anhang sind ein geprüfter Ausgangspunkt.
- 03
Vor dem Dauerbetrieb vLLM gegen Ihre Last messen
Mit dem eingebauten Benchmark (vllm bench serve) und Ihrer echten Eingabelänge, denn ohne sie lässt sich nicht beantworten, wie viele Nutzer der Server bedienen kann.
- 04
Engine-Version festhalten
Unsere erste Messrunde lief versehentlich auf einer acht Minor-Versionen alten vLLM-Installation. Wer misst, notiert zuerst die Version, sonst gelten die Zahlen nur für eine veraltete Installation.
Bleibt die Frage, was der ganze Aufbau kostet und wann er sich rechnet. Sie beantwortet der fünfte und letzte Teil der Serie.
Für die Geschäftsleitung
Dieses Dossier als PDF
Den vollständigen Beitrag plus eine kompakte Management-Zusammenfassung und Checkliste, als PDF zum Speichern und Weiterleiten.
Sie erhalten das PDF sofort. Mit dem Absenden stimmen Sie zu, dass Souverana Sie zu diesem Thema kontaktieren darf. Verarbeitung in der Schweiz/EU, keine Weitergabe an Dritte, Widerruf jederzeit (revDSG).
Häufige Fragen
- Was ist besser, Ollama oder vLLM?
- Für eine einzelne Person ist Ollama die angenehmste Wahl: In unserer Messung lieferte es die erste Antwort nach 0.9 Sekunden. Ab mehreren gleichzeitigen Nutzern gehört der Dienst auf llama.cpp oder vLLM, zwei andere Engines. Ollama arbeitete Anfragen nacheinander ab und liess den vierten Nutzer 62 Sekunden warten.
- Ist Ollama langsamer als llama.cpp?
- Bei einem Nutzer nicht: Wir haben 43.8 gegen 43.4 Tokens pro Sekunde gemessen, denn unter Ollama arbeitet dieselbe llama.cpp-Software. Der Unterschied entsteht bei mehreren Nutzern, weil llama.cpp Anfragen bündelt und seinen Durchsatz verdreifacht, während Ollama sie nacheinander abarbeitet.
- Wann brauche ich vLLM?
- vLLM ist eine Engine für viele gleichzeitige Nutzer. Sie lohnt sich, wenn Anfragen denselben langen Kontext teilen, etwa bei RAG (Antworten auf Basis eigener Dokumente). vLLM lieferte bei acht Nutzern 240 Tokens pro Sekunde gegenüber 165 bei llama.cpp, und sein Prefix-Caching (der geteilte Anfang wird nur einmal verarbeitet) senkte die Wartezeit bei geteiltem Kontext um Faktor 19.
- Was kann llama.cpp, was vLLM nicht kann?
- llama.cpp kann Teile eines MoE-Modells (Mixture of Experts, ein Modell aus vielen Teilnetzen) gezielt in den Arbeitsspeicher auslagern. Damit lief bei uns ein 35-Milliarden-Modell in 4.5 GB Grafikspeicher und ein 284-Milliarden-Modell auf zwei Consumer-Karten. Ausserdem startet llama.cpp in Sekunden, wo vLLM beim ersten Start Minuten braucht.
- Lohnt sich SGLang für lokale Modelle?
- SGLang ist eine Engine, die für Lasten mit geteiltem Kontext gebaut ist. Auf unserem Modell liess sie sich aber nicht betreiben: Ein seit Juli offener Fehler verhinderte den Betrieb mit dem Hybridmodell Qwen3.6. Wer SGLang erwägt, prüft zuerst, ob das eigene Modell unterstützt ist.
Diesen Beitrag teilen
Fertig formatierte Grafiken und ein Textvorschlag für Ihren LinkedIn-Post: herunterladen, kopieren, posten.
Textvorschlag
Testen Sie lokale KI gerade mit Ollama, einem Programm, das KI-Modelle auf eigener Hardware ausführt? Für eine einzelne Person ist das die richtige Wahl.

Sobald ein Team darauf zugreift, ändert sich das Bild grundlegend, und viele Pilotprojekte scheitern genau an dieser Stelle, ohne dass jemand die Ursache sieht.

Gemessen mit derselben Modelldatei auf derselben RTX 4090: Bei einem Nutzer liefern Ollama und llama.cpp praktisch identische 43.8 und 43.4 Tokens pro Sekunde, denn in Ollama steckt llama.cpp. Bei vier gleichzeitigen Nutzern sind es 38.7 gegenüber 125.1, und der vierte Nutzer wartet 62 statt 8 Sekunden auf das erste Zeichen. Ollama arbeitet die Anfragen nacheinander ab, llama.cpp bündelt sie.

Unser Schluss: Wer den Teambetrieb mit Ollama testet, misst vor allem eine Warteschlange. So entsteht der Eindruck, KI im eigenen Betrieb sei zu langsam, obwohl die Karte kaum ausgelastet ist.

Im Beitrag stehen alle Messwerte, die fertigen Startkommandos und der Fall, in dem vLLM bei geteiltem Kontext den Faktor 19 herausholt. Link in den Kommentaren.

#KI #LLM #Ollama #vLLM