Prompt Caching im Betrieb: Was ein Hoster einrichten muss
Ob Prompt Caching bei einem Hoster wirkt, hängt von seiner Technik ab: wo der Zwischenspeicher liegt, wie lange er Einträge behält und ob der Hoster Treffer misst. Dieser Beitrag zeigt die Bausteine, damit Sie einem Anbieter die richtigen Fragen stellen, und erklärt, warum das Schweizer Modell Apertus 70B etwa 30-mal mehr Zwischenspeicher braucht als DeepSeek V4.
Vertiefung · Veröffentlicht 06.10.2026 · Aktualisiert 06.10.2026 · Joel Barmettler
Wovon es abhängt, ob ein Cache beim Hoster wirkt
Dieser Beitrag beschreibt die Bausteine und was ein Hoster einrichten muss, damit sich der Cache auch bei Agenten mit Pausen lohnt. Er baut auf dem Beitrag Prompt Caching: Warum Agenten in der Schweiz teurer laufen auf.
Das Wichtigste in Kürze
- DeepSeek hält den Cache auf Festplatten und macht die Einträge über die Bauweise des Modells klein. Eine Trefferquote garantiert es nicht.
- Die Server-Software vLLM hält den Cache im Grafikspeicher. Auf einem einzelnen Gerät wirkt das gut, bei Pausen und vielen Nutzern kann der Cache verdrängt werden.
- Wer länger aufbewahren will, lagert den Cache in Arbeitsspeicher oder auf SSD aus. Das lohnt sich erst, wenn die Caches nicht mehr in den Grafikspeicher passen.
- Ein Plugin allein genügt nicht. Der Hoster muss auch SSD-Speicher, Verteilung der Anfragen, eine zugesicherte Haltedauer und eine Messung der Treffer sicherstellen.
Dieser Beitrag ist der dritte Teil unserer Serie zum Einkauf von Inferenz. Er zeigt, was beim Hoster hinter einem funktionierenden Cache steckt.
Wie DeepSeek den Cache betreibt
DeepSeek hält den Cache auf Festplatten. Die API-Dokumentation nennt das «Context Caching on Disk», und es ist für alle Nutzer standardmässig aktiv. Einen Treffer gibt es nur, wenn der Anfang der Anfrage vollständig mit einer gespeicherten Einheit übereinstimmt. Eine Trefferquote garantiert DeepSeek nicht. Das System arbeitet laut Dokumentation nach bestem Bemühen («best-effort»). Ungenutzte Einträge löscht DeepSeek nach wenigen Stunden bis wenigen Tagen.
Wie oft der Cache in der Praxis trifft, hat DeepSeek 2025 für sein damaliges System veröffentlicht. Für V4 kennen wir keine Messung.
Kennzahl
56.3 %Quelle: DeepSeek, Inference System Overview, Open-Source-Woche, Februar 2025
Eine Festplatte taugt als Cache nur, wenn die Einträge klein sind. Dann lassen sie sich billig lange aufbewahren und schnell wieder laden. DeepSeek verkleinert sie über die Architektur des Modells. Laut dem technischen Bericht von V4 (arXiv 2606.19348) braucht V4-Pro bei einer Million Tokens Kontext rund ein Zehntel des KV-Caches der Vorgängerversion. Der vLLM-Blog vom 24. April 2026 rechnet für V4 mit rund 10 Gigabyte je Million Tokens. Verantwortlich sind Compressed Sparse Attention und Heavily Compressed Attention, zwei Verfahren im Modell, die je Token weniger Zwischenspeicher belegen.
Der Cache im Grafikspeicher
Server-Software wie vLLM, eine verbreitete Open-Source-Software für Sprachmodelle, bringt Prefix-Caching mit, das Prompt Caching auf dem eigenen Server. Prefix heisst Anfang: Nur ein Anfang, der Token für Token übereinstimmt, zählt als Treffer. Auf einem einzelnen Gerät wirkt es. In unserer eigenen Messung mit Apertus-8B, 8’000 Tokens geteiltem Kontext und acht Nutzern fiel die Wartezeit von 17.9 auf 0.9 Sekunden, bei 76.7 Prozent Trefferquote. Alle acht Nutzer fragen dort im selben Moment, der Cache bleibt warm.
Ein Agent macht Pausen. vLLM hält den Cache im Grafikspeicher und löscht bei Platzmangel zuerst den Block, der am längsten nicht benutzt wurde. Auf einem ausgelasteten Server kann der Cache eines Agenten deshalb nach einer Pause von Minuten verdrängt sein. Das haben wir nicht gemessen. Der KV-Cache kann mehr Grafikspeicher belegen als das Modell selbst, deshalb ist der Platz knapp.
Auslagern: Offloading-Connector und LMCache
Ein Hoster, der Einträge länger aufbewahren will, lagert den Cache aus dem Grafikspeicher in grössere und langsamere Speicher aus. Dafür gibt es zwei Wege, die Hoster oft als «Plugin» (Zusatzmodul) beschreiben.
Der erste Weg ist der Offloading-Connector, der in vLLM eingebaut ist. Die Einrichtung ist ein Schalter: Ab vLLM 0.14 genügt --kv_offloading_backend native --kv_offloading_size <GB>, und der Cache wandert in den Arbeitsspeicher des Servers. Die Wirkung beziffert vLLM selbst: 2- bis 22-mal kürzere Wartezeit bis zum ersten Token (Llama-3.1-8B auf einer H100-Grafikkarte, je nach Länge der Eingabe) und bis zu 9-mal mehr Durchsatz bei hoher Trefferquote (10’000 Anfragen mit je 512 Tokens).
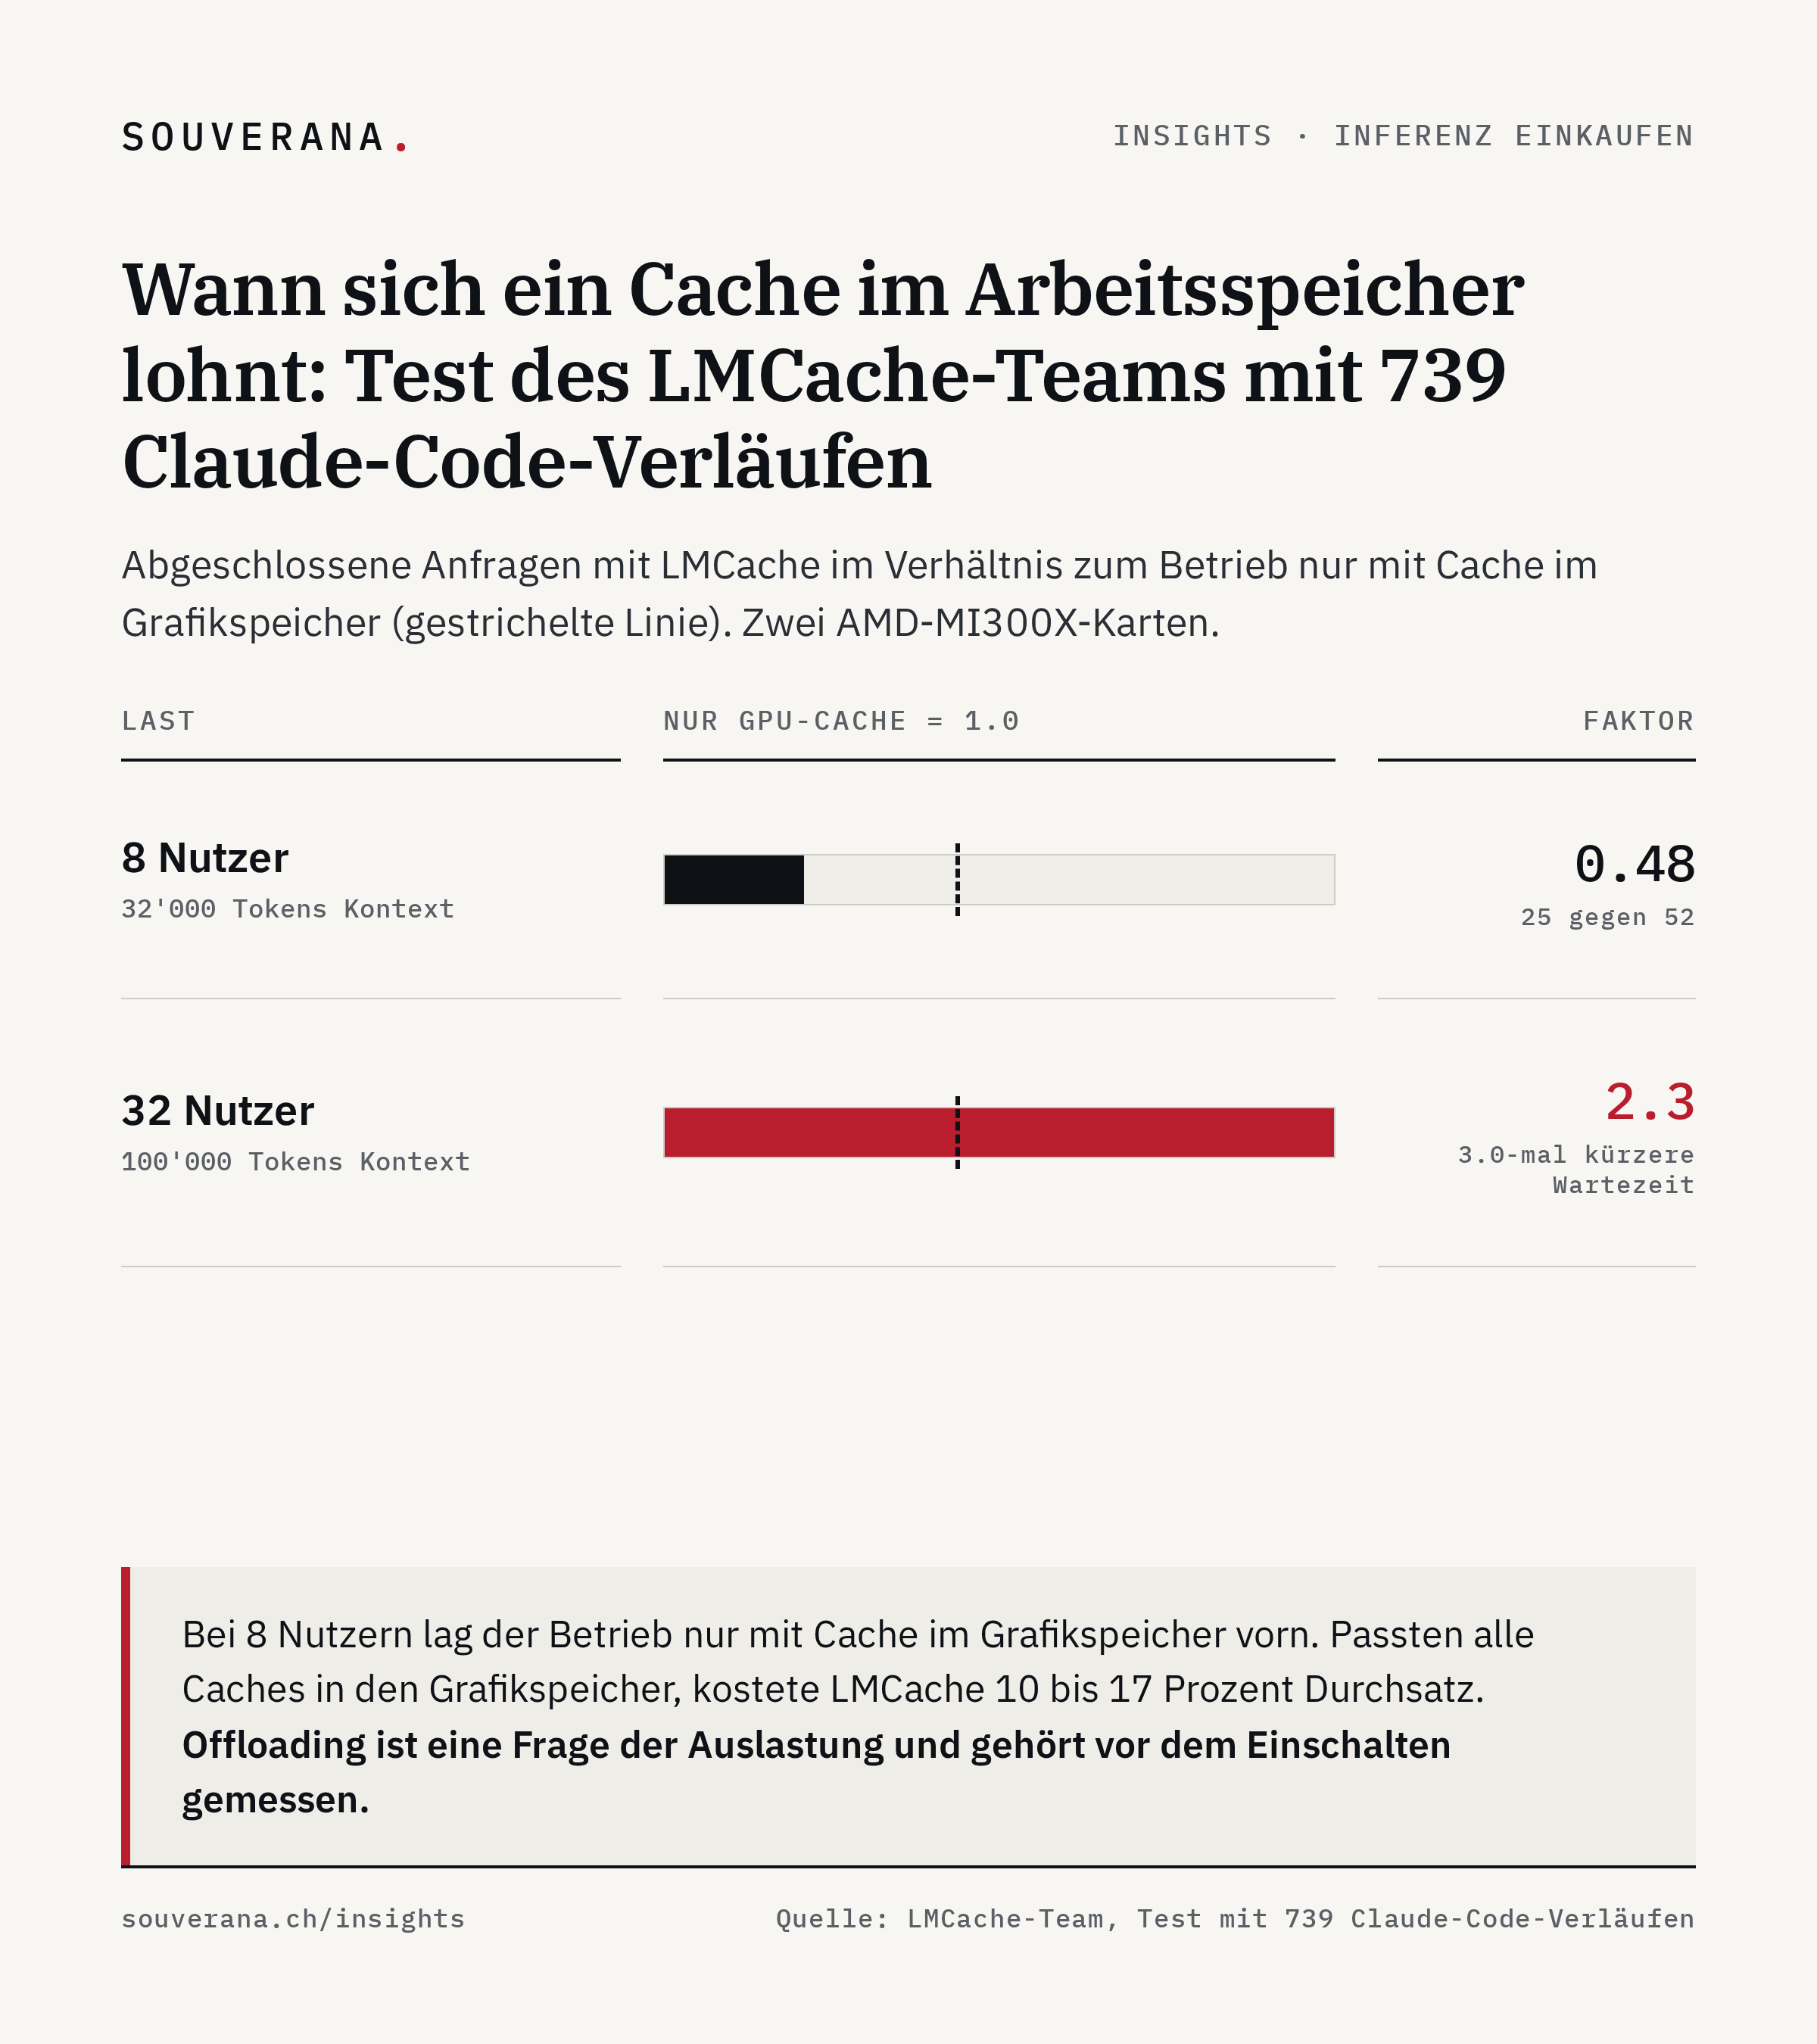
Der zweite Weg ist LMCache, ein Open-Source-Zusatz zu vLLM. Er lagert den Cache aus vLLM in Arbeitsspeicher, auf Festplatte oder in einen entfernten Speicher aus und kann ihn zwischen Rechnern teilen. Die Autoren nennen bis zu 15-mal mehr Durchsatz (arXiv 2510.09665). Wann es sich lohnt, zeigt ein Test des LMCache-Teams selbst mit 739 echten Claude-Code-Verläufen auf zwei AMD-MI300X-Karten. Bei 8 Nutzern mit 32’000 Tokens Kontext lag der Betrieb ohne LMCache, nur mit Cache im Grafikspeicher, vorn, mit 52 gegen 25 abgeschlossenen Anfragen. Bei 32 Nutzern mit 100’000 Tokens Kontext drehte es. LMCache brachte 3.0-mal kürzere mittlere Wartezeit bis zum ersten Token und 2.3-mal mehr Anfragen. Passten alle Caches in den Grafikspeicher, kostete LMCache 10 bis 17 Prozent Durchsatz.
Ein Plugin liefert nur den Speicher. Damit der Cache bei Agenten wirkt, muss der Hoster vier Dinge sicherstellen:
- ein Speicher auf SSD für Hunderte Gespräche, wenn der Arbeitsspeicher nicht reicht,
- eine Verteilung der Anfragen, die eine Sitzung wieder zu dem Rechner bringt, der ihren Cache hält, oder ein gemeinsamer Speicher über alle Rechner,
- eine Haltedauer, die der Hoster zusichert,
- eine Messung, die pro Anfrage meldet, wie viele Tokens Treffer waren, damit sich dafür überhaupt ein Preis berechnen lässt.
DeepSeek hat das für das eigene Modell gelöst. Ein Hoster muss es für jedes Modell neu lösen. Ein Cache-Preis setzt voraus, dass sich die Trefferquote verlässlich messen und halten lässt.
Prefill und Decode auf getrennten Rechnern
Grosse Betreiber trennen die beiden Phasen auch räumlich. Eine Gruppe Rechner liest Eingaben (Prefill), eine andere schreibt Antworten (Decode), und dazwischen wandert der KV-Cache über ein schnelles Netz. DeepSeek betrieb sein System im Februar 2025 so, mit einem Verbund aus vier Knoten für den Prefill und einem aus 18 für den Decode. Eine einzelne riesige Eingabe bremst die Antworten der anderen Nutzer dann nicht mehr aus.
Wie weit das gehen kann, zeigt das Paper «Prefill-as-a-Service» (Qin et al., arXiv 2604.15039). Es schlägt vor, lange Eingaben in eigenen, rechenstarken Rechenzentren zu verarbeiten und den KV-Cache über gewöhnliches Ethernet an die Decode-Rechner zu schicken. Die Autoren testeten das mit einem internen Modell von einer Billion Parameter. Der Durchsatz stieg um 54 Prozent, die Wartezeit bis zum ersten Token (P90, der Wert, den 90 Prozent der Anfragen unterbieten) sank um 64 Prozent. Das geht nach den Autoren, weil Modelle, die weniger Zwischenspeicher je Token brauchen, den KV-Cache stark verkleinern. Je kleiner der Cache, desto weiter lässt er sich bewegen.
Auch Moonshot AI (Kimi) macht den Cache zum Zentrum seiner Plattform Mooncake. Sie nutzt ungenutzten Arbeitsspeicher und SSD-Platz der eigenen Rechner. Im Produktivbetrieb verarbeitet das System nach Angabe der Autoren 75 Prozent mehr Anfragen (Mooncake-Paper, arXiv 2407.00079).
Die Stellschrauben des Betreibers
Ein Betreiber dreht an fünf Reglern gleichzeitig. Throughput ist die Gesamtleistung des Servers in Ausgabe-Tokens pro Sekunde über alle Nutzer. Output speed ist das Schreibtempo für einen einzelnen Nutzer. Memory ist der belegte Speicher. Queue delay ist die Wartezeit in der Warteschlange, bevor die Anfrage überhaupt bearbeitet wird. Time to first token ist diese Wartezeit plus die Zeit für den Prefill, also die Zeit bis zum ersten Wort. Die beiden hängen zusammen: Ein langer Prefill verlängert die Wartezeit der nächsten Anfragen. Jede Entscheidung verbessert einen Regler und verschlechtert einen anderen. Grössere Batches erhöhen den Durchsatz, verschlechtern aber alles, was der einzelne Nutzer spürt. Die Matrix zeigt drei typische Entscheidungen.
| Entscheidung | Throughput | Output speed | Memory | Queue delay | Time to first token |
|---|---|---|---|---|---|
| Mehr Nutzer pro Batch | besser mehr Tokens pro Stunde | schlechter jeder Nutzer langsamer | schlechter mehr KV-Cache | schlechter Warten auf einen Platz | schlechter erstes Wort später |
| Höhere Cache-Trefferquote | besser weniger Prefill-Arbeit | gleich Decode unverändert | schlechter Cache muss gehalten werden | besser weniger Last vor dem Start | besser Prefill entfällt teilweise |
| Prefill und Decode trennen | besser beide Seiten einzeln skalieren | besser grosse Eingaben bremsen nicht | schlechter KV-Cache wandert durchs Netz | gleich getrennte Warteschlangen | besser Prefill-Rechner nur für Eingaben |
Beim Caching sieht das Bild anders aus. Drei Regler werden besser, die Output speed bleibt gleich, und der Betreiber zahlt mit Memory. Darum geht es in diesem Beitrag: um den Speicher, den Engpass.
Warum der Modellhersteller im Vorteil ist
Wer ein Modell gebaut hat, kennt es bis ins Detail. Er schreibt dafür eigene Kernel, also Rechenprogramme, die mehrere Schritte zu einem verschmelzen und so weniger Daten zwischen Speicher und Rechenwerk hin und her schieben. Ein Dritter muss diese Engpässe erst finden und für jede Kartengeneration neu abstimmen.
Beim Preis ohne Cache-Treffer ist davon wenig zu erkennen. Wir vergleichen in Franken, mit dem Normaltarif von DeepSeek und zum EZB-Kurs vom 1. Oktober 2026 (1 US-Dollar = 0.8353 Franken), weil dieser Tarif knapp 80 Prozent der Woche gilt. Phoeniqs betreibt DeepSeek V4 Flash und verlangt 0.1462 Franken je Million Eingabe-Tokens und 0.3925 Franken je Million Ausgabe-Tokens. DeepSeek selbst nimmt 0.125 und 0.501 Franken. Die Eingabe ist bei Phoeniqs damit gut 15 Prozent teurer, die Ausgabe gut 20 Prozent günstiger. Der Abstand entsteht erst, wenn Eingaben wiederkehren.
Gemietete GPU statt Preis pro Token
Wer eine GPU mietet und keine Tokens einkauft, wird selbst zum Betreiber. Der Vermieter verdient gleich viel, ob die Karte nützliche Arbeit leistet oder zum hundertsten Mal dieselben 20’000 Tokens liest. Alles, was in diesem Beitrag für den Hoster gilt, gilt dann für den Mieter: Er trägt die Auslastung, den Speicher und den Cache. Jeder Cache-Treffer erspart der Karte Prefill-Arbeit und schafft Zeit für andere Anfragen. Der Mieter bekommt aus derselben Stunde mehr Antworten.
Den Effekt haben wir gemessen. Auf einer Karte lief Apertus-8B mit 8’000 Tokens geteiltem Kontext und acht Nutzern. Mit Prefix-Caching schaffte der Server 285.2 Tokens pro Sekunde, ohne 122.1. Das ist 2.3-mal mehr Durchsatz auf derselben Hardware, und die Wartezeit fiel von 17.9 auf 0.9 Sekunden.
Wie gross der Effekt ausfällt, hängt vom Anteil der Wiederholung an der Last ab. Bei kurzen Eingaben und langen Ausgaben bringt Caching wenig. Bei Agenten und bei Abfragen über lange gemeinsame Dokumente besteht der Grossteil der Eingabe aus Wiederholung.
Apertus: Warum sein Cache gross ist
Wie viel Speicher ein Gespräch im KV-Cache belegt, hängt von der Bauweise des Modells ab. Apertus 70B ist ein dichtes Modell mit 70 Milliarden Parametern, bei dem jedes Token mit allen Parametern rechnet. Es hat 80 Schichten und 8 KV-Köpfe, im Grundaufbau wie Llama 3. Je Token speichert es Schlüssel und Werte aller Schichten, das sind rund 320 Kilobyte (Zahlenformat BF16, gerechnet mit der Konfiguration von Apertus 1.0, die der 1.5-Modellkarte entspricht). Ein Gespräch mit 20’000 Tokens belegt damit rund 6.6 GB. Bei der maximalen Kontextlänge von 262’144 Tokens sind es rund 86 GB, mehr als eine Karte mit 80 GB fasst.
DeepSeek V4 kommt laut vLLM auf rund 10 Kilobyte je Token, weil seine Bauweise den Cache bewusst verkleinert. Apertus braucht also etwa das 30-Fache. Mit einem FP8-KV-Cache (8 Bit statt 16 Bit je Zahl) halbiert sich der Wert für Apertus. Der Abstand bleibt gross.
Dieser Speicher kostet Geld. In einem Terabyte Arbeitsspeicher haben rund 150 Gespräche mit Apertus 70B Platz (20’000 Tokens, ohne die Modellgewichte). Bei DeepSeek V4 sind es rund 5’000. Passen weniger Gespräche in den schnellen Speicher, muss ein Hoster öfter auf SSD ausweichen oder den Cache verfallen lassen.
Dazu kommt der Preis. Phoeniqs verlangt für Apertus 1.5 70B 0.6195 Franken je Million Eingabe-Tokens und 2.2201 für die Ausgabe, das ist das 4.2-Fache und das 5.7-Fache von DeepSeek V4 Flash bei Phoeniqs (0.1462 und 0.3925). DeepSeek V4 Flash ist ein Mixture-of-Experts-Modell (es besteht aus vielen Teilnetzen, von denen je Token nur wenige rechnen) mit 284 Milliarden Parametern, von denen 13 Milliarden je Token rechnen. Am grössten wird der Abstand bei wiederholter Eingabe: Ein Cache-Treffer kostet bei DeepSeek 0.0025 Franken je Million Tokens, Phoeniqs verlangt für Apertus 70B pauschal 0.6195 Franken, das 247-Fache (in der Spitzenzeit das 124-Fache). Bei 96.5 Prozent Treffern wie in unserer Coding-Session kostet die Million Eingabe-Tokens bei DeepSeek im Mittel 0.0068 Franken, Apertus bei Phoeniqs ist dann rund 91-mal teurer. Bei den 86 Prozent aus unserer eigenen DeepSeek-Rechnung sind es rund 31-mal. Die Coding-Session mit 50 Runden würde bei Apertus 7.98 Franken kosten, das 71-Fache von DeepSeek, und passt gar nicht hinein, denn das Kontextfenster endet bei 262’144 Tokens. Die Qualität der Modelle vergleichen wir dabei nicht.
Bauweisen, die den Cache verkleinern, gibt es. DeepSeek V4 zeigt eine, und laut vLLM lässt sich Prefix-Caching dabei weiter nutzen. Hybridmodelle, die verschiedene Aufmerksamkeitsverfahren mischen, verhalten sich anders, wie unsere Messreihe zeigt. Sie sparen KV-Speicher, aber vLLM schaltet das Prefix-Caching für sie ab. Das Apertus-Team sollte jede neue Bauweise gegen die Inferenz-Software testen, bevor das Training beginnt.
Was wir fordern
Drei Adressaten, drei konkrete Forderungen.
An die Hoster. Schreiben Sie den Preis für Cache-Treffer und die Haltedauer in die Preisliste. Melden Sie in jeder Antwort, wie viele Tokens Treffer waren, sonst lässt sich kein Preis dafür berechnen. Phoeniqs betreibt DeepSeek V4 Flash bereits, und der Preis ohne Treffer liegt im Bereich des Herstellers. Es fehlt der Cache-Preis.
An das Apertus-Team. Setzen Sie Kosten pro Token, aktive Parameter (die je Token rechnen) und die Grösse des KV-Caches je Token als Ziele der nächsten Generation, gleichrangig mit der Qualität. Prüfen Sie die Architektur in vLLM mit Prefix-Caching und Offloading, bevor das Training startet.
An Politik und Verwaltung. Wer KI als Grundinfrastruktur beschafft oder fördert, soll Cache-Preis und Haltedauer als Kriterium in die Ausschreibung schreiben. Wer die Forschung zu Apertus finanziert, soll auch die Software für den Betrieb bei vielen Nutzern mitfinanzieren: Cache-Speicher, Verteilung der Anfragen, Auslastung. Diese Software sollte offen sein, damit alle Schweizer Hoster sie nutzen können.
Für die Geschäftsleitung
Dieses Dossier als PDF
Den vollständigen Beitrag plus eine kompakte Management-Zusammenfassung und Checkliste, als PDF zum Speichern und Weiterleiten.
Sie erhalten das PDF sofort. Mit dem Absenden stimmen Sie zu, dass Souverana Sie zu diesem Thema kontaktieren darf. Verarbeitung in der Schweiz/EU, keine Weitergabe an Dritte, Widerruf jederzeit (revDSG).
Häufige Fragen
- Lohnt sich Prefix-Caching auch, wenn ich eine GPU miete statt pro Token zu zahlen?
- Ja, wenn die Last viel Wiederholung enthält. Wer eine GPU mietet, ist selbst der Betreiber: Der Vermieter verdient gleich viel, ob die Karte effizient arbeitet oder nicht, die Effizienz ist Sache des Mieters. Cache-Treffer sparen der Karte das Einlesen der Eingabe (Prefill) und lassen Platz für andere Anfragen. In unserer Messung mit Apertus-8B auf einer Karte (8'000 Tokens geteilter Kontext, acht Nutzer, Server-Software vLLM) stieg der Durchsatz von 122.1 auf 285.2 Tokens pro Sekunde.
- Genügt es für einen Hoster, Prefix-Caching in vLLM einzuschalten?
- Bei Agenten mit Pausen nicht. Die Server-Software vLLM hält den Cache im Grafikspeicher und räumt bei Platzmangel zuerst den Block weg, der am längsten ruht. Auf einem ausgelasteten Server kann der Cache eines Kunden nach einer Pause von Minuten verdrängt sein (nicht gemessen). Der Kunde kann das nicht beeinflussen, der Hoster braucht für längeres Halten mehr Speicher, etwa durch Auslagern (Offloading).
- Warum belegt Apertus 70B mehr Cache-Speicher als DeepSeek V4?
- Apertus 70B legt je Token rund 320 Kilobyte im KV-Cache ab, gerechnet mit der Konfiguration von Apertus 1.0 (80 Schichten, 8 KV-Köpfe, Kopfdimension 128, Zahlenformat BF16). DeepSeek V4 kommt laut vLLM-Blog vom 24. April 2026 auf rund 10 Kilobyte je Token, weil seine Bauweise den Cache verkleinert. Ein Gespräch belegt bei Apertus deshalb etwa 30-mal so viel Speicher.
Diesen Beitrag teilen
Fertig formatierte Grafiken und ein Textvorschlag für Ihren LinkedIn-Post: herunterladen, kopieren, posten.
Textvorschlag
Betreiben Sie einen eigenen LLM-Server oder wählen Sie einen Hoster, der Prompt Caching verspricht? Dann lohnt die Frage, wo der Cache liegt: Im Grafikspeicher einer Karte wird er verdrängt, sobald andere Nutzer Platz brauchen.

Der Test des LMCache-Teams mit 739 echten Claude-Code-Verläufen auf zwei AMD-MI300X-Karten zeigt, wann ein Zusatz-Cache im Arbeitsspeicher sich lohnt. Bei 8 Nutzern mit 32'000 Tokens Kontext lag der Betrieb nur mit Cache im Grafikspeicher vorn (52 gegen 25 abgeschlossene Anfragen). Bei 32 Nutzern mit 100'000 Tokens Kontext brachte LMCache 3.0-mal kürzere mittlere Wartezeit bis zum ersten Token und 2.3-mal mehr Anfragen. Passten alle Caches in den Grafikspeicher, kostete LMCache 10 bis 17 Prozent Durchsatz. Wir schliessen daraus, dass Offloading eine Frage der Auslastung ist und vor dem Einschalten gemessen gehört.

Im Beitrag: wie DeepSeek den Cache auf Festplatten betreibt, was ein Hoster neben dem Plugin sicherstellen muss, warum der KV-Cache von Apertus 70B etwa 30-mal grösser ist als der von DeepSeek V4 und was wir von Hostern und vom Apertus-Team fordern. Link in den Kommentaren.

#KI #LLM #Inferenz #Schweiz #Apertus