VRAM für LLM: so rechnen Sie vor dem Kauf richtig
Wie Sie aus Parameterzahl, Quantisierung, Kontextlänge und gleichzeitigen Anfragen ausrechnen, wie viel Grafikspeicher Sie brauchen. Mit Rechner und den Messwerten von zwei RTX 4090.
Technik · Veröffentlicht 14.08.2026 · Aktualisiert 14.08.2026 · Joel Barmettler
Wie viel VRAM braucht ein Sprachmodell?
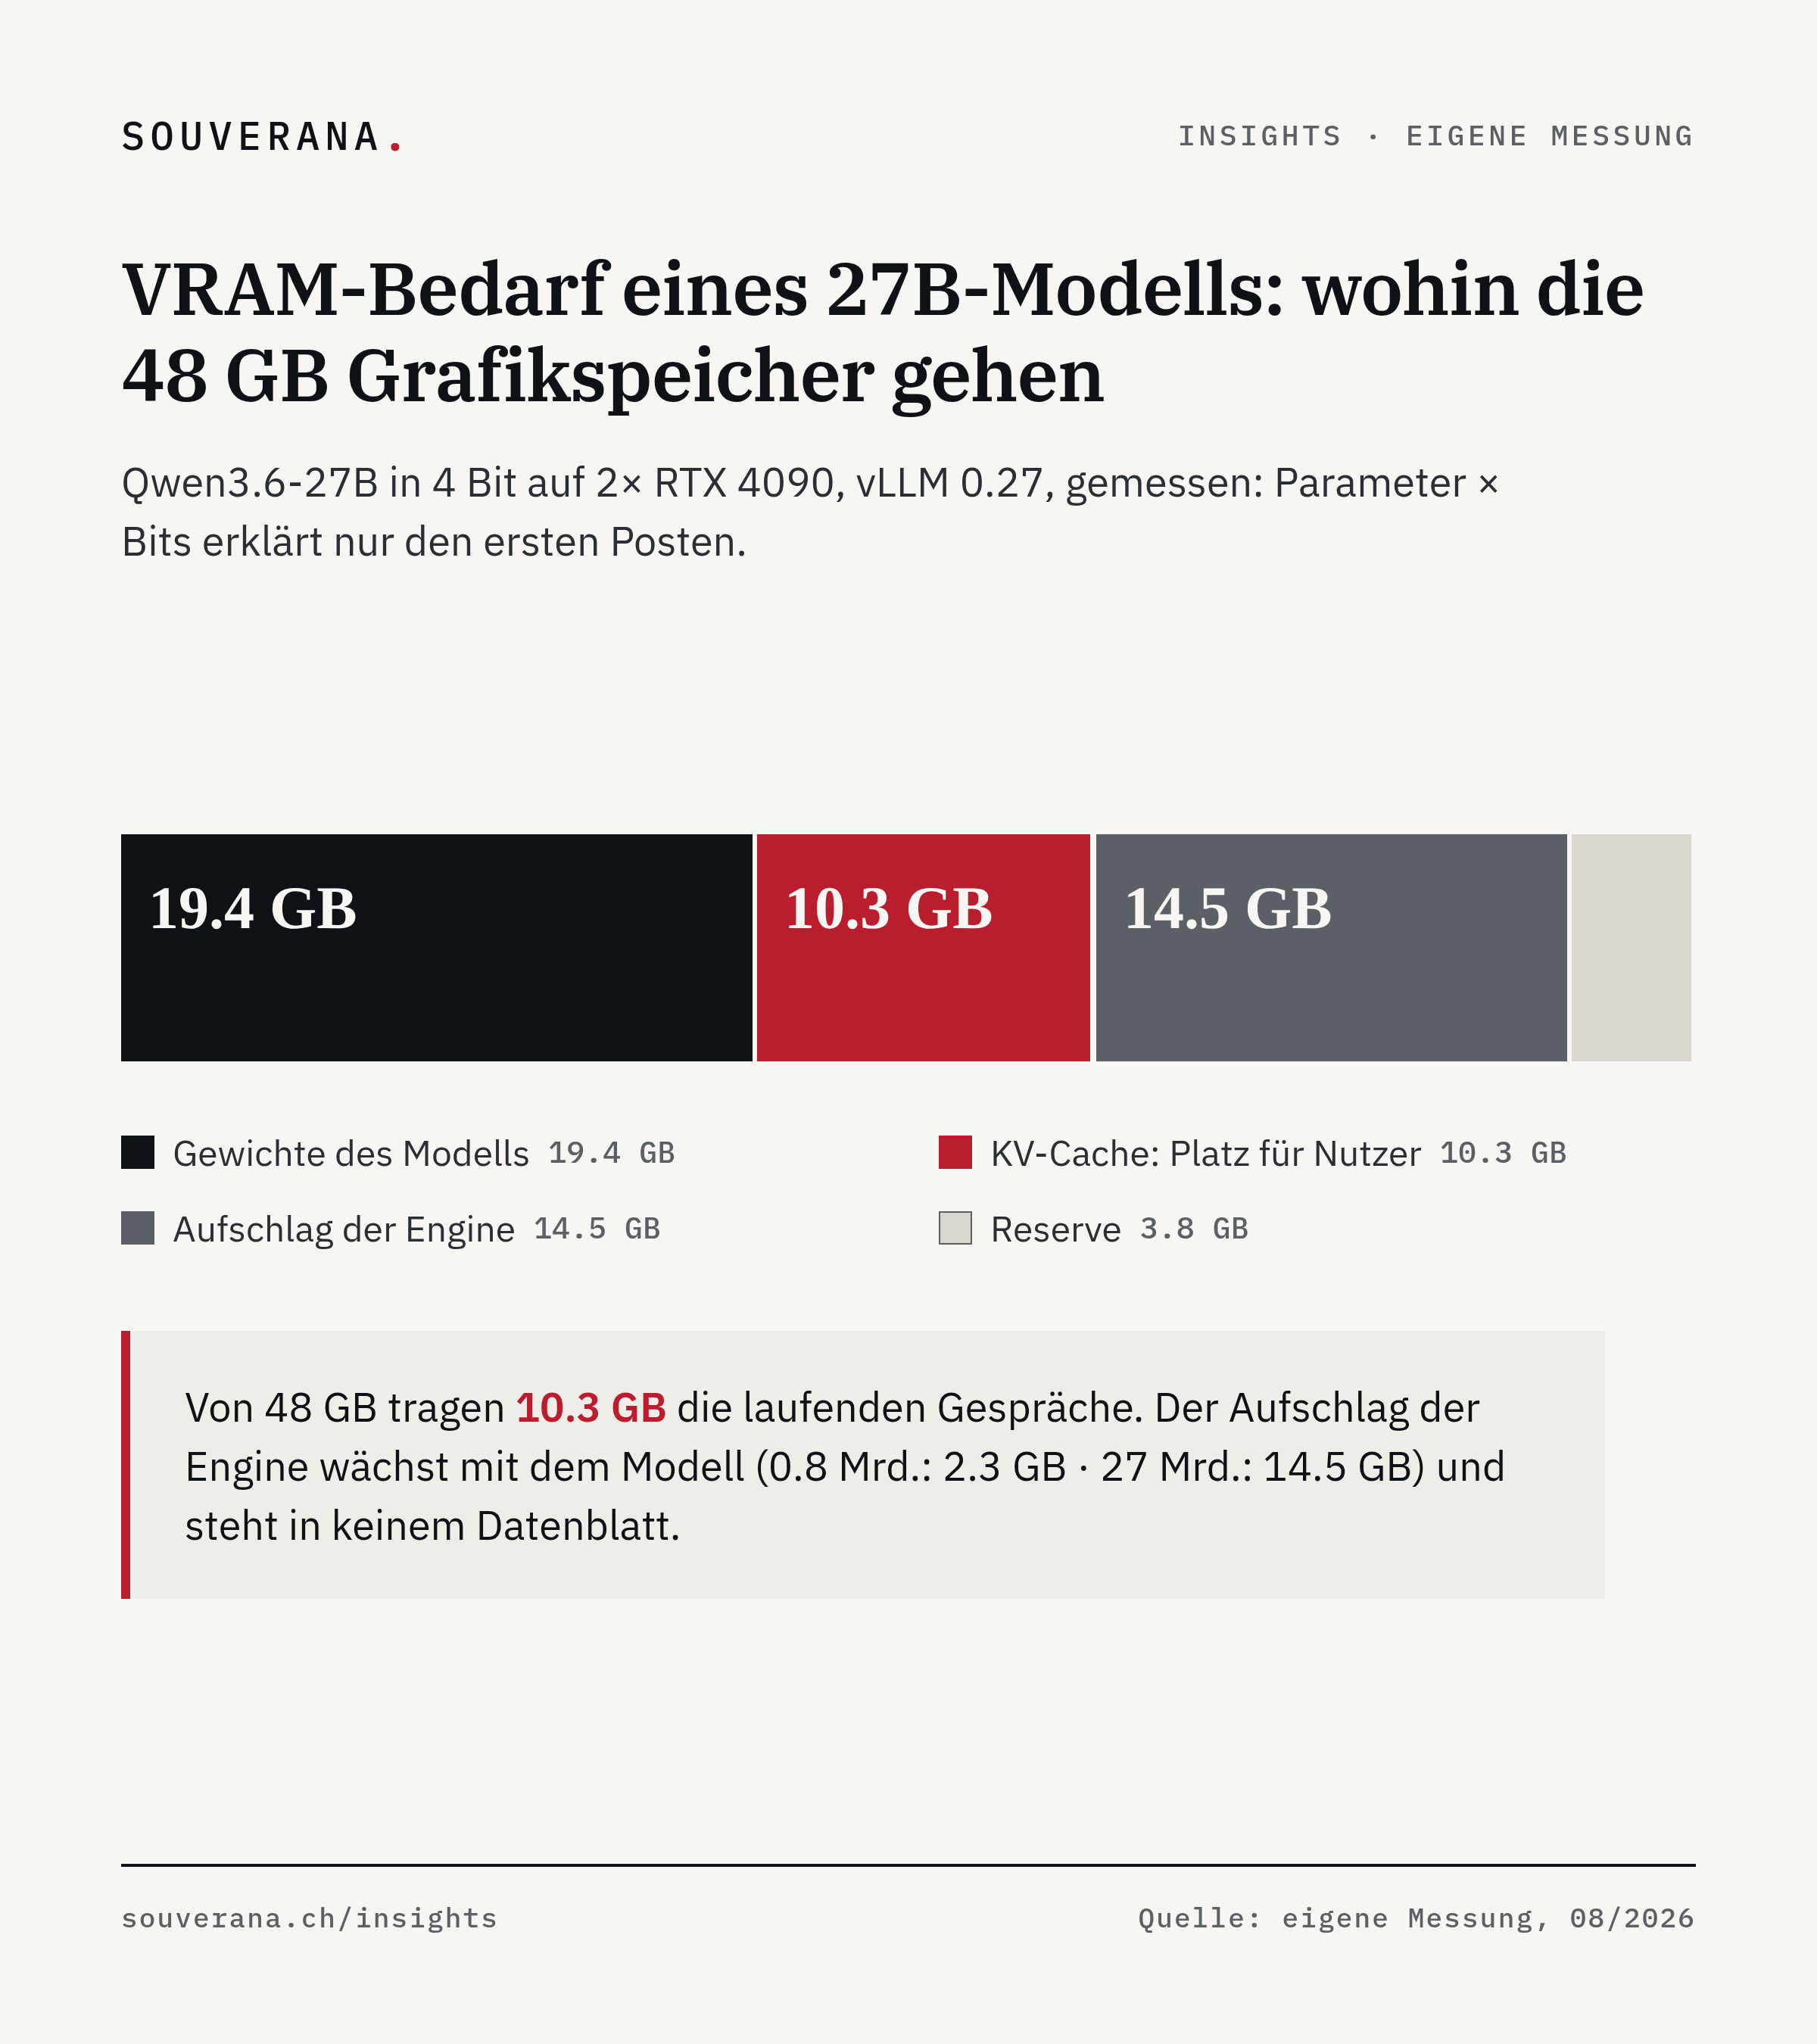
Der Grafikspeicher (VRAM) einer Maschine für lokale KI muss vier Posten tragen: die Modellgewichte, den KV-Cache (Zwischenspeicher für die laufenden Gespräche), den Aufschlag der Server-Software für Puffer und Rechenabläufe und eine Reserve. Bei einem Modell mit 27 Milliarden Parametern in 4 Bit Genauigkeit sind die Gewichte rund 19 GB, der Aufschlag allein rund 15 GB.
Das Wichtigste in Kürze
- Rechnen Sie den Aufschlag der Server-Software mit ein. Das ist der Speicher, den die Software für Puffer und Rechenabläufe belegt, die das Modell bereitstellt (hier vLLM). Er wächst mit dem Modell. Bei Modellen um 30 Milliarden Parameter sind es auf zwei Karten 13 bis 15 GB. Was er bei Ihnen beträgt, schreibt vLLM bei jedem Start ins Log.
- Die Kontextlänge, also die maximale Länge einer einzelnen Anfrage, ist Ihr grösster Hebel. Wer sie grosszügig setzt, macht aus einer Mehrbenutzermaschine einen Einzelplatz.
- Schalten Sie den KV-Cache auf FP8, also 8 statt 16 Bit je gespeichertem Wert. Das ist eine einzige Einstellung, und je nach Aufbau passen 37 bis 100 Prozent mehr Gespräche hinein.
- Prüfen Sie, wie viele Schichten eines Modells einen KV-Cache anlegen, bevor Sie Modelle nach Grösse vergleichen. Zwei ähnlich grosse Modelle können je Gespräch um Faktor drei auseinanderliegen.
- Lagern Sie Modellteile in den Arbeitsspeicher des Rechners aus, dann vollständig oder gar nicht. Ein bisschen auszulagern kostet je gespartem Gigabyte am meisten Tempo.
Wer eine Maschine für lokale Inferenz bestellt, legt sich für drei Jahre fest. Fällt die Rechnung zu klein aus, startet der Server im schlimmsten Fall gar nicht. Fällt sie zu grosszügig aus, stehen ein paar tausend Franken Grafikspeicher ungenutzt unter dem Schreibtisch. Die Frage «passt das Modell auf die Karte» klingt nach einer Ja-Nein-Frage und ist der teuerste Punkt der ganzen Planung.
Beantwortet wird sie meist mit einer Multiplikation: Parameter mal Bits. Diese Zahl ist ein Anfang, und sie liegt für die Planung unter dem tatsächlichen Bedarf.
Dies ist der zweite Teil unserer Serie über lokale Inferenz, also über KI-Modelle auf eigener Hardware. Der erste Teil beschrieb, was unsere Maschine leistet. Dieser Teil zeigt, wie Sie eine eigene Maschine auslegen.
Warum die Rechnung schwerer ist, als sie aussieht
Vier Grössen bestimmen den Bedarf, und keine davon lässt sich einzeln festlegen:
- die Modellgrösse, also wie viele Parameter überhaupt geladen werden
- die Quantisierung, also mit wie vielen Bits je Parameter
- die Kontextlänge, also wie lang eine einzelne Anfrage werden darf
- die gleichzeitigen Anfragen, also wie viele Gespräche parallel laufen
Die Hardware setzt die Grenze, in die diese vier passen müssen. Verändern Sie eine, verschieben sich die anderen. Wer die Kontextlänge vervierfacht, drittelt die Zahl gleichzeitiger Nutzer. Wer von FP8 (8 Bit je Parameter) auf 4 Bit geht, gewinnt ein Drittel des Platzes; die Antwortqualität blieb in unserer Messung dabei unverändert. Wer eine zweite Karte einbaut, gewinnt Nutzer und wird beim einzelnen Nutzer minim langsamer.
Ein Beispiel mit zwei Karten
Wir haben ein Modell mit 27.8 Milliarden Parametern in 4 Bit auf zwei RTX 4090 geladen und danach abgelesen, wie viel Platz für die Gespräche der Nutzer übrigblieb. Die Zeile «Erwartet» ist einfach die Differenz aus den ersten beiden Zeilen. Die Aufstellung sieht so aus:
| GB | |
|---|---|
| Auf beiden Karten vorhanden | 48.0 |
| Davon belegt das Modell | 19.4 |
| Erwartet für die Gespräche | 28.6 |
| Tatsächlich für die Gespräche verfügbar | 10.3 |
Zwischen den erwarteten 28.6 und den tatsächlich verfügbaren 10.3 GB liegen 18.3 GB. Die hat sich vLLM genommen, bevor das erste Gespräch begonnen hat. Wer also Parameter mal Bits rechnet und den Rest für seine Nutzer einplant, plant mit einem Speicher, den er nicht bekommt.
Wohin der Speicher geht
Vier Posten teilen sich die Karte, und nur der erste steht im Modellnamen: die Gewichte, der KV-Cache, der Aufschlag der Engine und die Reserve.
Erstens die Gewichte. Ihr Platzbedarf hängt allein an der Parameterzahl und an der Quantisierung. Aus unseren Läufen ergeben sich diese Werte:
| Format | GB je Milliarde Parameter |
|---|---|
| 4-Bit (AWQ, GGUF Q4) | 0.68 |
| FP8 | 1.02 |
| BF16, unquantisiert | 2.05 |
Für unser Beispiel: 27.8 Milliarden mal 0.68 ergibt 18.9 GB. Gemessen waren es 19.4. Die Formel trifft auf drei Prozent genau, das reicht für eine Planung.
Zweitens der KV-Cache, also der Platz für die laufenden Gespräche. Dass er mit der Textlänge und mit jeder gleichzeitigen Anfrage wächst, stand im ersten Teil. Neu ist hier, wie stark sich sein Platzbedarf zwischen zwei Modellen unterscheidet.
Ein Modell besteht aus übereinanderliegenden Schichten. Unser 27-Milliarden-Modell hat 64 davon, aber nur jede vierte legt einen KV-Cache an. Die übrigen 48 sind rekurrente Schichten: Sie führen einen Zustand fester Grösse mit und kosten deshalb nichts zusätzlich, wenn das Gespräch länger wird. Beim MoE-Modell derselben Familie fällt das Verhältnis noch günstiger aus. MoE steht für Mixture of Experts: Das Modell besteht aus vielen kleinen Teilnetzen, und je Token rechnen nur wenige davon. Das Modell 35B-A3B hat 35 Milliarden Parameter, von denen je Token rund 3 Milliarden rechnen.
| Modell | Schichten mit KV-Cache | KV je 1’000 Tokens |
|---|---|---|
| Qwen3.6-27B | 16 von 64 | 32 MB |
| Qwen3.6-35B-A3B | 10 von 40 | 10 MB |
Zwischen zwei Modellen derselben Familie liegt der Faktor drei. Acht Nutzer mit je 10’000 Tokens Kontext brauchen beim einen 2.6 GB, beim anderen 0.8 GB. Dieser Unterschied kann darüber entscheiden, ob eine Karte reicht.
Drittens der Aufschlag der Engine. Er besteht aus zwei Teilen. Der erste Teil sind die CUDA-Graphen, bei unserem Lauf 6.9 GB über beide Karten. vLLM zeichnet für einige Dutzend Batch-Grössen (so viele Anfragen werden gleichzeitig verarbeitet) je eine eingefrorene Abfolge der Rechenschritte auf, und dafür müssen die Zwischenergebnisse jeder Schicht an festen Adressen liegen. Der zweite Teil sind die Puffer für Aktivierungen (die Zwischenergebnisse der Schichten), den Zustand der 48 rekurrenten Schichten und den CUDA-Kontext, zusammen 7.6 GB. Beide Teile ergeben 14.5 GB, die belegt sind, bevor das erste Gespräch beginnt.
Viertens die Reserve. Wir starteten vLLM mit --gpu-memory-utilization 0.92,
es darf also 92 Prozent des Grafikspeichers belegen, und die restlichen 8 Prozent
(3.8 GB) rührt es nicht an. Diese Zahl wählen Sie selbst;
wo ihre Obergrenze liegt, steht bei den Fallen am Ende.
Zusammen ergeben Aufschlag und Reserve die 18.3 GB aus dem Beispiel oben.
Der Aufschlag wächst mit dem Modell. Wir haben zum Vergleich das kleinste Modell der Vorgängergeneration gestartet:
| Modell | Aufbau | Aufschlag der Engine |
|---|---|---|
| Qwen3.5-0.8B | eine Karte | 2.3 GB |
| Qwen3.6-27B | zwei Karten | 14.5 GB |
| Qwen3.6-35B-A3B | zwei Karten | 13.3 GB |
Der Platz für die Zwischenergebnisse wächst mit der Breite und der Tiefe des Modells, langsamer als die Parameterzahl: Das 27-Milliarden-Modell ist fünfmal breiter (Hidden-Dimension, also die Zahl der Werte je Token in einer Schicht: 5’120 gegen 1’024) und fast dreimal tiefer (64 gegen 24 Schichten) als das kleine, hat 35-mal mehr Parameter, aber nur rund achtmal mehr Speicher für die CUDA-Graphen (3.4 gegen 0.4 GB je Karte). Bei zwei Karten fallen die Puffer je Karte an. Für die Modellklasse dieser Serie rechnen Sie mit 13 bis 15 GB Aufschlag insgesamt.
Raten müssen Sie dabei nicht: vLLM, die Engine hinter allen Messungen dieser
Serie, schreibt die Aufteilung bei jedem Start ins Log, in der Zeile Actual usage is ... for peak activation, and ... for CUDAGraph memory. Dieses
Protokoll ist verlässlicher als jede Faustzahl, auch als unsere.
Rechnen Sie Ihren Fall durch
Aus den vier Posten und den gemessenen Konstanten wird eine Rechnung, die Sie für Ihre eigene Hardware anstellen können.
Zwei Beispiele zum Mitrechnen, die auch ohne den Rechner funktionieren. Beide verwenden dasselbe 27-Milliarden-Modell in 4 Bit.
Eine einzelne RTX 4090 mit 24 GB. Gewichte 19.4 GB, dazu Aufschlag und Reserve: Die Summe liegt weit über 24 GB. Mit Standardeinstellungen startet das nicht. In unseren Messungen lief dieses Modell auf einer Karte nur mit abgeschalteten CUDA-Graphen und verkleinerten Puffern, und selbst dann blieb Platz für nur 15’473 Tokens.
Zwei RTX 4090 mit zusammen 48 GB. Gewichte 19.4 GB, Reserve 3.8 GB, Aufschlag 14.5 GB: Für Gespräche bleiben 10.3 GB. Das reicht bei 10’000 Tokens je Anfrage für 33 gleichzeitige Anfragen. Dass die Rechnung hier exakt aufgeht, ist keine Kunst, denn die Konstanten stammen aus diesem Lauf. Die Probe ist das MoE-Modell: Dort sagt dieselbe Rechnung 7.8 GB voraus, und aus der gemessenen Token-Kapazität folgen 8.2 GB. Die Rechnung liegt damit fünf Prozent zu tief, also auf der vorsichtigen Seite.
Kontextlänge frisst gleichzeitige Nutzer
«Wir nehmen die volle Kontextlänge, dann sind wir für alles gerüstet» klingt vernünftig und kostet den ganzen Mehrbenutzerbetrieb.
Wir haben dieselbe Maschine und dasselbe Modell genommen und nur die eingestellte Kontextlänge verändert. Die letzte Spalte teilt den Platz für Gespräche durch den eingestellten Kontext: So viele Anfragen voller Länge passen gleichzeitig hinein.
| Eingestellter Kontext | Platz für Gespräche | Gleichzeitige volle Anfragen |
|---|---|---|
| 8’192 | 265’784 Tokens | 32.4 |
| 32’768 | 398’677 Tokens | 12.2 |
| 131’072 | 438’413 Tokens | 3.3 |
| 262’144 | 447’637 Tokens | 1.7 |
Der Platz für Gespräche wächst dabei sogar, um zwei Drittel. Es sinkt aber die Zahl voller Anfragen, die gleichzeitig hineinpassen: von gut 32 auf 1.7, weil jede einzelne Anfrage 32-mal länger sein darf. Wer die volle Kontextlänge freischaltet, bekommt für den Preis einer Mehrbenutzermaschine einen Einzelplatz.
Der KV-Cache lässt sich zudem in halber Genauigkeit führen, in FP8 statt FP16. Auf einer einzelnen Karte verdoppelte das die Kapazität exakt, von 3’920 auf 7’840 Tokens. Über den Kontext-Sweep auf zwei Karten fiel der Gewinn kleiner aus, zwischen Faktor 1.37 und 1.73; ein Grund dürfte der Zustand der rekurrenten Schichten sein, der bei der Umstellung nicht schrumpft, ganz erklären es unsere Logs aber nicht. Bei voller Kontextlänge wird FP8 für den KV-Cache ohnehin zur Bedingung, denn mit FP16-KV startete der Server dort gar nicht.
Eine Karte, zwei Karten
Der Sprung von einer auf zwei Karten wirkt in unseren Messungen dramatischer, als es die verdoppelte Speichermenge vermuten lässt.
Zum Aufbau: Beide Spalten liefen mit identischen Flags, allerdings mit einer anderen Kontexteinstellung als die Tabellen weiter oben. Deshalb steht hier 411’420 Tokens und in Anhang B 337’042 für dasselbe Modell auf denselben Karten. Vergleichen lässt sich nur, was in derselben Zeile steht; auch die Tempowerte stammen aus diesem Lauf und liegen deshalb unter denen aus dem ersten Teil. Der Platz ist in Tokens angegeben, weil das die Zahl ist, die der Server beim Start ins Log schreibt.
| Eine RTX 4090 | Zwei RTX 4090 | |
|---|---|---|
| Platz für Gespräche | 15’473 Tokens | 411’420 Tokens |
| Tempo bei einem Nutzer | 27.3 Tok/s | 23.2 Tok/s |
| Tempo bei vier Nutzern | 50.0 Tok/s | 82.0 Tok/s |
| Wartezeit bei vier Nutzern | 42.0 s | 3.0 s |
Faktor 26.6 beim Platz für Gespräche, obwohl sich der Speicher nur verdoppelt. Das liegt daran, dass auf einer Karte nach Gewichten, Aufschlag und Reserve fast nichts mehr übrig bleibt. Der freie Rest ist die Differenz zweier grosser Zahlen, und eine solche Differenz wächst überproportional, sobald die zweite Karte dazukommt.
Bemerkenswert ist die Zeile «Tempo bei einem Nutzer». Bei einem einzelnen Nutzer ist die zweite Karte langsamer, weil die Aufteilung eines Modells über zwei Karten Datenaustausch zwischen den Karten kostet, auf einem Consumer-Mainboard zudem über eine halbierte Anbindung. Wir haben unter Last nachgesehen: Die Karten liefen mit acht statt sechzehn PCIe-Lanes (den Datenleitungen zwischen Karte und Prozessor), weil sich zwei Steckplätze die Lanes der CPU teilen.
Wenn es nicht passt: die Regel für das Auslagern
Passt das Modell nicht in den Grafikspeicher, lässt sich ein Teil davon in den Arbeitsspeicher legen. Bei jeder Rechnung müssen diese Teile dann über die Leitung zur Karte wandern. Wie teuer das wird, hängt allein von der Bauart ab.
Bei einem Dense-Modell (einem Modell, das alle Parameter nutzt) bricht der Durchsatz ein. Wir haben 8 GB ausgelagert, und er fiel von 168.7 auf rund 7.4 Tokens pro Sekunde, also um Faktor 22. Der Grund ist die Rechenweise aus dem ersten Teil: Ein Dense-Modell braucht für jedes einzelne Token sämtliche Parameter, also wandert jeder ausgelagerte Wert bei jedem Token über die Leitung.
Bei einem MoE-Modell lohnt es sich. Dort fragt jedes Token nur wenige Experten an, und die selten gebrauchten dürfen im Arbeitsspeicher liegen bleiben:
| Ausgelagerte Schichten | Grafikspeicher | Durchsatz | Wartezeit |
|---|---|---|---|
| 0 | 23’012 MB | 236.5 Tok/s | 1.8 s |
| 8 | 19’472 MB | 96.7 Tok/s | 10.4 s |
| 16 | 15’760 MB | 64.1 Tok/s | 16.8 s |
| 24 | 12’046 MB | 49.1 Tok/s | 23.3 s |
| 48 (alle Experten) | 4’502 MB | 17.7 Tok/s | 47.4 s |
Werden alle Experten ausgelagert, läuft ein Modell mit 35 Milliarden Parametern in 4.5 GB Grafikspeicher, also in dem, was eine Einsteigerkarte mitbringt.
Die praktisch wichtigste Zeile ist aber die mit 8 ausgelagerten Schichten. Die ersten acht ausgelagerten Schichten kosten 59 Prozent des Durchsatzes und sparen 3.5 GB. Wer alles auslagert, verliert je gespartem Gigabyte weniger Tempo. Die Tabelle nennt den Verlust in Tokens pro Sekunde je gespartem GB:
| Ausgelagert | Kosten je gespartem GB |
|---|---|
| 8 Schichten | 40.4 Tok/s |
| 48 Schichten | 12.1 Tok/s |
Daraus folgt eine Regel, die dem Bauchgefühl widerspricht. Passt das Modell, lagern Sie nichts aus, weil jede ausgelagerte Schicht reiner Verlust ist. Passt es nicht, lagern Sie vollständig aus und nehmen das niedrigere Tempo in Kauf. Am meisten kostet es, schnell ein paar Schichten auszulagern, damit das Modell gerade noch passt: rund 140 Tokens pro Sekunde für 3.5 GB gesparten Speicher.
Vier Fallen, die uns je einen Anlauf gekostet haben
Neben der Speicherrechnung gibt es Einstellungen, an denen ein Start scheitern kann.
Der Bildschirm kostet ein Gigabyte. Mit --gpu-memory-utilization 0.96
startet vLLM auf einem Arbeitsplatzrechner nicht, weil die grafische Oberfläche
bereits rund ein Gigabyte belegt. Auf unserer Maschine war 0.94 die Obergrenze.
CUDA-Graphen lassen sich abschalten. --enforce-eager gibt die rund 7 GB
aus dem Aufschlag zurück und kostet Durchsatz. Das lohnt sich auf Maschinen,
auf denen der Platz knapper ist als das Tempo.
FP8-Gewichte brauchen eine Begrenzung der Anfragen. Die offiziellen FP8-Fassungen unseres Modells brachen mit einer Meldung über fehlende Mamba-Cache-Blöcke (Speicher für den Zustand der rekurrenten Schichten) ab, bis wir die Zahl gleichzeitiger Sequenzen auf 32 begrenzten. Die 4-Bit-Fassung brauchte das nicht.
Der FP8-KV-Cache braucht einen Compiler. Fehlt ninja im Container, startet
der Server sauber und beantwortet jede Anfrage mit einem Serverfehler, weil der
passende Kernel erst beim ersten Aufruf gebaut wird. Wer dann im Netzwerk sucht,
sucht lange.
Was das für Ihren Einkauf heisst
Stellen Sie die Rechnung als Summe auf: Gewichte plus KV-Cache plus der Aufschlag der Engine plus die Reserve. Passt die Summe nicht auf die Karte, hilft kein Optimismus beim KV-Cache.
Wählen Sie die Kontextlänge nach dem, was Ihre längsten echten Dokumente brauchen. Von 8’192 auf 262’144 Tokens fällt die Zahl gleichzeitiger Anfragen von 32 auf 1.7, und das ist der grösste Hebel im ganzen Aufbau.
Nehmen Sie den FP8-KV-Cache, sofern Ihre Karten ihn unterstützen. Bei voller Kontextlänge startet der Server sonst gar nicht.
Und wenn der Platz eng wird, hilft eine zweite Karte mehr als ein kleineres Modell: Sie ermöglicht mehr gleichzeitige Nutzer, und dafür wird eine solche Maschine meist angeschafft.
Als Checkliste vor dem Kauf ergeben sich daraus vier Schritte:
- 01
Die Rechnung als Summe aufstellen
Gewichte plus KV-Cache plus der Aufschlag der Engine plus die Reserve. Den Aufschlag für Ihr Modell verrät die Log-Zeile beim ersten Start.
- 02
Die Kontextlänge begrenzen
Auf das, was Ihre längsten echten Dokumente brauchen, plus Reserve. Jede Verdopplung darüber hinaus kostet gleichzeitige Nutzer.
- 03
Den Startversuch protokollieren
Halten Sie fest, mit wie viel freiem KV-Cache der Server startet. vLLM schreibt die Zahl ins Log, und sie ist Ihre echte Obergrenze für gleichzeitige Anfragen.
- 04
Die Konfiguration festhalten
Engine-Version, Speicherauslastung, Kontextlänge, KV-Präzision. Ohne diese vier Angaben ist eine Messung nicht wiederholbar, auch nicht die eigene.
Damit steht die Speicherrechnung. Wie stark Sie quantisieren dürfen, ohne dass die Antworten leiden, misst der dritte Teil der Serie; die Wahl der Engine und die Kostenrechnung folgen danach.
Für die Geschäftsleitung
Dieses Dossier als PDF
Den vollständigen Beitrag plus eine kompakte Management-Zusammenfassung und Checkliste, als PDF zum Speichern und Weiterleiten.
Sie erhalten das PDF sofort. Mit dem Absenden stimmen Sie zu, dass Souverana Sie zu diesem Thema kontaktieren darf. Verarbeitung in der Schweiz/EU, keine Weitergabe an Dritte, Widerruf jederzeit (revDSG).
Häufige Fragen
- Wie viel VRAM braucht ein Sprachmodell?
- Der Bedarf hat vier Posten: die Gewichte (rund 19 GB für ein 27-Milliarden-Modell in 4 Bit), der KV-Cache als Gesprächsspeicher, der Aufschlag der Server-Software für Puffer und aufgezeichnete Rechenabläufe (CUDA-Graphen, bei diesem Modell rund 15 GB) und eine einstellbare Reserve. Auf zwei RTX 4090 mit zusammen 48 GB blieben so 10 GB für die laufenden Gespräche.
- Was ist der KV-Cache?
- Der KV-Cache (Key-Value-Cache) ist der Zwischenspeicher, in dem ein Modell den bisherigen Verlauf eines Gesprächs hält. Er wächst mit der Textlänge und mit jeder gleichzeitigen Anfrage. Bei langen Eingaben kann er mehr Platz belegen als das Modell selbst. Er begrenzt in jedem Fall die Zahl gleichzeitiger Nutzer.
- Wie viel Grafikspeicher spart 4-Bit-Quantisierung?
- Gemessen belegt ein Modell je Milliarde Parameter 0.68 GB in 4 Bit, 1.02 GB in FP8 (8 Bit) und 2.05 GB unquantisiert. Von unquantisiert auf 4 Bit bleibt ein Drittel des ursprünglichen Bedarfs, und das entscheidet auf einer einzelnen Karte oft darüber, ob das Modell überhaupt passt.
- Bringt eine zweite Grafikkarte doppelt so viel?
- Beim Platz bringt sie weit mehr als das Doppelte. In unserer Messung stieg der Platz für laufende Gespräche von 15'473 auf 411'420 Tokens (Textbausteine), also um Faktor 26.6, weil auf einer Karte fast alles von Gewichten, Aufschlag und Reserve belegt war. Mit einem einzelnen Nutzer war die zweite Karte minim langsamer.
- Was bringt es, Teile des Modells in den Arbeitsspeicher auszulagern?
- Bei einem MoE-Modell (Mixture of Experts, je Token rechnen nur wenige Teilnetze) lohnt es sich: 35 Milliarden Parameter liefen bei uns in 4.5 GB Grafikspeicher, zum Preis von Faktor 13 beim Tempo. Bei einem Dense-Modell (alle Parameter aktiv) kostet das Auslagern von 8 GB den Faktor 22, weil jeder ausgelagerte Parameter für jedes Token über die Steckverbindung PCIe wandert.
Diesen Beitrag teilen
Fertig formatierte Grafiken und ein Textvorschlag für Ihren LinkedIn-Post: herunterladen, kopieren, posten.
Textvorschlag
Sie planen eine Maschine für lokale KI. Wie viel Grafikspeicher brauchen Sie wirklich?

Die übliche Antwort lautet: Parameter mal Bits. Für ein Modell mit 27 Milliarden Parametern in 4 Bit sind das 19.4 GB, und auf zwei Karten mit zusammen 48 GB klingt das nach reichlich Platz.

Gemessen mit der Server-Software vLLM 0.27 sieht die Aufteilung anders aus: 19.4 GB Gewichte, 14.5 GB Aufschlag der Software für Puffer und Rechenabläufe, 3.8 GB Reserve. Für alle laufenden Gespräche zusammen bleiben 10.3 GB. Der Aufschlag wächst mit dem Modell, von 2.3 GB bei 0.8 Milliarden Parametern auf 14.5 GB bei 27 Milliarden, und er steht in keinem Datenblatt. vLLM schreibt ihn bei jedem Start ins Log.

Unser Schluss: Wer souverän hosten will, dimensioniert selbst. Rechnen Sie alle vier Posten ein, sonst kaufen Sie eine Maschine, auf der zwar das Modell liegt, aber kaum jemand damit arbeiten kann.

Im Beitrag stehen ein Rechner zum Selbernachrechnen, der Effekt der Kontextlänge und die Messung dazu, warum halbes Auslagern in den Arbeitsspeicher selten lohnt. Link in den Kommentaren.

#KI #LLM #Hardware #Schweiz