Personendaten schützen bei Entwicklung, KI-Agenten und Chat
Personendaten verlassen das geschützte System auf verschiedenen Wegen: als Testkopie für Entwickler, über einen KI-Agenten mit Datenbankzugang oder im Chat mit einem Cloud-Modell. Der Beitrag zeigt für jeden Weg, wo man die Daten am besten schützt und welche Werkzeuge es dafür gibt.
Analyse · Veröffentlicht 11.11.2026 · Aktualisiert 11.11.2026 · Joel Barmettler
Wo Personendaten verschwinden sollten, bevor Entwickler, Agenten oder Cloud-Modelle sie sehen
Erhalten ein Entwicklungsteam, ein KI-Agent oder ein Cloud-Modell Zugriff auf Kundendaten, sehen die Empfänger schnell mehr als nötig. Wie viel, hängt davon ab, an welcher Stelle das Unternehmen die Personendaten entfernt. Es gibt fünf solche Stellen, von der bereinigten Kopie der Datenbank bis zum Modell im eigenen Betrieb. Jede passt vor allem zu einem bestimmten Empfänger.
Die ersten beiden Teile dieser Serie haben gezeigt, wie leicht sich Menschen auch in Daten ohne Namen erkennen lassen und was das Gesetz verlangt, bevor solche Daten das Haus verlassen. Das Beispiel der Serie bleibt eine Hausarztpraxis im Knonaueramt mit der Patientin Hildegard Kaufmann, 87, aus Maschwanden. Praxis und Patientin sind erfunden. Offen ist die technische Frage: An welcher Stelle im Datenfluss lassen sich die Personendaten am besten entfernen? Darauf gibt es keine einzelne Antwort, weil die Empfänger verschieden sind. Der Hersteller der Praxissoftware braucht für Tests eine Datenbank, die sich wie die echte verhält. Ein KI-Agent für die Praxisverwaltung schreibt die Abfragen selbst. Ein Chat, in dem die Ärztin Arztbriefe formulieren lässt, erhält ganze Briefe mit Namen und Diagnosen mitten im Satz.
Dieser Beitrag geht die fünf Stellen der Reihe nach durch, mit Werkzeugen, Stärken und Grenzen. Eine Grafik pro Stelle zeigt, was in der Praxis bleibt und was nach aussen geht. Danach folgt eine Matrix, welche Stelle zu welchem Anwendungsfall passt.
Erste Stelle: eine maskierte Kopie der Datenbank
In der Praxis
Grenze
Ausserhalb
Nur die maskierte Kopie geht an den Hersteller der Praxissoftware. Die echte Praxisdatenbank bleibt in der Praxis.
Die statische Maskierung erzeugt eine Kopie der Produktionsdatenbank, in der Ersatzwerte stehen. Namen werden durch andere Namen ersetzt, AHV-Nummern durch andere gültige AHV-Nummern, Beträge leicht verändert. Die Kopie geht an das Entwicklungsteam, an ein Testsystem oder an einen Dienstleister. Die Produktion bleibt unberührt. In der Kopie für den Hersteller der Praxissoftware trägt Hildegard Kaufmann einen anderen Namen und eine andere AHV-Nummer.
Für PostgreSQL gibt es zwei verbreitete Open-Source-Werkzeuge. PostgreSQL Anonymizer von der französischen Firma Dalibo legt die Regeln direkt in der Datenbank fest und kann neben statischen Kopien auch maskierte Exporte erzeugen.[1] Greenmask arbeitet beim Export und kann Werte so ersetzen, dass derselbe Originalwert denselben Ersatz erhält. So passen die Tabellen weiterhin zueinander.[2] Für grössere Umgebungen mit mehreren Datenbanksystemen bieten kommerzielle Anbieter wie Tonic, Perforce Delphix, DATPROF oder Redgate Plattformen für Testdaten an.[3–6]
Die Stärke dieses Musters: Wer die Kopie erhält, sieht in den geregelten Spalten keine echten Werte, unabhängig davon, welche Abfragen der Empfänger schreibt. Die Schwäche: Jede Spalte braucht eine Regel. Kommt eine neue Spalte dazu und niemand ergänzt die Regel, gelangt die neue Spalte unverändert in die Kopie.
Warum es nicht reicht, die Spalten einzeln zu ersetzen
Der naheliegende Weg ist, jede Spalte für sich zu ersetzen oder die Werte einer Spalte zwischen den Personen zu mischen. Wir haben diesen Weg und einen konsistenten Ersatz mit einem eigenen Prototyp gemessen, an einer erfundenen Praxisdatenbank: 2’500 Patientinnen und Patienten aus den 14 Gemeinden des Bezirks Affoltern, rund 18’000 Konsultationen mit Notizen und ebenso viele Rechnungen.[7] Hildegard Kaufmann ist eine der Patientinnen. Die Tabelle zeigt Hildegard Kaufmann und einen zweiten Patienten in drei Fassungen.
In der gemischten Kopie stimmte nur noch bei 0.06 Prozent der Rechnungen der Betrag mit Taxpunkten mal Taxpunktwert überein. Keine der 1’539 E-Mail-Adressen passte mehr zum Namen. Eine Software, die solche Werte prüft, schlägt im Test Alarm, obwohl der Fehler in den Testdaten liegt. Schwerer wiegt der Datenschutz: Durch das Mischen verschwindet kein Wert. Alle 2’500 echten AHV-Nummern und 3’419 echte Namen in den Notizen stehen weiterhin in der Kopie, nur bei anderen Personen.
In der konsistent pseudonymisierten Kopie passte der Betrag bei allen rund 18’000 Rechnungen zu Taxpunkten und Taxpunktwert. Alle 1’539 E-Mail-Adressen passten zum neuen Namen. Alle Verknüpfungen blieben gültig, jede Konsultation hing weiterhin an derselben, neu benannten Person.
Was eine brauchbare Kopie leisten muss
Aus der Messung folgen fünf Anforderungen. Ein Unternehmen kann die Anforderungen von einem Werkzeug oder vom Dienstleister verlangen, der die Kopie herstellt.
- Gleicher Wert, gleicher Ersatz. Eine Patientennummer braucht in jeder Tabelle denselben Ersatz, sonst passen Konsultationen und Rechnungen nicht mehr zusammen. Der Ersatz wird dafür aus dem echten Wert und einem geheimen Schlüssel berechnet, meist mit dem Verfahren HMAC. Ein einfacher Hashwert ohne Schlüssel genügt nicht: Wer eine Liste möglicher AHV-Nummern hat, rechnet die Hashwerte nach und findet die echten Nummern. Der EDÖB empfiehlt deshalb einen Hash mit geheimem Schlüssel.[8] Der Schlüssel liegt getrennt von der Kopie.
- Eine Ersatzperson pro Mensch, auch im Freitext. Name, E-Mail-Adresse und Erwähnungen in Notizen bekommen dieselbe erfundene Person. Von den 12’068 Notizen, die den Nachnamen der eigenen Patientin oder des eigenen Patienten nennen, enthielt in der Kopie keine mehr den echten Nachnamen.
- Gültige Nummern. AHV-Nummer und IBAN tragen Prüfziffern, die viele Programme bei der Eingabe prüfen. Die Ersatznummer entsteht deshalb mit einer formaterhaltenden Verschlüsselung und einer neu berechneten Prüfziffer. In der Kopie waren alle 2’500 AHV-Nummern gültig.
- Zusammengehörige Werte gemeinsam behandeln. Taxpunkte, Taxpunktwert und Betrag werden als Paket mit einer anderen Rechnung desselben Jahres und desselben Gesetzes (KVG oder UVG) getauscht. Geburtsdaten und Termine einer Person werden um denselben Betrag verschoben. Das hat einen Preis: Der Betrag gehört danach zu einer anderen Konsultation. Bei 4.6 Prozent der Konsultationen rutschte das verschobene Datum in die Zukunft.
- Ein Prüfbericht nach jedem Lauf. Ein Programm sucht in der fertigen Kopie nach echten Werten. Der Bericht zeigt, wo Regeln fehlen. In unserer Kopie standen noch 164 AHV-Nummern ohne Punkte und 272 Telefonnummern in der Schreibweise mit 0 statt +41, weil die Regeln diese Schreibweisen nicht kannten. Dazu kamen 116 vollständige Namen von Angehörigen. Diese Fälle haben wir absichtlich in die erfundenen Notizen eingebaut, um die Grenze der Regeln zu messen. Wie oft solche Schreibweisen in echten Notizen vorkommen, zeigt erst der Bericht über die eigene Datenbank. Solche Reste findet ein Erkennungsmodell wie beim Proxy weiter unten oder ein Mensch, der eine Stichprobe liest.
Die Regeln stehen pro Spalte in einer lesbaren Datei, die ein Mensch freigibt. Dieselbe Quelle, dieselben Regeln und derselbe Schlüssel ergeben dieselbe Kopie: Zwei Läufe unseres Prototyps lieferten eine bytegleiche Datenbank.
Warum die Kopie trotzdem nicht anonym ist
In der Kopie trägt Hildegard Kaufmann einen anderen Namen, finden lässt sich Hildegard Kaufmann trotzdem. Geschlecht, Geburtsdatum und Gemeinde bleiben in der Kopie, weil der Hersteller mit realistischen Altersangaben und Wohnorten testen will. Über Geschlecht, Geburtsjahr und Gemeinde lagen in der Kopie 86 Prozent der Patientinnen und Patienten in Gruppen von weniger als fünf Personen, fast gleich viele wie im Original. Das verschobene Geburtsdatum half wenig. Wer weiss, dass Hildegard Kaufmann am 14. März 1939 geboren ist, sucht Frauen aus Maschwanden mit einem Geburtsdatum bis 180 Tage davor oder danach. Wir haben die Kopie mit 1’000 verschiedenen Schlüsseln erzeugt: Die Suche fand jedes Mal eine oder zwei Frauen. Bei allen 1’000 Schlüsseln war die einzige gefundene Frau mit Herzinsuffizienz Hildegard Kaufmann. Dazu kommt die Hausnummer: Die Regel ersetzte den Strassennamen und behielt die Nummer. Als einzige Frau in Maschwanden mit dieser Hausnummer blieb Hildegard Kaufmann eindeutig.
Erst gröbere Angaben ändern das. Mit Altersgruppen von fünf Jahren und dem Bezirk statt der Gemeinde lag in der Kopie niemand mehr in einer Gruppe unter fünf Personen. Für viele Tests reicht diese Genauigkeit, für Auswertungen nach Gemeinde nicht. Wie man misst, ob eine Vergröberung genügt, zeigt der erste Teil dieser Serie.
Für die Praxis, die den Schlüssel aufbewahrt, bleibt die Kopie Personendaten. Ob die Kopie auch für den Hersteller Personendaten enthält, hängt nach dem zweiten Teil davon ab, ob der Hersteller Personen mit vertretbarem Aufwand wiedererkennen kann. Bei Hildegard Kaufmann genügen dafür Geschlecht, Gemeinde, Geburtsdatum und Diagnose. Ein Mitarbeiter des Herstellers, der Hildegard Kaufmann aus dem Gemeindeblatt oder aus der Nachbarschaft kennt, findet die Zeile. Solange das möglich ist, gehört die Kopie unter einen Vertrag zur Auftragsbearbeitung nach Art. 9 revDSG. Für Patientendaten gilt zusätzlich das Berufsgeheimnis (Art. 321 StGB). Welche Wege es für die Weitergabe trotzdem gibt, beschreibt der zweite Teil.
Zweite Stelle: eine Maske bei jeder Abfrage
In der Praxis
Grenze
Ausserhalb
Keine Kopie verlässt die Praxis. Für Externe reicht die Maske nicht: Wer selbst Abfragen schreibt, kann verdeckte Werte erschliessen.
Eine Maske direkt an der echten Praxisdatenbank verdeckt bei jeder Abfrage, was eine Rolle nicht sehen darf, zum Beispiel die Diagnosen am Empfang.
Die dynamische Maskierung lässt die Daten unverändert. Erst wenn ein bestimmter Nutzer abfragt, zeigt die Datenbank eine Maske, etwa «XXXX» anstelle einer Telefonnummer. SQL Server und Azure SQL nennen das Dynamic Data Masking, Oracle spricht von Data Redaction, PostgreSQL Anonymizer bietet die dynamische Maskierung ebenfalls an.
Das ist bequem, weil keine Kopie nötig ist. Die Hersteller beschreiben aber selbst die Grenze. In der Dokumentation von Microsoft steht, wer selbst Abfragen stellen darf, könne mit geschickten Abfragen an die echten Daten gelangen. Die Maskierung verhindere versehentliche Einblicke, schütze aber nicht vor gezielten Versuchen, die Werte herauszufinden.[9] Die Dokumentation zeigt an einem Beispiel, wie das geht: Eine Abfrage mit der Bedingung «Lohn grösser als 99’999 und kleiner als 100’001» findet die Person mit genau diesem Lohn, obwohl der Lohn maskiert angezeigt wird. Oracle hält dasselbe fest: Data Redaction schütze nicht vor Nutzern, die Werte durch wiederholte Abfragen herausfinden.[10]
Für ein Entwicklungsteam oder einen KI-Agenten, der Abfragen selbst schreibt, ist die dynamische Maskierung deshalb kein ausreichender Schutz. Für ein Dashboard, in dem das Praxisteam fertige Auswertungen liest, kann die dynamische Maskierung genügen. Was eine Person am Bildschirm sehen darf, kann sie trotzdem weitergeben, etwa an ein Cloud-Modell. Davor schützt erst der Proxy an der vierten Stelle.
Dritte Stelle: eine Teilmenge oder synthetische Daten
In der Praxis
Grenze
Ausserhalb
Nach aussen gehen nur neu erzeugte Datensätze. Ob darin seltene echte Kombinationen wieder auftauchen, muss trotzdem eine Messung zeigen.
Oft braucht ein Testsystem nicht alle Millionen Datensätze. Eine Teilmenge reicht, solange die Verknüpfungen stimmen: Zu jeder Konsultation gehört die Patientin, zu jeder Patientin die Adresse. Werkzeuge wie das Open-Source-Programm Jailer schneiden eine solche Teilmenge aus und halten die Fremdschlüssel intakt.[11] Auch diese Teilmenge muss anschliessend maskiert werden, weil die Teilmenge echte Personen enthält.
Synthetische Daten gehen einen Schritt weiter. Ein Generator lernt die Verteilungen und Zusammenhänge der echten Daten und erzeugt neue Datensätze, die keiner echten Person entsprechen. Bekannte Bibliotheken sind SDV von DataCebo unter einer Business Source License sowie das Software Development Kit von MOSTLY AI, das seit 2025 unter einer Open-Source-Lizenz steht.[12, 13]
Synthetische Daten eignen sich gut für Entwicklung und Tests. Für Auswertungen sind synthetische Daten nur bedingt brauchbar, weil seltene Fälle und Einzelwerte nicht verlässlich nachgebildet werden. Lernt ein Generator die Originaldaten zu genau, kann der Generator echte Datensätze wiedergeben. Deshalb muss auch hier gemessen werden, ob seltene Kombinationen aus den Originaldaten im Ergebnis wieder auftauchen.
Vierte Stelle: ein Proxy vor dem Sprachmodell
In der Praxis
Grenze
Ausserhalb
Das Cloud-Modell erhält den Arztbrief mit Platzhaltern statt Namen und Nummern. Die echten Werte setzt der Proxy erst in der Antwort wieder ein.
Bei Chat und Dokumenten geht Text an ein Sprachmodell. Dafür gibt es Proxys: Programme, die zwischen Anwendung und Modell sitzen. Diese Programme erkennen Namen, Nummern und Adressen im Text, ersetzen die Angaben durch Platzhalter wie «PERSON_1» und schicken nur den bereinigten Text an das Modell. Kommt die Antwort zurück, setzen die Programme die Originalwerte wieder ein.
Ein verbreitetes Open-Source-Werkzeug dafür ist Presidio. Presidio wurde bei Microsoft entwickelt und wird seit Juni 2026 als unabhängiges Gemeinschaftsprojekt weitergeführt.[14] Presidio kann die ersetzten Originalwerte verschlüsseln und später wieder entschlüsseln. Standardmässig ist Presidio aber auf Englisch eingestellt. Andere Sprachen muss man eigens einrichten.[15, 16] Speziell für die Schweiz gibt es gheim. Der Gründer von Souverana hat dieses Open-Source-Werkzeug entwickelt, wir sind bei gheim also nicht unabhängig. gheim bringt ein Erkennungsmodell mit, das auf Texten in den vier Landessprachen trainiert ist.[17]
Wir zeigen den Rundweg mit Presidio, eingestellt wie im Projektvergleich weiter unten: mit dem Erkennungsmodell GLiNER und Regeln für Schweizer Formate. Getestet haben wir zwei erfundene Beispiele aus der Praxis: einen kurzen Arztbrief über Hildegard Kaufmann und drei Zeilen aus der Patientenliste. Weil das Erkennungsmodell nicht bei jedem Lauf gleich entscheidet, haben wir jedes Beispiel zehnmal gerechnet. Die Grafik zeigt, was der Proxy erkannt und an das Modell geschickt hat.
Im Arztbrief ersetzte Presidio Name, Geburtsdatum, Wohnort, AHV-Nummer und Telefonnummer. Ersetzt wurden auch der Monat «Oktober» und das Wort «Patientin», das Presidio als Name einordnete. Die Diagnose ging im Klartext an das Modell, weil diese Einstellung keine Regel für Gesundheitsangaben enthält. Die Antwort kommt mit den Originalwerten zurück. Bei den Patientenzeilen zeigt sich die Grenze. Der Proxy beurteilt jeden Wert einzeln. In 8 von 10 Läufen ersetzte Presidio nur die Geburtsdaten. Gemeinde, Geschlecht und Diagnose blieben stehen. In 2 Läufen ersetzte Presidio zusätzlich zweimal «Maschwanden», als Name eingeordnet. Ob eine Kombination selten ist und eine Person verrät, kann der Proxy nicht beurteilen. Dafür müsste der Proxy die ganze Tabelle und die Bevölkerung der Gemeinde kennen, zum Beispiel, dass in Maschwanden laut Bundesamt für Statistik genau eine Frau des Jahrgangs 1939 lebt. Zudem fehlt dem Modell nun das Geburtsdatum: Fragen nach dem Alter kann das Modell nicht mehr beantworten. Je nach Einstellung ersetzt ein Proxy in Tabellen also zu wenig oder so viel, dass die Auswertung leidet. Für Tabellen gibt es mit Presidio Structured, einem Zusatz zu Presidio, einen Ansatz, der Spalten nach Name und Inhalt einordnet.[18] Die Frage, welche Kombinationen selten sind, beantwortet aber erst eine Messung wie im ersten Teil dieser Serie.
Wie zuverlässig der Proxy Personendaten findet
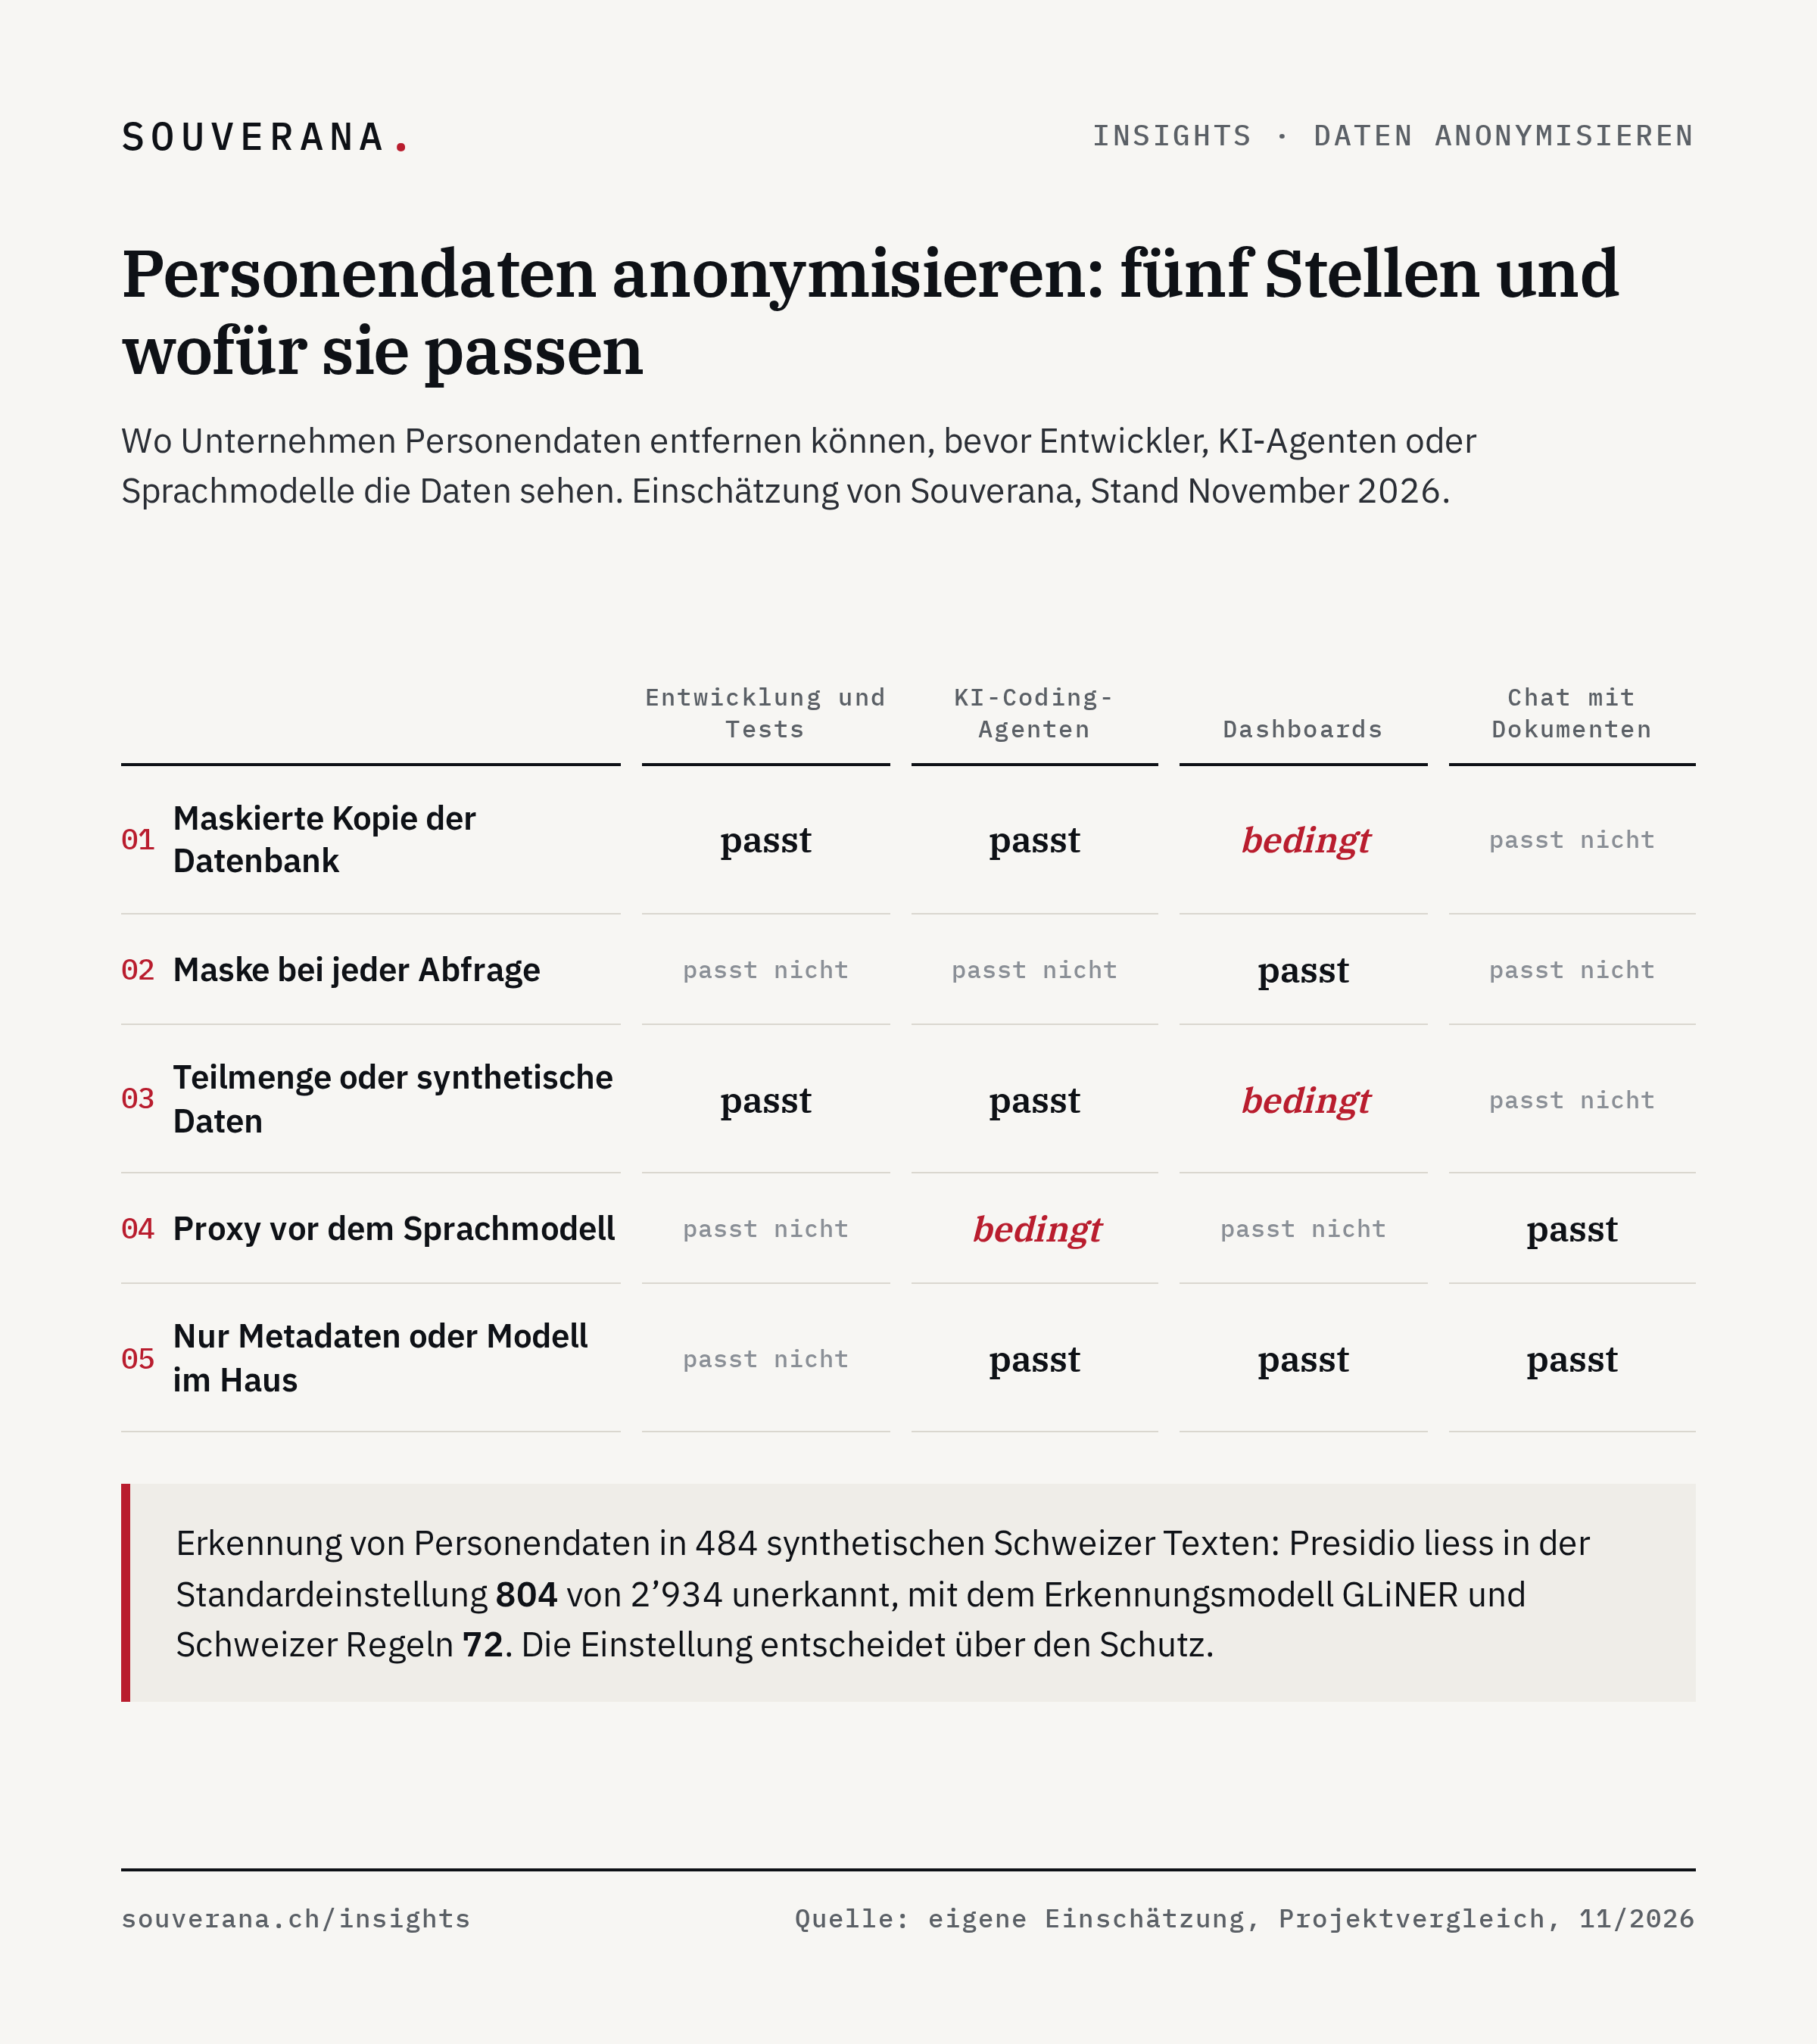
Ein Proxy schützt nur, was seine Erkennung findet. Wie viel die Einstellung ausmacht, zeigt ein Projektvergleich auf 484 synthetischen Schweizer Texten mit 2’934 Personendaten wie Namen, AHV-Nummern, Adressen und IBAN. Geburtsdaten sind darin nicht mitgezählt.[19] Der Vergleich ist nicht öffentlich.
Kennzahl
804 → 72Quelle: Projektvergleich Oktober 2026, nicht öffentlich
In der Standardeinstellung liess Presidio gut jede vierte Angabe unerkannt. Mit dem Erkennungsmodell GLiNER und Regeln für Schweizer Formate wie AHV-Nummern, Fallnummern und Geburtsdaten waren es weniger als 3 von 100. Die Regeln wurden mit Kenntnis der Testtexte geschrieben, die zweite Zahl fällt deshalb eher günstig aus. Für den eigenen Einsatz heisst das: Die Regeln für Schweizer Formate muss das Unternehmen selbst einrichten. Wie viel der Proxy übersieht, zeigt erst eine Messung an zwanzig bis fünfzig eigenen Beispielen, bevor echte Daten durch den Proxy gehen.
Fünfte Stelle: Das Modell sieht nur den Aufbau oder läuft im Haus
In der Praxis
Grenze
Ausserhalb
Kein Modellanbieter erhält Patientendaten.
Das eigene Modell arbeitet mit echten Werten, ohne dass Patientendaten die Praxis verlassen. Zugriffsrechte regeln, wer im Praxisteam was sieht.
Eine Variante: Das Modell sieht nur den Aufbau der Datenbank, also Tabellennamen, Spalten und Beispiele mit erfundenen Werten. Daraus schreibt das Modell die Abfrage, ausgeführt wird die Abfrage im eigenen System. Die Werte selbst bleiben in der Datenbank, das Modell sieht nur den Aufbau der Datenbank. Für Auswertungen und Dashboards bietet sich das an.
Die andere Variante: Ein Modell im eigenen Betrieb sieht die echten Werte. Weil die Daten im Haus bleiben, entfällt die Anonymisierung für einen Modellanbieter. Offene Modelle wie das Schweizer Apertus lassen sich auf eigener Hardware oder bei einem Schweizer Hoster betreiben. Wer im Haus auf das Modell zugreift, sieht die echten Werte. Die Zugriffsrechte legen deshalb fest, wer das Modell nutzen darf.
Welche Stelle zu welchem Anwendungsfall passt
Die fünf Stellen lassen sich kombinieren, in der Praxis braucht ein Unternehmen oft zwei oder drei. Die Matrix zeigt unsere Einschätzung für vier typische Anwendungsfälle. Wählen Sie einen Fall, um die Begründungen zu lesen.
Ob eine bereinigte Kopie oder ein Export anonym genug ist, prüfen Werkzeuge auf das Risiko der Re-Identifikation. Das Open-Source-Programm ARX berechnet unter anderem k-Anonymität, l-Diversität und Differential Privacy.[20] Das R-Paket sdcMicro stammt aus der amtlichen Statistik und schätzt, wie gross die Gefahr ist, dass sich einzelne Personen in einem Datensatz wiedererkennen lassen.[21] Für Text bleibt Presidio eine verbreitete offene Wahl, mit den Grenzen, die weiter vorne beschrieben sind.
So starten Sie
- 01
Empfänger auflisten
Notieren, wer Daten erhält: Entwicklungsteam, Testsystem, KI-Agent, Cloud-Modell, Dashboard. Für jeden Empfänger festhalten, ob der Empfänger eigene Abfragen schreiben kann.
- 02
Stelle wählen
Mit der Matrix pro Empfänger die passende Stelle wählen. Für Entwickler und Agenten mit Abfragerechten eine bereinigte Kopie wählen.
- 03
Auf eigenen Beispielen messen
Zwanzig bis fünfzig typische Texte und Tabellen mit erfundenen Werten zusammenstellen und prüfen, was das Werkzeug erkennt. Schweizer Formate wie AHV, Fallnummern und Geburtsdaten gezielt testen.
- 04
Regeln pflegen
Bei jeder neuen Spalte und jedem neuen Dokumenttyp die Regeln ergänzen und die Messung wiederholen.
Quellen
Für die Geschäftsleitung
Dieses Dossier als PDF
Den vollständigen Beitrag plus eine kompakte Management-Zusammenfassung und Checkliste, als PDF zum Speichern und Weiterleiten.
Sie erhalten das PDF sofort. Mit dem Absenden stimmen Sie zu, dass Souverana Sie zu diesem Thema kontaktieren darf. Verarbeitung in der Schweiz/EU, keine Weitergabe an Dritte, Widerruf jederzeit (revDSG).
Häufige Fragen
- Was ist der Unterschied zwischen statischer und dynamischer Datenmaskierung?
- Statische Maskierung erzeugt eine Kopie der Datenbank, in der die echten Werte ersetzt sind. Dynamische Maskierung lässt die Daten unverändert und blendet Werte erst bei der Abfrage für bestimmte Nutzer aus. In den Dokumentationen von Microsoft und Oracle steht, dass Nutzer mit eigenen Abfragerechten maskierte Werte über gezielte Abfragen erschliessen können.
- Kann ich echte Produktionsdaten für Tests verwenden?
- Mit Personendaten nur, wenn die Bearbeitung dafür zulässig ist und das Testsystem gleich geschützt ist wie die Produktion. Als Ersatz für echte Daten eignet sich eine maskierte Kopie mit gültigen Formaten oder eine Teilmenge mit synthetischen Werten. Werkzeuge wie PostgreSQL Anonymizer oder Greenmask erzeugen solche Kopien so, dass derselbe Originalwert überall gleich ersetzt wird. Das ist eine Einordnung, keine Rechtsberatung.
- Ist eine pseudonymisierte Testdatenbank anonym?
- In der Regel nicht. Pseudonymisierung ersetzt Namen und Nummern, Merkmale wie Geburtsdatum, Geschlecht und Wohngemeinde bleiben. In einer Messung von Souverana an einer erfundenen Praxisdatenbank lagen in der Kopie 86 Prozent der Personen über Geschlecht, Geburtsjahr und Gemeinde in Gruppen unter fünf. Wer Anonymität braucht, muss diese Merkmale vergröbern und das Ergebnis messen.
- Erkennt Presidio deutsche und schweizerische Personendaten?
- Presidio, ein verbreitetes Open-Source-Werkzeug zur Erkennung von Personendaten, ist in der Grundeinstellung auf Englisch ausgelegt. Andere Sprachen und Schweizer Formate wie AHV-Nummern muss man selbst einrichten. In einem Projektvergleich auf 484 synthetischen Schweizer Texten erkannte Presidio mit Schweizer Regeln und dem Erkennungsmodell GLiNER rund 97 Prozent der Personendaten, Geburtsdaten nicht mitgezählt.
- Was macht ein Proxy vor einem Sprachmodell wie ChatGPT?
- Der Proxy erkennt Namen, Nummern und Adressen im Text, ersetzt diese Angaben durch Platzhalter wie <PERSON_1> und schickt nur den bereinigten Text an das Modell. In der Antwort setzt der Proxy die Originalwerte wieder ein. Bei Fliesstext funktioniert das gut. Bei Tabellenzeilen beurteilt der Proxy jeden Wert einzeln. Ob eine Kombination wie Geburtsdatum, Geschlecht und Gemeinde eine Person verrät, erkennt der Proxy nicht.
Diesen Beitrag teilen
Fertig formatierte Grafiken und ein Textvorschlag für Ihren LinkedIn-Post: herunterladen, kopieren, posten.
Textvorschlag
Arbeitet Ihr Entwicklungsteam mit einer Kopie der Produktionsdatenbank, oder fragt ein KI-Agent Ihre Kundendaten direkt ab?

Für beides gibt es Werkzeuge, die Personendaten verbergen oder ersetzen. Die Werkzeuge setzen an fünf Stellen an: bei einer maskierten Kopie, bei jeder Abfrage, mit synthetischen Daten, in einem Proxy vor dem Sprachmodell oder mit einem Modell im eigenen Betrieb. Microsoft und Oracle schreiben selbst, dass die Maskierung bei der Abfrage nicht vor Personen schützt, die selbst Abfragen formulieren.

Für Text haben wir die Erkennung gemessen. In einem Projektvergleich auf 484 synthetischen Schweizer Texten liess das verbreitete Werkzeug Presidio in der Standardeinstellung 804 von 2'934 Personendaten unerkannt, Geburtsdaten nicht mitgezählt. Mit dem Erkennungsmodell GLiNER und Regeln für Schweizer Formate waren es noch 72. Unser Schluss: Wie gut ein Werkzeug auf Schweizer Formate eingestellt ist, entscheidet über den Schutz. Die Einstellung muss auf eigenen Beispielen gemessen werden.

Der Beitrag beschreibt die fünf Stellen mit Werkzeugen und Grenzen und zeigt einen Proxy im echten Lauf. Eine Matrix ordnet die Stellen vier Anwendungsfällen zu. Das PDF enthält die Werkzeuge mit Lizenzen und ein Arbeitsblatt für den Architekturentscheid. Link in den Kommentaren.

#Datenschutz #Testdaten #KI #Anonymisierung #Schweiz