Daten ohne Namen: Pseudonymisierung oder Anonymisierung?
Wer Kundendaten mit KI auswerten oder an ein externes Team geben will, entfernt vorher oft die Namen. Ob die Kundinnen und Kunden damit geschützt sind, ist eine andere Frage. Der Beitrag erklärt den Unterschied zwischen Pseudonymisierung und Anonymisierung. Eine erfundene Patientin aus dem Dorf Maschwanden und Zahlen des Bundesamts für Statistik zeigen, wie leicht sich Menschen ohne Namen wiederfinden lassen. Ein Rechner zeigt das für alle 2'115 Schweizer Gemeinden.
Analyse · Veröffentlicht 11.11.2026 · Aktualisiert 12.11.2026 · Joel Barmettler
Warum Unternehmen Daten vor dem Einsatz von KI anonymisieren und wo das scheitert
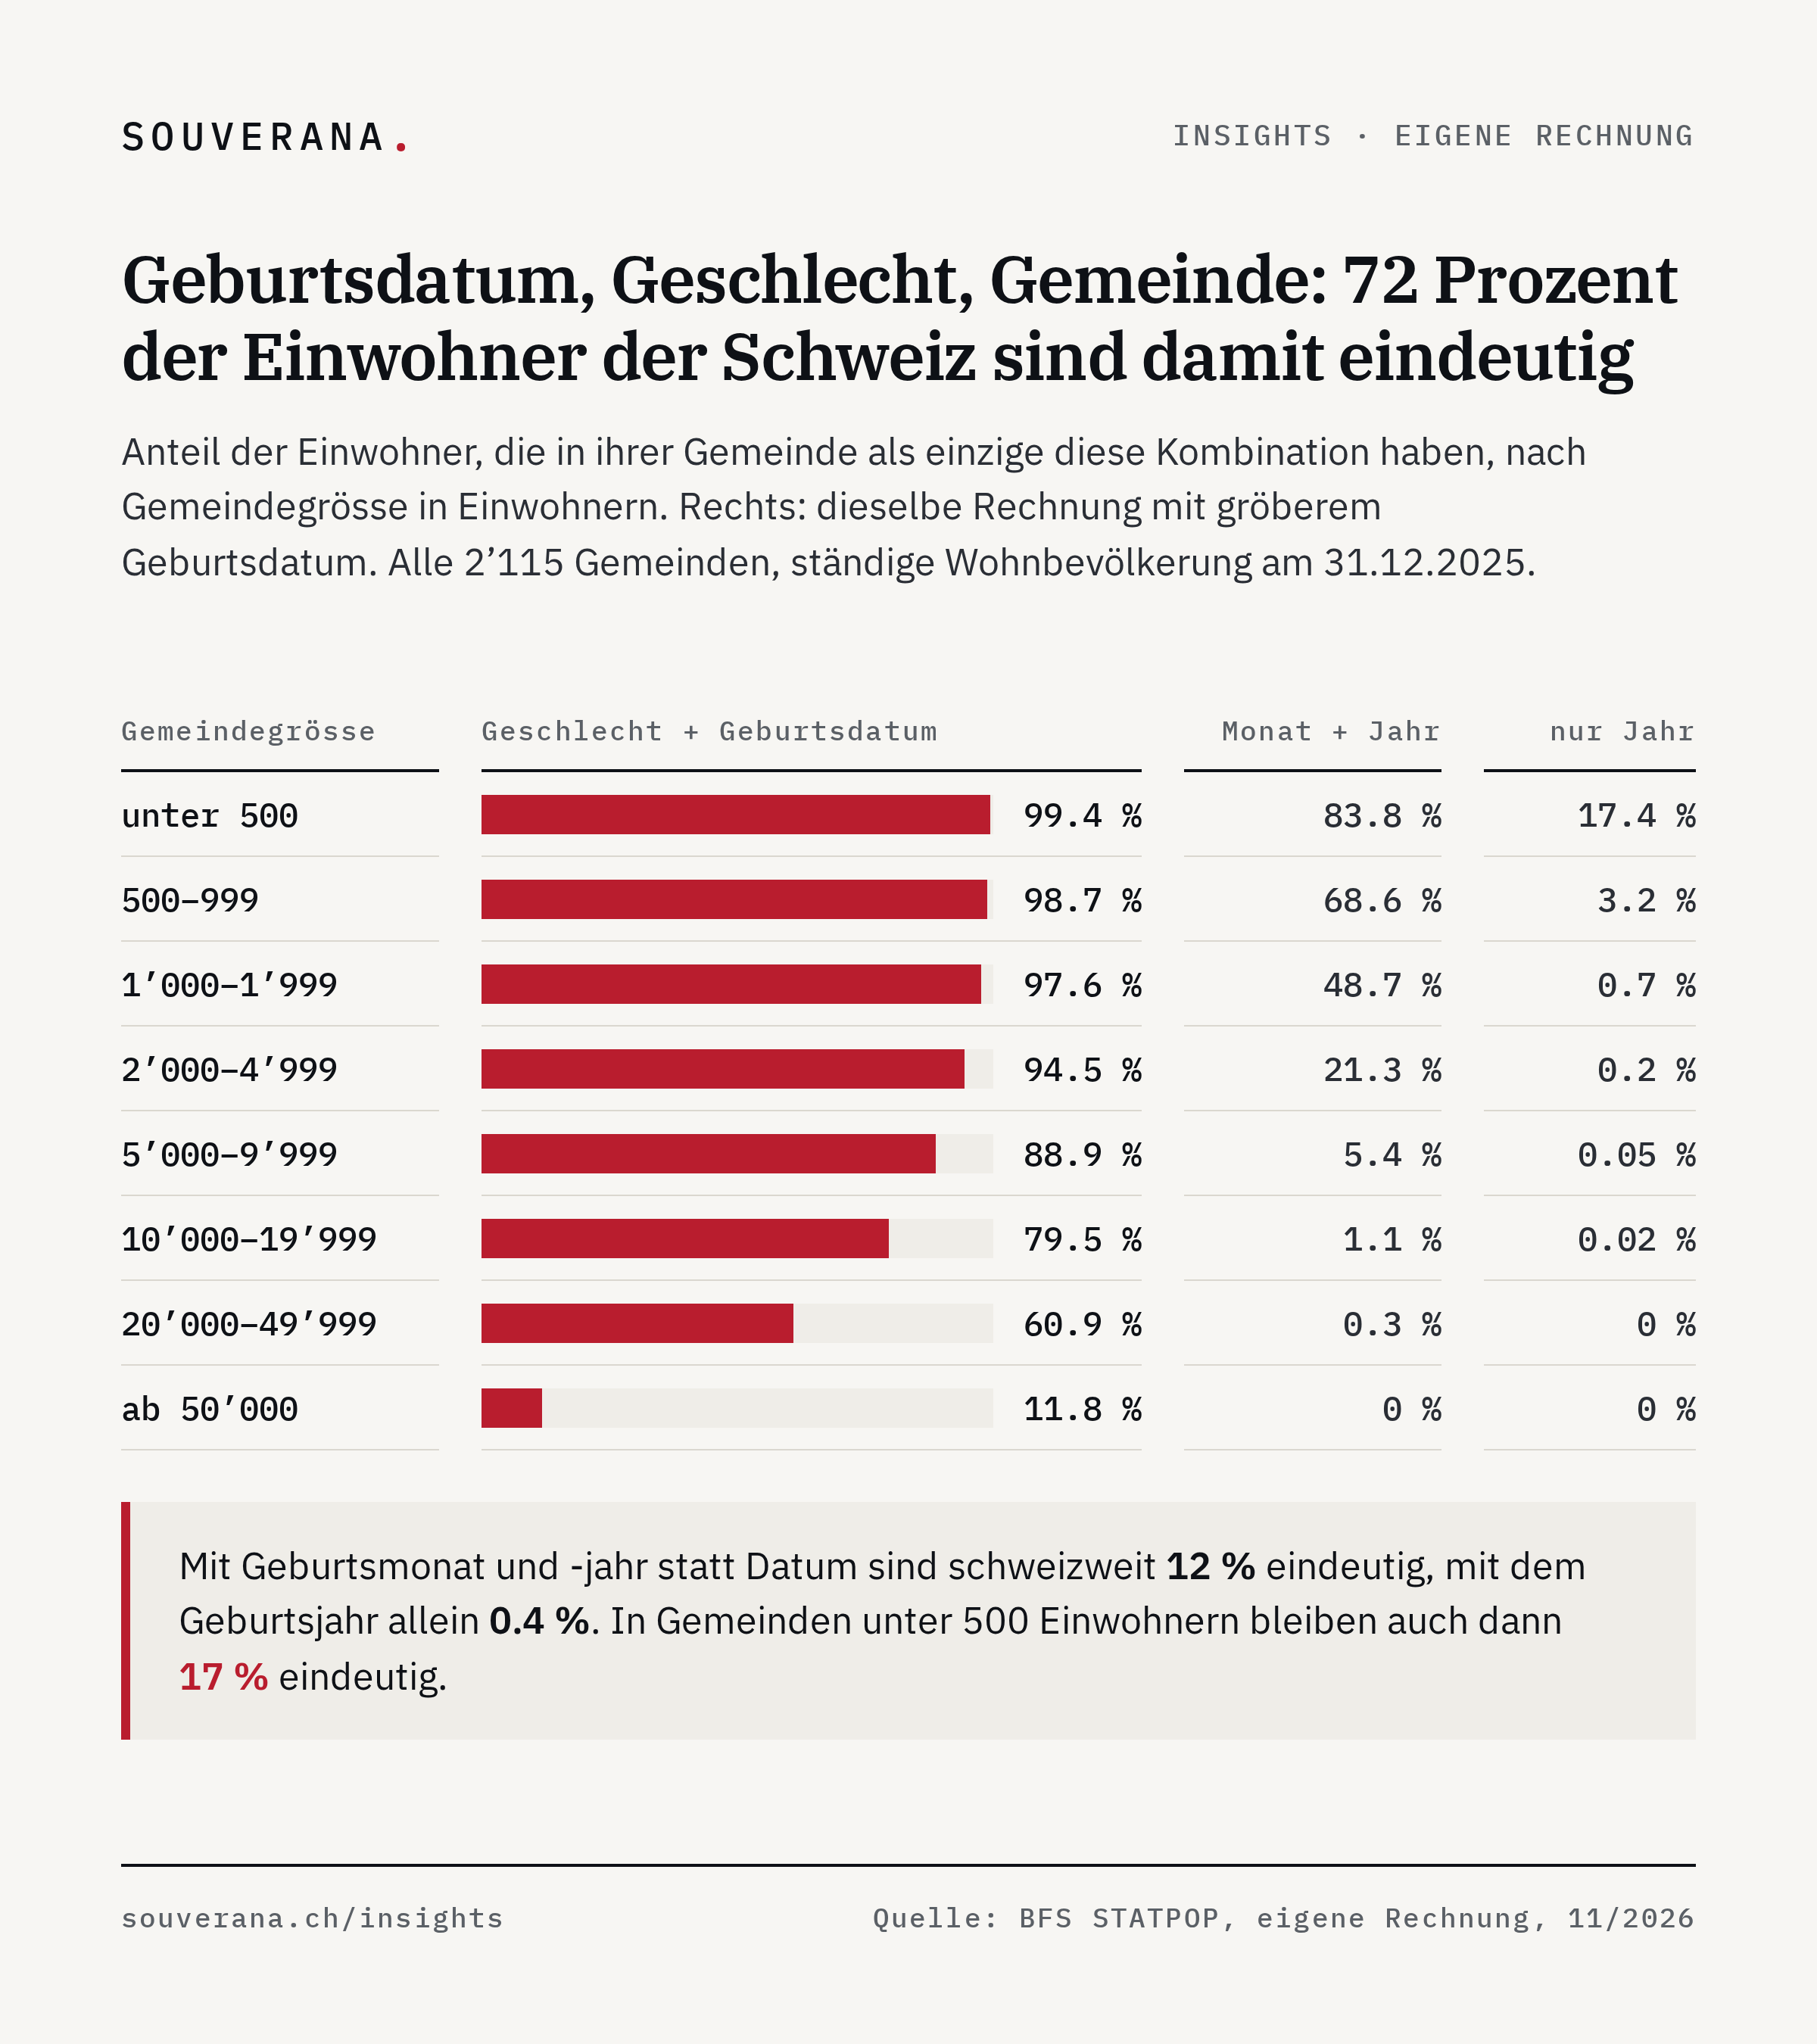
Kundendaten darf ein Unternehmen nicht ohne Weiteres einem Cloud-Modell, einem externen Entwicklungsteam oder einem KI-Agenten geben. Enthalten die Kundendaten Angaben über Personen, gilt das Datenschutzgesetz. Erst wenn sich mit vernünftigem Aufwand niemand mehr erkennen lässt, fallen die Daten nicht mehr unter das Datenschutzgesetz. Die Namen zu löschen reicht dafür oft nicht: 72 Prozent der Einwohner der Schweiz sind schon an Geburtsdatum, Geschlecht und Wohngemeinde eindeutig zu erkennen, wie eine Rechnung von Souverana zeigt.
Drei Einsätze von KI auf Kundendaten sind verbreitet:
- Ein Sprachmodell wie ChatGPT oder Claude wertet einen Export der Kundendatenbank in Minuten aus.
- Ein externes Entwicklungsteam testet mit einer Kopie der echten Daten und findet Fehler, die mit erfundenen Daten oft nicht auftreten.
- Ein KI-Agent mit Zugang zur Datenbank beantwortet Fragen, für die sonst jemand eine Auswertung schreiben müsste.
In allen drei Fällen gelangen die Daten zu einem Dritten, etwa zum Betreiber des Modells. Enthalten die weitergegebenen Daten Angaben über Kundinnen, Patienten oder Mitarbeitende, sind diese Angaben Personendaten. Personendaten sind alle Angaben, die sich auf eine bestimmte oder bestimmbare Person beziehen. Dazu gehört weit mehr als der Name. Für Personendaten gilt das Schweizer Datenschutzgesetz, das revDSG. Lässt ein Unternehmen Personendaten von einem Dienstleister bearbeiten, verlangt das Gesetz in der Regel einen Vertrag. Liegen die Server im Ausland und gilt dort kein angemessener Datenschutz, braucht es vertragliche Garantien. Was ein Cloud-Anbieter mit den Daten tun darf, steht im Vertrag mit dem Anbieter. Bei Claude von Anthropic hängt das zum Beispiel vom gewählten Tarif ab.
Für Kanzleien und Arztpraxen kommt das Berufsgeheimnis dazu. Das Berufsgeheimnis schränkt ein, wem Anwältinnen und Ärzte die Daten ihrer Klientinnen und Patienten überhaupt zeigen dürfen.
Der gängige Ausweg: Die Daten werden vorher so verändert, dass keine Zuordnung zu einer Person mehr möglich ist. Dafür gibt es zwei Verfahren, die man leicht verwechselt.
Anonymisieren heisst, die Daten so zu verändern, dass auch über Umwege keine Zuordnung zu einer Person mehr möglich ist. Dann sind die Daten keine Personendaten mehr. Das revDSG gilt für anonyme Daten nicht. Ob Daten in diesem Sinn anonym sind, hängt auch vom Empfänger ab: davon, welche anderen Daten der Empfänger schon hat.
Pseudonymisieren heisst, Namen und Nummern durch Codes zu ersetzen, etwa «Kunde 4711» statt «Peter Keller». Die Zuordnung liegt in einer separaten Tabelle. Im Alltag hält die getrennte Tabelle neugierige Blicke fern. Rechtlich bleiben die Daten in der Regel Personendaten.
Datensätze, die im Betrieb als anonym gelten, sind oft nur pseudonymisiert. Das liegt an den Angaben, die nach dem Ersetzen der Namen übrig bleiben: Geburtsdatum, Geschlecht, Wohnort. Wie viel diese drei Angaben verraten, haben wir für die Schweiz nachgerechnet.
Dieser Beitrag eröffnet unsere dreiteilige Serie zum Anonymisieren von Daten. Der zweite Teil behandelt die Rechtslage in der Schweiz. Der dritte Teil vergleicht, an welcher Stelle der Architektur sich anonymisieren lässt. Dort messen wir auch, wie zuverlässig Werkzeuge Namen und Nummern in Texten finden.
Was Geburtsdatum, Geschlecht und Gemeinde in der Schweiz verraten
Ein erfundenes Beispiel zeigt das Problem. Eine Hausarztpraxis im Knonaueramt plant, ihre Patientendaten mit KI auszuwerten. Vorher löscht die Praxis die Namen. In der Patientenliste bleiben pro Zeile Geschlecht, Geburtsdatum, Wohngemeinde und Diagnose stehen. Eine der Zeilen gehört Hildegard Kaufmann, 87, aus Maschwanden: Frau, geboren am 14. März 1939, Herzinsuffizienz. Praxis und Patientin sind erfunden, die Bevölkerungszahlen von Maschwanden sind echt.
Maschwanden liegt rund 20 Kilometer von Zürich entfernt und zählte Ende 2025 genau 669 Einwohner. Laut Bundesamt für Statistik lebte im Dorf genau eine Frau des Jahrgangs 1939. In unserem Beispiel ist das Hildegard. Das Gemeindeblatt gratulierte ihr im März zum 87. Geburtstag. Hildegards Name fehlt in der Patientenliste. Wer im Dorf lebt oder eine Einwohnerliste hat, weiss trotzdem, wem die Zeile gehört. Damit ist auch Hildegards Diagnose bekannt. Um eine Zeile ohne Namen einer Person zuzuordnen, genügt eine Quelle mit Namen und Geburtsdatum, etwa ein Vereinsverzeichnis, ein Profil in einem sozialen Netzwerk oder die Gratulation im Gemeindeblatt.
In der Grafik sehen Sie einen Ausschnitt der erfundenen Patientenliste ohne Namen. Sie wissen, was eine Nachbarin aus dem Gemeindeblatt weiss: Frau, geboren am 14. März 1939, wohnhaft in Maschwanden. Suchen Sie Hildegards Zeile und vergröbern Sie danach die Angaben Stufe um Stufe.
Nach unserer Rechnung sind in Maschwanden rund 99 Prozent der Einwohner über Geburtsdatum und Geschlecht eindeutig. Hildegard ist also kein Sonderfall.
Wir haben das für alle 2’115 Gemeinden der Schweiz durchgerechnet. Grundlage sind die Bevölkerungszahlen des Bundesamts für Statistik per 31. Dezember 2025, aufgeschlüsselt nach Gemeinde, Geschlecht und Altersjahr.[1] Wer Ende 2025 vierzig Jahre alt ist, wurde 1985 geboren. Das Alter verrät also den Jahrgang. Wie sich die Geburtstage innerhalb eines Jahrgangs verteilen, steht nicht in der Tabelle. Wir nehmen an, dass die Geburtstage gleichmässig übers Jahr fallen. Als eindeutig zählt, wer in seiner Gemeinde als Einziger dieses Geschlecht und dieses Geburtsdatum hat.
Kennzahl
72 %Quelle: Eigene Rechnung mit BFS STATPOP, ständige Wohnbevölkerung am 31.12.2025, 2'115 Gemeinden
Das Ergebnis hängt vor allem von der Grösse der Gemeinde ab. Mehr als die Hälfte aller Schweizer Gemeinden hat weniger als 2’000 Einwohner. Dort sind über 97 Prozent der Menschen eindeutig. In der Stadt Zürich mit 441’000 Einwohnern teilen die meisten Menschen Geschlecht und Geburtsdatum mit mehreren anderen. Eindeutig zu erkennen ist dort nur gut 1 Prozent.
In den USA kam die Informatikerin Latanya Sweeney im Jahr 2000 mit Daten der Volkszählung von 1990 für dieselbe Kombination aus Geburtsdatum, Geschlecht und Wohnort auf 53 Prozent.[2] Häufiger zitiert wird ihre zweite Zahl: 87 Prozent mit der fünfstelligen Postleitzahl. Der Forscher Philippe Golle hat diese Zahl 2006 überprüft und kam auf 63 Prozent.[3] Mit 72 Prozent liegt die Schweiz über dem amerikanischen Wert von 53 Prozent für den Wohnort. Die beiden Werte stammen aus anderen Jahren und anders abgegrenzten Wohnorten. Ein Grund für den Unterschied dürften die vielen kleinen Schweizer Gemeinden sein.
Im Rechner sehen Sie die Werte für jede Gemeinde, voreingestellt ist Maschwanden. Der senkrechte Strich in jedem Balken markiert den Schweizer Durchschnitt.
Wie aus «eindeutig» ein Name wird: drei bekannte Fälle
Einer eindeutigen Zeile fehlt nur noch der Name. Den Namen liefert eine zweite Quelle, in der dieselben Merkmale samt Namen stehen. Die bekanntesten Beispiele dafür stammen aus den USA.
Die Spitaldaten des Gouverneurs, 1997. Die Versicherungskasse der Staatsangestellten von Massachusetts gab Daten zu Spitalaufenthalten von rund 135’000 Angestellten und Angehörigen an Forschende weiter, ohne Namen, aber mit Geburtsdatum, Geschlecht und Postleitzahl. Latanya Sweeney kaufte für 20 Dollar das Wählerverzeichnis der Stadt Cambridge. Im Wählerverzeichnis hatten sechs Personen dasselbe Geburtsdatum wie Gouverneur William Weld. Drei davon waren Männer, nur einer wohnte in der Postleitzahl des Gouverneurs.[4] So fand sie die Krankenakte des Gouverneurs.
Die Suchanfragen von AOL, 2006. AOL veröffentlichte für die Forschung rund 20 Millionen Suchanfragen von etwa 650’000 Nutzern und ersetzte deren Namen durch Nummern. Reporter der New York Times fanden Nutzerin 4417749 innert Tagen: Thelma Arnold, eine 62-jährige Witwe aus Lilburn im US-Bundesstaat Georgia.[5] Dafür reichten ihre Suchen nach Orten in der Nähe und nach Leuten mit ihrem Nachnamen.
Die Filmbewertungen von Netflix, 2008. Für einen Wettbewerb gab Netflix 100 Millionen Bewertungen von 480’000 Abonnenten frei, auch hier ohne Namen. Die Forscher Arvind Narayanan und Vitaly Shmatikov glichen die Netflix-Bewertungen mit öffentlichen Bewertungen auf der Filmplattform IMDb ab. Acht Bewertungen mit ungefährem Datum reichten, um 99 Prozent der Abonnenten im Datensatz eindeutig zu erkennen, selbst wenn zwei der acht falsch waren.[6] Netflix sagte den geplanten zweiten Wettbewerb 2010 nach einer Klage ab.[7]
In den drei Datensätzen standen keine Namen. Ein Forschungsteam um Luc Rocher hat die Frage 2019 mit einem statistischen Modell verallgemeinert. Die Studie erschien in Nature Communications. Mit 15 demografischen Merkmalen liessen sich 99.98 Prozent der Amerikaner in einem beliebigen Datensatz richtig wiederfinden.[8]
Vier Begriffe und vier Arten von Spalten
Neben Anonymisierung und Pseudonymisierung fallen in Projekten zwei weitere Begriffe. Die Tabelle stellt alle vier nebeneinander:
| Begriff | Was mit den Daten geschieht | Was danach gilt |
|---|---|---|
| Anonymisierung | Daten werden so verändert, dass sich keine Person mehr mit vernünftigem Aufwand bestimmen lässt | Keine Personendaten mehr, das revDSG gilt nicht |
| Pseudonymisierung | Namen und Nummern werden ersetzt, die Zuordnung liegt getrennt | In der Regel weiterhin Personendaten |
| Maskierung | Einzelne Werte werden verdeckt oder verfälscht | Eine Technik: je nach übrigen Angaben anonym oder pseudonym |
| Synthetische Daten | Ein Generator erzeugt neue Datensätze nach dem Muster der echten | Keine echten Personen, solange der Generator keine echten Datensätze wiedergibt |
Das revDSG kennt das Wort Pseudonymisierung nicht. Massgebend ist dort nur, ob sich Angaben auf eine «bestimmte oder bestimmbare natürliche Person» beziehen.[9] Wer den Schlüssel zu den Pseudonymen hat, kann die Person bestimmen. Für ihn bleiben die Daten Personendaten. Ob die Daten auch für einen Empfänger ohne Schlüssel Personendaten sind, klärt der zweite Teil dieser Serie.
Welches Verfahren genügt, zeigt ein Blick auf die einzelnen Angaben. In einer Datenbank steht jede Art von Angabe in einer eigenen Spalte, etwa Geburtsdatum oder Diagnose. Die Spalten fallen in vier Gruppen:
- Direkte Identifikatoren bestimmen eine Person allein: Name, AHV-Nummer, E-Mail-Adresse, Telefonnummer, IBAN.
- Quasi-Identifikatoren bestimmen eine Person erst in Kombination: Geburtsdatum, Geschlecht, Postleitzahl oder Gemeinde, Beruf, Nationalität, Eintrittsdatum.
- Sensible Attribute sind das, was Dritte nicht erfahren sollen: Diagnose, Lohn, Steuerbetrag, Kreditlimite. Meist sind sensible Attribute der Grund, warum man die Daten überhaupt auswerten will.
- Freitext kann Angaben aus allen drei Gruppen enthalten, in beliebiger Form. Eine Notiz wie «Herr Keller, der neue Gemeindeschreiber, ruft wegen der Hypothek an» enthält einen Namen, einen Beruf mit Ortsbezug und eine finanzielle Angelegenheit.
Pseudonymisierung ersetzt vor allem die erste Gruppe. Die Quasi-Identifikatoren bleiben unverändert im Datensatz. Genau über diese Merkmale gelingt die Re-Identifikation. Freitext ist die schwierigste Gruppe, weil man Freitext Zeile für Zeile lesen muss, von Hand oder mit einem Modell. Wie gut Werkzeuge dabei Namen, AHV-Nummern und Adressen in Schweizer Texten finden, messen wir im dritten Teil.
Schutz kostet Auswertungstiefe
Die naheliegende Massnahme ist, Merkmale zu vergröbern. Der Rechner zeigt, wie viel das bringt. Behält man nur Geburtsmonat und -jahr, sind schweizweit noch 12 Prozent der Einwohner eindeutig. Behält man nur das Geburtsjahr, sind es 0.4 Prozent.
Das gilt aber nicht überall. In Gemeinden unter 500 Einwohnern sind selbst mit Geburtsjahr, Geschlecht und Gemeinde noch 17 Prozent eindeutig. Dort muss man auch die Gemeinde vergröbern, etwa auf den Bezirk.
Wer vergröbert, kann weniger genau auswerten. Eine Pensionskasse, die Rentenbeginne plant, braucht das genaue Geburtsdatum. Eine Auswertung der Altersstruktur pro Kanton kommt mit dem Jahrgang aus. Ein Entwicklungsteam, das eine Fristberechnung testet, kommt mit erfundenen, gültigen Daten aus. Wie grob die Daten sein dürfen, entscheidet man deshalb für jeden Empfänger und jeden Zweck einzeln.
Hildegards Dorf zeigt den Preis. Auf der Stufe mit Altersgruppe und Bezirk passt Hildegards Zeile zu neun Patientinnen der Praxis und zu 526 Frauen im Bezirk Affoltern. Die Frage, wie viele Patientinnen ab 85 aus Maschwanden Herzinsuffizienz haben, lässt sich dann nicht mehr beantworten. Die Liste nennt nur noch drei Fälle für den ganzen Bezirk. Auswertungen über kleine Gruppen widersprechen der Anonymisierung deshalb fast zwangsläufig. Damit niemand Hildegard findet, muss Hildegard in einer grösseren Gruppe aufgehen. Dasselbe gilt für jeden anderen Ausreisser im Datensatz. Mit den Ausreissern verschwinden auch die Unterschiede zwischen kleinen Gruppen aus der Auswertung.
Wie man misst, ob es reicht
Ob ein Datensatz anonym genug ist, lässt sich mit drei Messgrössen prüfen. Diese Messgrössen stammen aus Forschungsarbeiten ab 2002 und sind heute in frei verfügbaren Werkzeugen eingebaut.
k-Anonymität verlangt, dass jede Kombination der Quasi-Identifikatoren mindestens k-mal vorkommt.[4] Bei k gleich 5 versteckt sich jede Person in einer Gruppe von mindestens fünf. Für Jahrgang, Geschlecht und Gemeinde verletzen in der Schweiz rund 254’000 Einwohner diese Regel, knapp 3 Prozent. 89 Prozent davon leben in Gemeinden unter 2’000 Einwohnern. Um k gleich 5 zu erreichen, müsste man die Angaben dieser 254’000 Personen vergröbern oder die betroffenen Zeilen löschen. In der Patientenliste aus der Grafik zählt Hildegards Gruppe erst auf der vierten Stufe mehr als fünf Zeilen. Die zwei Männer und die 90-jährige Patientin der Liste bilden auch dort noch kleinere Gruppen.
l-Diversität schliesst eine Lücke der k-Anonymität. Haben alle fünf Personen einer Gruppe dieselbe Diagnose, ist die Diagnose verraten, auch wenn niemand weiss, welche der fünf Zeilen zur gesuchten Person gehört. l-Diversität verlangt, dass in jeder Gruppe mindestens l verschiedene Werte des heiklen Merkmals vorkommen.
Differential Privacy setzt bei den Auswertungen an.[11] Jedes Ergebnis wird mit einem genau bemessenen Rauschen versehen. Ob eine bestimmte Person in den Daten steckt, verändert das Ergebnis dann kaum. Das US Census Bureau hat so die Volkszählung 2020 geschützt. Zuvor hatte das Census Bureau in einem eigenen Test aus den veröffentlichten Tabellen von 2010 die Einträge von 97 Millionen Menschen rekonstruiert.[12] Das Rauschen kostet Genauigkeit, besonders in kleinen Gebieten.
In der Grafik prüfen Sie die drei Messgrössen an der Patientenliste aus Maschwanden: wie gross die Gruppen sind, ob eine Gruppe ihre Diagnose verrät und wie stark das Rauschen eine kleine und eine grosse Zählung verändert.
Grob gilt: k-Anonymität und l-Diversität passen, wenn ganze Zeilen weitergegeben werden, etwa als Testdaten oder Export. Differential Privacy passt für Kennzahlen und Dashboards. Für Freitext taugen die drei Messgrössen kaum. Dort muss man Namen, Nummern und Adressen im Text selbst finden und ersetzen.
Drei Wege, KI trotzdem auf Personendaten anzuwenden
KI auf Kundendaten bleibt möglich, auf drei Wegen.
Anonymisieren, so weit der Zweck es erlaubt. Die Daten werden vergröbert, bis die Messgrössen aus dem vorigen Abschnitt zeigen, dass der Schutz ausreicht. Das passt für Testdaten und für Auswertungen, die keine Einzelpersonen brauchen. Sind die Daten für den Empfänger anonym, entfallen die Vorgaben des revDSG, auch für Cloud-Modelle und Empfänger im Ausland.
Die Daten im Haus behalten. Ein Modell im eigenen Betrieb verarbeitet die echten Werte, ohne dass die Werte das Unternehmen verlassen. Offene Modelle wie das Schweizer Apertus lassen sich auf eigener Hardware oder bei einem Schweizer Hoster betreiben.
Einen Anbieter beauftragen. Ein Cloud-Anbieter oder ein externes Team bearbeitet die Personendaten im Auftrag, mit Vertrag und den nötigen Garantien. Für Daten unter Berufs- oder Amtsgeheimnis ist dieser Weg besonders anspruchsvoll.
Der zweite Teil dieser Serie klärt, welcher Weg wann zulässig ist. Der dritte zeigt, wo in der Architektur man ansetzt.
So starten Sie
Für den ersten Schritt genügt eine Liste der Angaben, die weitergegeben werden sollen. In einer Datenbank entsprechen die Angaben den Spalten der betroffenen Tabellen.
- 01
Spalten einordnen
Jede Spalte der Datenbank einer der vier Gruppen zuweisen: direkte Identifikatoren, Quasi-Identifikatoren, sensible Attribute, Freitext. Freitextfelder gesondert markieren.
- 02
Zweck pro Empfänger festlegen
Für jeden Empfänger (Entwicklungsteam, KI-Agent, Auswertung) notieren, welche Spalten der Empfänger wirklich braucht und in welcher Genauigkeit. Alles andere fällt weg oder wird vergröbert.
- 03
Messen
Für die verbleibenden Quasi-Identifikatoren zählen, wie viele Kombinationen weniger als fünfmal vorkommen. Dafür genügt eine einfache Gruppierungsabfrage oder ein freies Werkzeug wie ARX.
- 04
Entscheiden und festhalten
Schutzmass, Messwert und Freigabe schriftlich festhalten. Der zweite Teil dieser Serie zeigt, was in ein solches Anonymisierungskonzept gehört.
Quellen
Für die Geschäftsleitung
Dieses Dossier als PDF
Den vollständigen Beitrag plus eine kompakte Management-Zusammenfassung und Checkliste, als PDF zum Speichern und Weiterleiten.
Sie erhalten das PDF sofort. Mit dem Absenden stimmen Sie zu, dass Souverana Sie zu diesem Thema kontaktieren darf. Verarbeitung in der Schweiz/EU, keine Weitergabe an Dritte, Widerruf jederzeit (revDSG).
Häufige Fragen
- Was ist der Unterschied zwischen Anonymisierung und Pseudonymisierung?
- Bei der Pseudonymisierung werden Namen und Nummern durch Codes ersetzt. Zuordnen lassen sich die Daten trotzdem, über einen Schlüssel oder über Merkmale wie Geburtsdatum und Wohnort. Pseudonymisierte Daten bleiben deshalb in der Regel Personendaten. Anonym sind Daten erst, wenn sich keine Person mehr mit vernünftigem Aufwand bestimmen lässt. Dann gilt das revDSG nicht mehr.
- Sind Daten ohne Namen anonym?
- Meistens nicht. Schon Geburtsdatum, Geschlecht und Wohngemeinde reichen, um viele Menschen eindeutig zu erkennen. Souverana hat das mit Bevölkerungsdaten des Bundesamts für Statistik von Ende 2025 nachgerechnet: In der Schweiz sind so 72 Prozent der Einwohner eindeutig zu erkennen. Kommt eine zweite Quelle mit Namen und denselben Merkmalen dazu, lassen sich die Zeilen einzelnen Personen zuordnen.
- Gelten pseudonymisierte Daten nach revDSG als Personendaten?
- Das revDSG kennt den Begriff Pseudonymisierung nicht. Das revDSG fragt, ob sich Daten auf eine bestimmte oder bestimmbare Person beziehen (Art. 5 lit. a). Für den Verantwortlichen mit dem Schlüssel sind pseudonymisierte Daten Personendaten. Für einen Empfänger ohne Schlüssel sind die Daten Personendaten, wenn der Empfänger die Personen mit vernünftigem Aufwand bestimmen kann. Diese Einordnung ersetzt keine Rechtsberatung.
- Was ist k-Anonymität?
- k-Anonymität ist ein Mass dafür, wie gut sich Personen in einem Datensatz verstecken. Ein Datensatz ist k-anonym, wenn jede Kombination von Merkmalen wie Jahrgang, Geschlecht und Wohnort mindestens k-mal vorkommt. Bei k gleich 5 versteckt sich jede Person in einer Gruppe von mindestens fünf. Kombinationen, die seltener vorkommen, werden vergröbert oder gelöscht.
- Reicht es, das Geburtsdatum auf das Geburtsjahr zu kürzen?
- In grossen Gemeinden meistens, in kleinen nicht. Nach einer Rechnung von Souverana mit BFS-Daten (Stand Ende 2025) sind mit Geburtsjahr, Geschlecht und Gemeinde schweizweit 0.4 Prozent der Einwohner eindeutig, in Gemeinden unter 500 Einwohnern aber 17 Prozent. Dort muss man auch die Gemeinde vergröbern, etwa auf den Bezirk.
Diesen Beitrag teilen
Fertig formatierte Grafiken und ein Textvorschlag für Ihren LinkedIn-Post: herunterladen, kopieren, posten.
Textvorschlag
Geben Sie Kopien Ihrer Kundendatenbank an externe Entwickler oder an ein KI-Werkzeug weiter, nachdem Sie Namen und AHV-Nummern entfernt haben?

Das revDSG gilt für alle Angaben über eine bestimmbare Person. Wie bestimmbar die Menschen in Ihrer Kopie sind, lässt sich ausrechnen.

Wir haben das mit den Bevölkerungszahlen des Bundesamts für Statistik von Ende 2025 für alle 2'115 Gemeinden nachgerechnet. Mit Geburtsdatum, Geschlecht und Wohngemeinde sind 72 Prozent der Einwohner eindeutig zu erkennen. In Gemeinden unter 2'000 Einwohnern sind es über 97 Prozent, in der Stadt Zürich 1 Prozent. Wer das Geburtsdatum auf das Geburtsjahr kürzt und Geschlecht und Gemeinde behält, senkt den Anteil schweizweit auf 0.4 Prozent. In Gemeinden unter 500 Einwohnern bleiben dann 17 Prozent eindeutig.

Unser Schluss: Ob Daten anonym genug sind, lässt sich mit drei Messgrössen prüfen. Diese Messung gehört an den Anfang, wenn Daten an Dritte oder an ein Cloud-Modell weitergegeben werden sollen.

Im Beitrag suchen Sie in einer erfundenen Patientenliste ohne Namen die 87-jährige Hildegard aus Maschwanden. Dazu kommen der Rechner für jede Gemeinde, drei bekannte Fälle von Re-Identifikation, die vier Arten von Spalten in einer Datenbank und die drei gängigen Messgrössen. Das PDF enthält zusätzlich die Werte pro Kanton und ein Arbeitsblatt für das Spalteninventar. Link in den Kommentaren.

#Datenschutz #Anonymisierung #revDSG #Schweiz #KI