LLM selbst hosten: GPT-5-Niveau für 8'500 Franken
Ein Rechner mit zwei Grafikkarten (RTX 4090), rund 8'500 Franken, drei Wochen Messungen. Welche Aufgaben eine eigene Maschine übernimmt, welche nicht, und wo die Grenze verläuft.
Analyse · Veröffentlicht 14.08.2026 · Aktualisiert 14.08.2026 · Joel Barmettler
Was leistet ein selbst gehostetes LLM?
Ein selbst gehostetes LLM, also ein Sprachmodell, das auf eigener Hardware im eigenen Betrieb läuft, genügt für zwanzig bis dreissig Mitarbeitende. Auf einem Rechner mit zwei Grafikkarten für rund 8’500 Franken läuft ein frei herunterladbares Modell auf dem Niveau von GPT-5.1, einem Modell von OpenAI. Es schreibt Briefe, durchsucht Dokumente und übersetzt. Anspruchsvolles Programmieren und lange Aufgabenketten überfordern die Maschine.
Das Wichtigste in Kürze
- Fangen Sie bei den Aufgaben an und erst danach bei der Hardware. Auf eigener Hardware laufen Aufgaben mit klarem Rahmen und prüfbarem Ergebnis, zum Beispiel Informationen aus Dokumenten ziehen, Eingänge sortieren und übersetzen. Bei einem Anbieter bleiben vorerst Aufgaben, bei denen die KI selbständig viele Werkzeuge nacheinander bedient, sowie anspruchsvolles Programmieren.
- Massgeblich sind die gleichzeitigen Anfragen, also die Fragen, die das Modell im selben Moment bearbeitet. Arbeiten zwanzig bis dreissig Mitarbeitende alle zugleich, sind es drei bis fünf Anfragen. Acht gleichzeitige Anfragen bewältigt die Maschine gut.
- Der Grafikspeicher entscheidet, welches Modell überhaupt passt. Das Tempo hängt davon ab, wie viele Parameter, also Rechenwerte des Modells, pro Wort tatsächlich rechnen. Ein Modell mit 35 Milliarden Parametern, das pro Wort nur drei Milliarden nutzt, antwortete bei uns doppelt so schnell wie ein Modell mit 27 Milliarden Parametern, das alle nutzt.
- Darf eine Aufgabe warten, kommen grössere Modelle infrage. Sie passen nicht mehr ganz in den Grafikspeicher und laufen deshalb langsam, eignen sich aber für Arbeit über Nacht, etwa das Prüfen von hundert Verträgen. Das ist der billigste Weg zu mehr Qualität.
- Erwarten Sie keine Ersparnis. Der Grund für eigene Hardware ist die Kontrolle über die Daten.
In Beratungsmandaten fragen Kanzleien, Arztpraxen und Treuhandbüros inzwischen regelmässig, ob sie ein Sprachmodell im eigenen Betrieb laufen lassen sollen. Die Daten dieser Betriebe sind besonders schützenswert, oft dem Berufsgeheimnis unterstellt. Ein Vertrag mit einem Anbieter löst das Problem juristisch, doch bei manchen Beständen will die Geschäftsleitung schlicht, dass die Akten den Betrieb nie verlassen.
Auf «welches Modell nehmen wir» antworten wir dann mit zwei Gegenfragen: Welche Aufgaben soll die KI im eigenen Betrieb übernehmen? Und wie viele Mitarbeitende arbeiten gleichzeitig damit? Aus den Antworten folgt die Modellklasse, und erst daraus die Maschine.
Wir sind diesen Weg selbst gegangen und haben drei Wochen lang gemessen. Was folgt, sind unsere Zahlen vom August 2026.
Dieser Beitrag eröffnet unsere fünfteilige Serie über lokale Inferenz, also den Betrieb von Sprachmodellen auf eigener Hardware. Er erzählt, was wir gebaut und gemessen haben; die technischen Teile danach zeigen, wie Sie es selbst auslegen.
Zuerst die Aufgaben, dann die Hardware
Auf eigener Hardware laufen zuverlässig die Aufgaben, die einen klaren Rahmen und ein prüfbares Ergebnis haben. Für eine Kanzlei oder eine Praxis ist das der grösste Teil dessen, was KI im Alltag tun soll. Sortieren Sie Ihre Aufgaben in zwei Listen.
Auch auf Deutsch arbeitet das Modell gut. Wir haben es mit Wissensfragen im Multiple-Choice-Format geprüft, die ins Deutsche übersetzt waren. Bei einem Test, den professionelle Übersetzer übertragen hatten, beantwortete das Modell, das wir betreiben, 82 Prozent richtig. Ein zweiter Test derselben Art, maschinell übersetzt, ergab 88 Prozent. Beide Werte liegen so hoch, dass uns Deutsch nicht als Engpass aufgefallen ist.
Schreiben Sie also zuerst zehn bis zwanzig echte Vorgänge aus Ihrem Alltag auf und ordnen Sie sie einer der beiden Listen zu. Fallen die meisten in Liste 1, lohnt sich das Weiterlesen. Fallen sie in Liste 2, sparen Sie sich die Hardware.
Zwanzig Mitarbeitende sind nicht zwanzig Anfragen
Die zweite Frage wird fast immer falsch gestellt. «Reicht das für 200 Mitarbeitende?» lässt sich nicht beantworten. Eine Maschine bedient keine Belegschaft, sie verarbeitet gleichzeitige Anfragen.
Wer eine Antwort liest, prüft und die nächste Frage tippt, stellt etwa alle zwei Minuten eine Anfrage. Die Maschine braucht für jede rund 20 Sekunden und ist damit pro aktiver Person ein Sechstel der Zeit beschäftigt. Sind zur Mittagszeit 40 von 200 Personen aktiv, laufen im Mittel rund sieben Anfragen gleichzeitig. Arbeiten zwanzig bis dreissig Mitarbeitende alle zugleich, sind es drei bis fünf.
Rechnen Sie Ihre eigene Zahl aus, bevor Sie weiterlesen. An ihr hängen später die Grafikkarten, und wir kommen bei den Messungen darauf zurück.
Die Maschine, die daraus folgt
Ein Sprachmodell muss vollständig in den Speicher der Grafikkarte passen, sonst wird es sehr langsam. Auf den Grafikspeicher kommt es beim Selbsthosten deshalb an, und die Preise pro Gigabyte unterscheiden sich stark. Eine RTX 4090 aus dem Gaming-Bereich bietet 24 GB für rund 1’700 Franken. Professionelle Karten bieten 96 GB in einem einzigen Steckplatz und kosten pro Gigabyte ein Mehrfaches davon.
Wir nehmen deshalb zwei dieser Gaming-Karten. Zusammen bieten sie 48 GB, und das Modell lässt sich auf beide verteilen. Der Rest der Einkaufsliste folgt daraus: ein Mainboard mit zwei langen Steckplätzen, ein Netzteil, das beide Karten mit Strom versorgt, und viel Arbeitsspeicher, dessen Nutzen weiter unten sichtbar wird.
| Komponente | Menge | CHF |
|---|---|---|
| ASUS TUF Gaming RTX 4090, 24 GB | 2 | je ca. 1’700 |
| AMD Ryzen 9 7950X | 1 | 489 |
| ASUS ROG Crosshair X670E Hero | 1 | 475 |
| Kingston FURY Beast DDR5-6000, 2 x 32 GB | 2 | je 909 |
| Crucial T700, 4 TB | 2 | je 520 |
| Corsair HX1500i, 1500 W | 1 | 719 |
| Gehäuse, Kühlung, Kleinteile | ca. 460 | |
| Total | ca. 8’450 |
Das Ganze ist ein Desktop-Rechner mit zwei Grafikkarten, bestellbar bei jedem Schweizer Händler. Er steht unter einem Schreibtisch und hängt an einer normalen Steckdose. Herausgekommen sind 48 GB Grafikspeicher (zwei Karten zu je 24 GB) und 128 GB Arbeitsspeicher.
Damit steht die Hardware. Was fehlt, ist das Modell.
Die Suche nach dem Modell beginnt bei einer Rangliste
Bleiben wir bei der eben zusammengestellten Maschine mit ihren 48 GB Grafikspeicher. Welches Modell läuft darauf? Auf Hugging Face liegen zehntausende offene Modelle, viele davon Abwandlungen von Abwandlungen. Wir haben bei Artificial Analysis angefangen. Die Seite schickt Modelle durch denselben Satz Prüfungen und fasst das Ergebnis zu einem Intelligence Index zusammen, einer Zahl auf einer Skala bis 100. Für unseren Fall gibt es dort eine eigene Ansicht für kleine offene Modelle, also genau das Feld, das auf eine Maschine wie unsere passt.
Bevor eine solche Liste nützt, muss man die Namen lesen können. Sie sehen wirr aus und enthalten genau die zwei Zahlen, um die es geht.
Modellname, entschlüsselt
Qwen 3.6 -35B -A3B
- Qwen
- Der Anbieter. Hier Alibaba. Sagt nichts über die Fähigkeit, aber viel über Pflege, Lizenz und darüber, wie viele Grössen es von derselben Familie gibt.
- 3.6
- Die Generation. Eine höhere Nummer schlägt eine niedrigere derselben Familie fast immer, auch bei gleicher Grösse.
- -35B
- Gesamtparameter. 35 Milliarden. Das B steht für das englische «billion», das auf Deutsch Milliarde heisst. Eine deutsche Billion wäre im Englischen eine «trillion». Diese Zahl bestimmt, wie viel Grafikspeicher Sie brauchen, denn so viel muss geladen sein.
- -A3B
- Aktive Parameter. Drei Milliarden. Diese Zahl bestimmt das Tempo, denn nur so viel wird pro Wort gerechnet. Fehlt die Angabe, rechnet das Modell mit allem, was es hat.
Die beiden roten Zahlen tun Verschiedenes. Die erste kostet Sie Speicher, die zweite kauft Ihnen Tempo.
Fehlt der zweite Zahlenblock, ist es ein Dense-Modell: Es rechnet für jedes einzelne Wort mit sämtlichen Parametern. Steht dort ein A, handelt es sich um ein Mixture-of-Experts-Modell, kurz MoE. Es besteht aus vielen kleineren Teilmodellen. Ein vorgeschalteter Teil entscheidet bei jedem Wort, welche wenigen davon arbeiten, und die übrigen ruhen. Die Teilmodelle heissen Experten, weil jedes für andere Aufgaben besonders gut geeignet ist. Diese Bauart ist der Grund, warum ein grösseres Modell schneller antworten kann als ein kleineres.
Drei Klassen, und warum nur eine infrage kommt
Nach diesem Muster sortiert, fallen die offenen Modelle im August 2026 in drei Klassen.
Klein, bis etwa vier Milliarden Parameter. Diese Modelle laufen auf einem Notebook, die kleinsten auf einem Telefon. Sie fassen Texte zusammen, sortieren Eingänge und finden Textstellen. Für alles, was mehrere Schritte hintereinander richtig machen muss, sind sie zu schwach.
Mittel, etwa neun bis vierzig Milliarden Parameter. Qwen, Gemma, Mistral und Apertus liegen in dieser Klasse. Quantisiert passt ein solches Modell in 24 bis 48 GB Grafikspeicher.
Die offene Spitze, 300 Milliarden bis 2.8 Billionen Parameter. DeepSeek, Kimi, GLM. Diese Modelle treten gegen die geschlossenen Spitzenmodelle an und kommen nahe heran. Dafür brauchen sie Dutzende von Rechenzentrumskarten und Anschaffungskosten in Millionenhöhe.
Aus der mittleren Klasse haben wir Qwen genommen, aus drei Gründen. Es war zum Messzeitpunkt das am höchsten platzierte offene Modell, das vollständig in 48 GB passt. Es gibt dieselbe Familie in vielen Grössen sowie als Dense- und als MoE-Variante, was Vergleiche überhaupt erst zulässt. Und es liegen fertige 4-Bit-Fassungen von mehreren unabhängigen Anbietern vor.
Deshalb steht in der Tabelle aus der mittleren Klasse nur dieses eine Modell.
Im Index sieht der Abstand zwischen diesen Welten so aus:
| Modell | Index |
|---|---|
| Claude Opus 5 (proprietär, Spitze) | 63.1 |
| Kimi K3, 2.8 Billionen Parameter (offene Spitze) | 59.7 |
| Qwen3.6-27B (passt ganz in 48 GB) | 37.7 |
| GPT-5.1, zum Vergleich | 37.5 |
| GPT-4o (März 2025) | 12.3 |
Quelle: Artificial Analysis, Abruf vom 12. August 2026.
Die letzten drei Zeilen sind die gute Nachricht. Das Modell, das auf eine Maschine unter dem Schreibtisch passt, liegt gleichauf mit GPT-5.1 und weit über dem GPT-4o, mit dem die meisten Menschen ChatGPT kennengelernt haben.
Eine Rangliste hat allerdings Grenzen. Wer eine Prüfung kennt, kann für sie trainieren, und ein Index sagt nichts über Ihre Dokumente, Ihre Sprache und Ihre Werkzeuge. Deshalb haben wir die Kandidaten heruntergeladen und selbst nachgemessen.
Was Grösse kauft
Gemessen haben wir mit Prüfungen, deren Ergebnis man nachzählen kann: Rechenaufgaben in Textform, kleine Programmieraufgaben mit ausführbarer Lösung, und deutsche Wissensfragen im Multiple-Choice-Format. Angegeben ist jeweils der Anteil richtiger Antworten. Die ersten vier Zeilen stammen aus derselben Modellfamilie und liefen ohne Quantisierung. Die fünfte ist das Modell, das wir auf dieser Maschine tatsächlich betreiben:
| Grösse | Rechnen | Programmieren | Deutsches Wissen |
|---|---|---|---|
| 0.8 Mrd. | 38 % | 18 % | 41 % |
| 2 Mrd. | 57 % | 22 % | 55 % |
| 4 Mrd. | 73 % | 39 % | 66 % |
| 9 Mrd. | 87 % | 55 % | 74 % |
| 27 Mrd. (4-Bit, neuere Generation) | 66 % | 74 % | 82 % |
Unter neun Milliarden Parametern taugt ein Modell nicht für professionelle Arbeit. Vier Milliarden lösen keine zwei von fünf Programmieraufgaben und kennen ein Drittel der deutschen Wissensfragen nicht. Zum Zusammenfassen und Sortieren reicht das. Sobald sich jemand auf das Ergebnis verlässt, wird es zu wenig.
Brauchbar wird es in der Klasse um dreissig Milliarden. Das 27-Milliarden-Modell löst drei von vier Programmieraufgaben, wo das 9-Milliarden-Modell gerade die Hälfte schafft. Genau diese Klasse passt auf 48 GB Grafikspeicher. Beim Rechnen fällt es mit 66 gegen 87 Prozent aus der Reihe. Dafür sprechen drei Gründe, und keiner davon ist beruhigend: Das Modell gehört einer anderen Generation an als die Modelle in den Zeilen darüber, es lief auf 4 Bit quantisiert statt unquantisiert, und es denkt vor dem Antworten, wofür wir ihm kein zusätzliches Token-Budget gegeben haben. Diese Zeile verdient eine Nachmessung.
Für die schwersten Aufgaben brauchen Sie mehr als hundert Milliarden Parameter. Und damit sind wir beim eigentlichen Thema, denn die Hardware ist zu diesem Zeitpunkt längst gekauft.
Was das Tempo bestimmt: aktive Parameter und Bandbreite
Ab hier ändert sich die Frage. Die 48 GB entscheiden, welches Modell überhaupt hineinpasst. Wie schnell es dann antwortet, entscheiden zwei andere Grössen: wie viele Parameter pro Wort tatsächlich rechnen, und wie schnell die Karte ihren Speicher liest.
Die erste Grösse zeigen zwei Modelle auf derselben Maschine, unter derselben Last, mit acht gleichzeitigen Nutzern. Verändert wird nur das Modell.
| Konfiguration | Tokens pro Sekunde und Person | Wartezeit bis zum ersten Zeichen |
|---|---|---|
| Qwen3.6-35B (MoE), ganz auf den Karten | 104.6 | 1.6 s |
| Qwen3.6-27B, ganz auf den Karten | 51.6 | 5.8 s |
Das grössere Modell ist doppelt so schnell und lässt seine Nutzer ein Viertel so lange warten. Qwen3.6-35B rechnet pro Wort mit drei seiner 35 Milliarden Parameter, das 27-Milliarden-Modell mit allen. Für den Speicherbedarf zählt die Gesamtzahl, fürs Tempo die aktive. Genau deshalb empfehlen wir in dieser Klasse MoE-Modelle: Sie belegen den Speicher eines grossen Modells und rechnen im Tempo eines kleinen.
Die zweite Grösse ist die Speicherbandbreite, und sie erklärt eine Überraschung beim Hardwarekauf. Für jedes einzelne Wort müssen die aktiven Gewichte einmal durch den Speicher der Karte. Eine RTX 4090 liest dafür rund 1’000 GB pro Sekunde. Nvidias L4, eine verbreitete Rechenzentrumskarte mit gleich viel Speicher, kommt auf 300 GB pro Sekunde (Herstellerangaben). Für Inferenz heisst das: Die teurere Serverkarte antwortet langsamer als die Gaming-Karte. Sie ist auf 72 Watt, halbe Bauhöhe und Dauerbetrieb ausgelegt, nicht auf Bandbreite.
Solange das Modell ganz auf die Karten passt, gibt es also keinen Handel zwischen Qualität und Tempo. Der beginnt erst, wenn es nicht mehr passt, und genau das messen wir weiter unten am 284-Milliarden-Modell.
Jetzt zu Ihrer Zahl aus der zweiten Frage. Neben dem Modell belegt auch jedes laufende Gespräch Platz auf der Karte, denn das Modell muss den bisherigen Verlauf mitführen. Dieser Zwischenspeicher heisst KV-Cache, und er wächst mit der Textlänge und mit jedem gleichzeitigen Nutzer.
Er erklärt, warum zwei Karten mehr bringen als eine. Auf einer einzelnen RTX 4090 belegt ein 27-Milliarden-Modell so viel Platz, dass für alle Gespräche zusammen noch etwa 15’000 Tokens bleiben, also nicht einmal eine einzige längere Anfrage. Auf zwei Karten sind es 337’000. Die zweite Karte macht das Modell nicht klüger, sie macht es betreibbar.
Gemessen mit realistischer Last, also je Anfrage 10’000 Tokens Eingabe und 2’000 Tokens Antwort:
Die mittlere Spalte zählt alle Nutzer zusammen, die rechte misst, wie schnell der Text bei einer einzelnen Person erscheint. Die beiden lassen sich nicht ineinander umrechnen, weil eine Anfrage einen Teil ihrer Zeit mit Lesen statt mit Schreiben verbringt.
| Gleichzeitige Anfragen | Tokens pro Sekunde insgesamt | Je Person | Längste Wartezeit |
|---|---|---|---|
| 1 | 65.8 | 74.3 | 3.5 s |
| 4 | 169.0 | 59.7 | 13.7 s |
| 8 | 240.6 | 51.4 | 27.5 s |
| 16 | 301.6 | 39.3 | 55.1 s |
Der Gesamtdurchsatz steigt bis zuletzt, und das Schreibtempo je Person bleibt lesbar. Was kippt, ist die längste Wartezeit: von 3.5 auf 55 Sekunden. Bei 10’000 Tokens Eingabe verbringt die Karte den grössten Teil ihrer Zeit mit dem Lesen der Anfragen, und diese Lesephasen behindern einander.
Acht gleichzeitige Anfragen bewältigt die Maschine gut. Bei sechzehn steigt die längste Wartezeit auf 55 Sekunden, und niemand kann mehr verlässlich zusagen, wie lange eine Antwort dauert. Liegt Ihre Zahl aus der zweiten Frage darunter, passt die Maschine.
Der Extremfall: 284 Milliarden Parameter
Wie weit sich das treiben lässt, zeigt der äusserste Fall. DeepSeek V4 Flash hat 284 Milliarden Parameter und 51.8 Indexpunkte, holt also gut zwei Drittel des Rückstands auf die offene Spitze auf. Läuft so ein Modell auf einer Maschine für 8’500 Franken?
Es läuft. In 10.9 GB Grafikspeicher.
Möglich macht das die Bauart in ihrer äussersten Form. Der volle Name lautet DeepSeek-V4-Flash-284B-A13B: gespeichert werden 284 Milliarden Parameter, gerechnet wird pro Wort mit 13 Milliarden. Bei einem solchen Verhältnis dürfen die selten gebrauchten Experten im billigen Arbeitsspeicher liegen, und nur die gerade benötigten wandern zur Grafikkarte. Genau dafür stehen die 128 GB Arbeitsspeicher in der Einkaufsliste.
Bezahlt wird das mit Zeit. Wir haben eine einzelne deutsche Frage gestellt und mitgestoppt: Nach 10.7 Sekunden begann das Modell zu arbeiten, sichtbar wurde das erste Zeichen nach 37.3 Sekunden, und die dreisätzige Antwort stand nach 53.9 Sekunden. Dazwischen lagen 196 Denk-Tokens, die niemand zu sehen bekommt.
Der Balken zählt herunter, und genau das ist die Erfahrung: gut eine halbe Minute vor einem leeren Bildschirm. Hier zeigt sich die Abwägung, die es bei den Modellen auf der Karte nicht gab. Dieselbe Maschine, die mit dem 35-Milliarden-Modell 104.6 Tokens pro Sekunde und Person lieferte, schreibt jetzt 7.9, und die Wartezeit steigt von 1.6 auf 37.3 Sekunden. Der Grund ist nicht die Parameterzahl an sich: Die Experten liegen im Arbeitsspeicher, und der ist um ein Vielfaches langsamer angebunden als der Speicher der Grafikkarte.
Was das für Ihr Unternehmen heisst
Für einen Betrieb mit zwanzig bis dreissig Mitarbeitenden, der Korrespondenz schreibt, Dokumente durchsucht und übersetzt, ist eine eigene Maschine machbar. Sie kostet rund 8’500 Franken, steht unter einem Schreibtisch und liefert ein Modell auf dem Niveau von GPT-5.1. Wer daneben anspruchsvoll programmieren oder Agenten über lange Ketten laufen lassen will, kauft diesen Teil weiter ein.
Braucht eine Aufgabe mehr Qualität und darf sie warten, kommen Modelle bis zu 284 Milliarden Parametern infrage, die nachts laufen. Vor einem Jahr lief ein Modell dieser Klasse nur im Rechenzentrum.
Für die Modellwahl lautet unsere Empfehlung: MoE vor Dense, weil das Verhältnis von Qualität zu Tempo dort am besten ausfällt. Heute heisst das Qwen. In ein paar Monaten heisst es etwas anderes, und dann ist dieser Absatz veraltet. Schauen Sie deshalb selbst auf die Rangliste und messen Sie den Kandidaten auf Ihren eigenen Aufgaben nach, bevor Sie sich festlegen.
Zwei Dinge zum Schluss, die in keiner Messreihe stehen. Erstens die Rechnung: Über drei Jahre muss die Maschine rund 39 Prozent der Zeit unter Volllast arbeiten, damit sie günstiger ist als Schweizer Anbieterpreise, über zwei Jahre 57 Prozent. Wie diese Zahlen zustande kommen, rechnen wir im letzten Teil dieser Serie vor. Zweitens eine Frage, an der in unseren Mandaten regelmässig ganze Vorhaben hängen: Wer betreibt die Maschine, wenn sie an einem Freitagabend nicht mehr antwortet?
Wer beides beantwortet hat, kann entscheiden. Der Grund für ein Ja liegt nach unseren Zahlen bei der Kontrolle über die Daten, kaum je beim Preis.
Aus den Messungen ergibt sich ein Vorgehen in vier Schritten. Gehen Sie sie in dieser Reihenfolge durch, bevor Sie Hardware bestellen:
- 01
Die Aufgaben festhalten
Zehn bis zwanzig echte Vorgänge aus Ihrem Alltag aufschreiben, mit der typischen Dokumentlänge. Ohne diese Liste lässt sich weder Modell noch Hardware sinnvoll wählen.
- 02
Die gleichzeitigen Anfragen schätzen
Von der Zahl gleichzeitig aktiver Personen und ihren Denkpausen her rechnen. An dieser Zahl hängen die Grafikkarten.
- 03
Mit gemieteter Hardware messen
Eine GPU-Stunde bei einem Schweizer oder europäischen Anbieter kostet wenige Franken. Erst wenn Ihre eigenen Aufgaben dort sauber laufen, lohnt sich der Kauf.
- 04
Den Betrieb besetzen
Updates, Modellwechsel, Überwachung und Wiederanlauf sind wiederkehrende Arbeit. Klären Sie, wer sie übernimmt, bevor die Karten bestellt sind.
Die weiteren Teile der Serie vertiefen, was hier nur anklang: die Speicherrechnung, die Quantisierung, die Wahl der Engine und zum Schluss die Kostenfrage.
Für die Geschäftsleitung
Dieses Dossier als PDF
Den vollständigen Beitrag plus eine kompakte Management-Zusammenfassung und Checkliste, als PDF zum Speichern und Weiterleiten.
Sie erhalten das PDF sofort. Mit dem Absenden stimmen Sie zu, dass Souverana Sie zu diesem Thema kontaktieren darf. Verarbeitung in der Schweiz/EU, keine Weitergabe an Dritte, Widerruf jederzeit (revDSG).
Häufige Fragen
- Was leistet ein selbst gehostetes LLM?
- Auf einer Workstation für rund 8'500 Franken läuft ein offenes Modell, das im Intelligence Index von Artificial Analysis, einer Vergleichsseite für KI-Modelle, 37.7 Punkte erreicht und damit gleichauf mit GPT-5.1 liegt. Es schreibt und übersetzt Texte und durchsucht Dokumente, genug für zwanzig bis dreissig Mitarbeitende.
- Wofür reicht ein lokales Sprachmodell nicht?
- Für anspruchsvolles Programmieren und für lange Aufgabenketten, bei denen die KI selbständig zwanzig Werkzeuge hintereinander bedient und jeder Aufruf stimmen muss. Ein einziger Formatfehler bricht die ganze Kette ab. Diese Arbeit kaufen Sie weiterhin bei einem Anbieter ein.
- Wie viel VRAM braucht ein Modell mit 27 Milliarden Parametern?
- Quantisierung speichert die Gewichte des Modells, also seine Zahlenwerte, mit wenigen Bit. In 4-Bit-Fassung belegen sie rund 19 GB Grafikspeicher. Auf einer einzelnen 24-GB-Karte bleibt danach fast kein Platz für laufende Gespräche. Auf zwei Karten verteilt sind es 9.7 GB pro Karte, und es bleibt deutlich mehr Raum.
- Für wie viele Mitarbeitende reicht eine Workstation mit zwei RTX 4090?
- Massgeblich ist die Zahl der Anfragen, die gleichzeitig laufen. Acht Anfragen mit je 10'000 Tokens Eingabe (Tokens sind die Textbausteine, die ein Modell verarbeitet) bewältigt die Maschine gut, bei sechzehn steigt die längste Wartezeit auf 55 Sekunden. Zwanzig bis dreissig Mitarbeitende erzeugen selten mehr als acht.
- Warum ist ein grösseres Modell manchmal schneller als ein kleineres?
- Weil fürs Tempo nur die aktiven Parameter zählen, also jene, die pro Wort rechnen. Ein Mixture-of-Experts-Modell (MoE) besteht aus vielen Teilmodellen und nutzt pro Wort nur wenige. Das MoE-Modell mit 35 Milliarden Parametern rechnete mit drei Milliarden und war doppelt so schnell wie ein Modell mit 27 Milliarden, das alle nutzt. Der Grafikspeicher muss für die volle Grösse reichen.
- Ist selbst hosten günstiger als eine API?
- Selten. Die Maschine muss über drei Jahre rund 39 Prozent der Zeit unter Volllast arbeiten, damit sie günstiger ist als die Preise Schweizer Anbieter, die Modelle pro Nutzung vermieten, über zwei Jahre 57 Prozent. Personalkosten für den Betrieb sind dabei noch nicht eingerechnet.
Diesen Beitrag teilen
Fertig formatierte Grafiken und ein Textvorschlag für Ihren LinkedIn-Post: herunterladen, kopieren, posten.
Textvorschlag
Überlegen Sie, ein Sprachmodell im eigenen Betrieb zu betreiben? Die erste Frage ist meist, ob die Qualität überhaupt reicht.

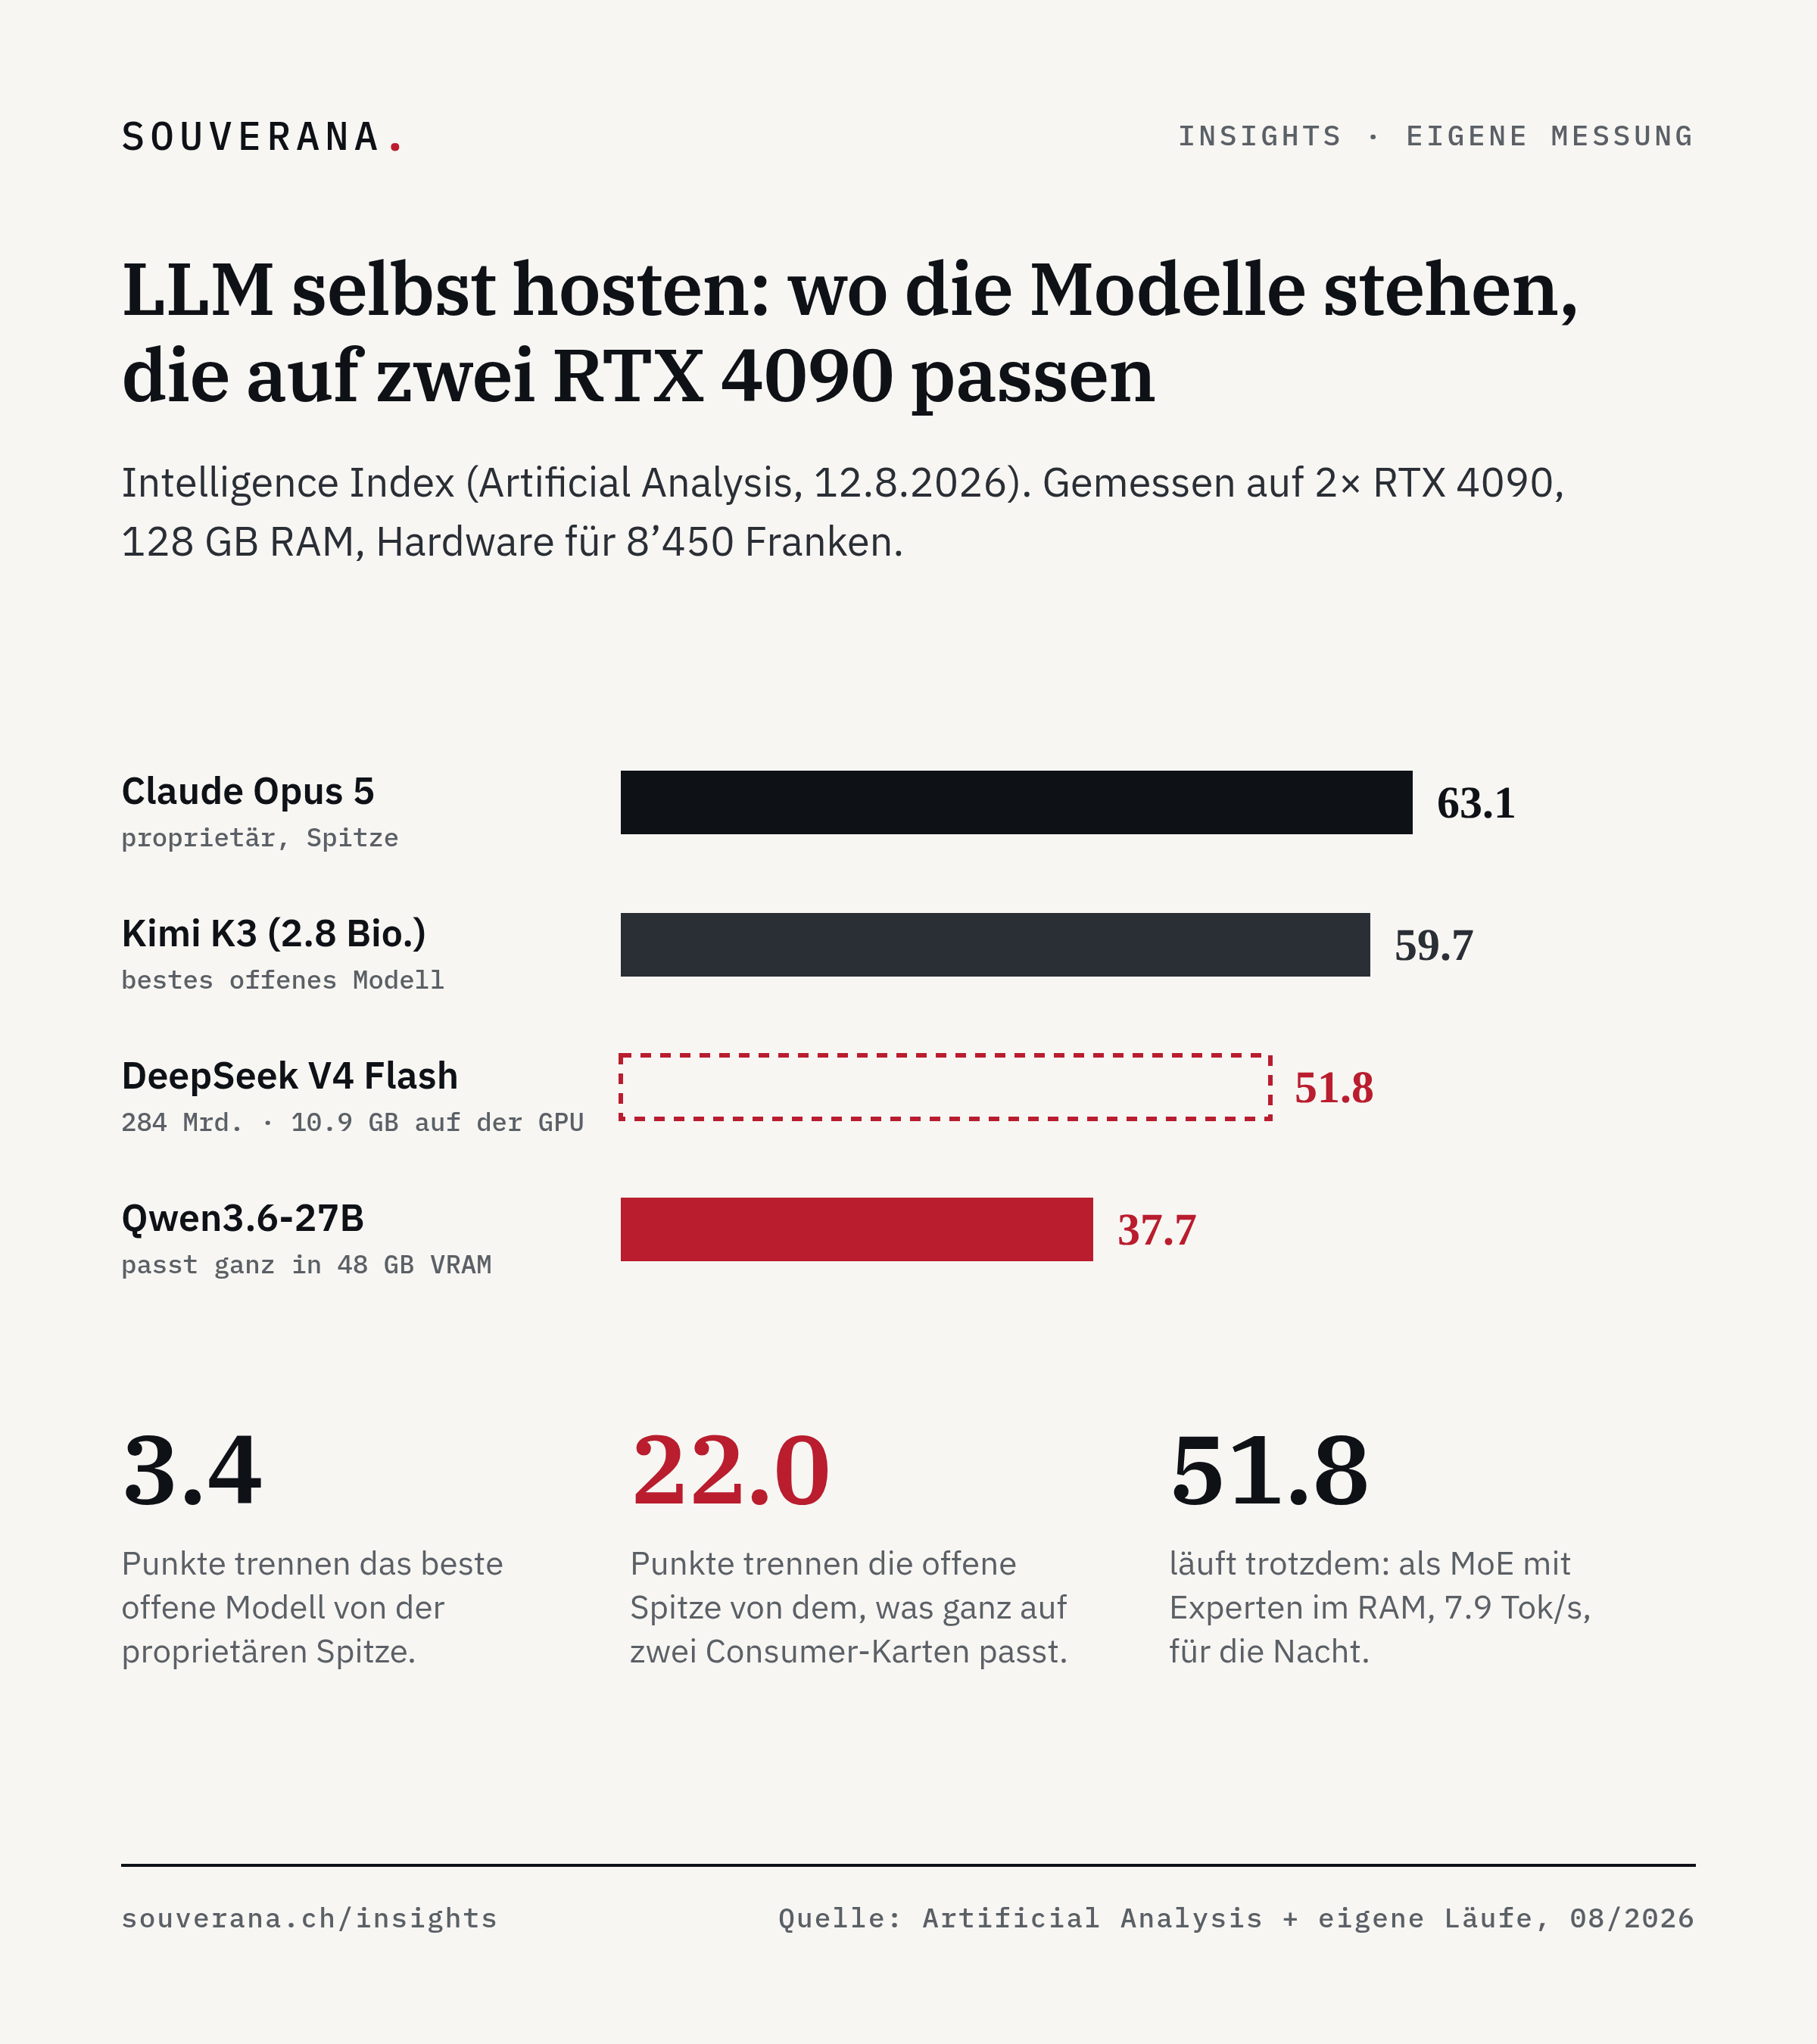
Die Schlagzeilen legen nahe, dass sie das tut: Offene Modelle, deren Gewichte frei herunterladbar sind, liegen im Intelligence Index von Artificial Analysis, einem Leistungsvergleich für KI-Modelle, nur noch 3.4 Punkte hinter den geschlossenen Spitzenmodellen (12.8.2026). Diese Zahl gilt allerdings für Modelle mit Billionen von Parametern, die niemand unter den Schreibtisch stellt.

Wir haben deshalb gemessen, was auf einer Maschine für 8'450 Franken mit zwei Grafikkarten vom Typ RTX 4090 tatsächlich läuft. Das beste Modell, das ganz in die 48 GB Grafikspeicher passt, ist Qwen3.6-27B von Alibaba mit 37.7 Punkten, dem Niveau von GPT-5.1 (OpenAI). Von der offenen Spitze trennen es 22 Punkte. Ein Sonderfall bleibt DeepSeek V4 Flash, ein Modell aus vielen Teilmodellen (Mixture-of-Experts), dessen selten gebrauchte Teile im Arbeitsspeicher liegen. Es erreicht 51.8 Punkte bei 7.9 Tokens pro Sekunde, taugt also für den Nachtbetrieb und ist für einen Dialog zu langsam.

Unser Schluss: Für Briefe, Dokumentensuche und Übersetzungen im eigenen Betrieb reicht das heute. Anspruchsvolles Programmieren und lange Aufgabenketten mit vielen Werkzeugaufrufen kaufen Sie vorerst weiter ein.

Im Beitrag stehen die Einkaufsliste, alle Messwerte und die Erklärung, warum ein grösseres Modell schneller sein kann als ein kleineres. Link in den Kommentaren.

#KI #Datensouveränität #LLM #Schweiz