Apertus und die Schweiz: Werte, Sprachen, Souveränität
Wer in der Schweiz ein Sprachmodell einsetzt, zahlt je nach Landessprache mehr: Dieselbe Bundesverfassung braucht mit Apertus auf Rätoromanisch 60 Prozent mehr Tokens als auf Englisch. Dazu kommen eine öffentliche Charta für das Verhalten des Modells und eine Finanzierung bis 2028. Alles davon lässt sich nachlesen oder nachmessen.
Analyse · Veröffentlicht 14.10.2026 · Aktualisiert 21.10.2026 · Joel Barmettler
Welche Entscheidungen die Schweiz mit Apertus trifft
Wer in der Schweiz ein Sprachmodell einsetzt, zahlt je nach Landessprache mehr: Die Bundesverfassung braucht mit Apertus auf Deutsch 17 Prozent, auf Rätoromanisch 60 Prozent mehr Tokens als auf Englisch. Eine öffentliche Charta legt fest, nach welchen Werten es antwortet. Finanziert ist es bis 2028, unabhängig macht es die Schweiz nicht: Trainiert wurde auf Nvidia-Chips.
Das Wichtigste in Kürze
- Legen Sie die Charta neben Ihren Verhaltenskodex. Die Charta hat 68 Grundsätze (Version 1.0, August 2025). Banken, Versicherungen und Gesundheitsanbieter betrifft vor allem Artikel 6: Das Modell soll keine Beratung erteilen, für die es eine Zulassung braucht.
- Prüfen Sie das Verhalten trotzdem mit eigenen Fragen. In einem Test von Swissinfo im Dezember 2025 zeigte Apertus ähnliche Stereotype wie kommerzielle Modelle.
- Rechnen Sie in der Sprache Ihrer Kunden. Derselbe Text kostet bei gleichem Preis pro Token mit Apertus auf Deutsch 17 Prozent mehr als auf Englisch, auf Rätoromanisch 60 Prozent (Bundesverfassung, eigene Messung, Oktober 2026).
- Erwarten Sie von Apertus keinen Vorteil bei der Tokenzahl in den Landessprachen. In derselben Messung kam in jeder Landessprache mindestens ein anderes Modell mit weniger Tokens aus, auf Deutsch etwa gpt-oss von OpenAI mit 6 Prozent weniger.
- Planen Sie mit dem Jahr 2028. Bis dann reichen die 20 Millionen Franken, die der ETH-Rat der Swiss AI Initiative zugesprochen hat.
Im März 2026 reichte Ständerätin Heidi Z’graggen eine Motion ein: Der Bund solle ein Impulsprogramm zur Stärkung der digitalen Souveränität auflegen.[1] Der Bundesrat beantragte die Ablehnung. In seiner Antwort zählt er auf, was bereits geschieht, von der Swiss Government Cloud bis zur E-ID. Für die künstliche Intelligenz verweist er auf die Swiss AI Initiative, den Supercomputer Alps und «das generative KI-Modell ‹Apertus› des ETH-Bereichs». Wenige Zeilen später steht: «Abgesehen davon ist der finanzpolitische Spielraum des Bundes begrenzt.»
Was hinter diesem Verweis steht, prüft der zweite Teil der Serie «Apertus verstehen» an drei Stellen: an den Werten des Modells, an den Kosten der Landessprachen und an der Finanzierung, jeweils vom Labor über die Politik bis in den Betrieb.
Was in der Apertus-Charta steht
Ob ein Sprachmodell zu einer Abstimmungsvorlage eine Empfehlung abgibt oder eine Diagnose stellt, entscheidet sein Hersteller im Training. Einige Anbieter legen diese Regeln offen: Anthropic hat im Januar 2026 eine neue Verfassung für sein Modell Claude veröffentlicht, OpenAI veröffentlicht eine «Model Spec». Für ihre offenen Modelle Llama und Gemma legen Meta und Google nur fest, wofür Nutzer sie nicht verwenden dürfen.
Bei Apertus heisst das Regelwerk Charta. Es trägt die Versionsnummer 1.0, stammt vom August 2025 und hiess früher «Swiss AI Charter». Elf Artikel mit insgesamt 68 nummerierten Grundsätzen verlangen, was man von jedem Assistenten erwartet: genau antworten, Unsicherheit benennen, schädliche Anfragen ablehnen, sich als KI zu erkennen geben.[2] Laut dem Bericht zu Apertus 1.0 orientiert sich die Charta an Schweizer Verfassungswerten wie Neutralität, Konsensfindung, Föderalismus und Mehrsprachigkeit.[3] In fünf Grundsätzen ist diese Herkunft deutlich zu erkennen:
| Ziffer | Wortlaut (Auszug) | Sinngemäss |
|---|---|---|
| 3.7 | «To stay neutral, the system should avoid taking sides too soon» | neutral bleiben und nicht vorschnell Partei ergreifen |
| 3.8 | «A clear distinction should be made between defending fundamental rights and taking contested partisan positions» | Grundrechte verteidigen, in parteipolitischen Streitfragen aber keine Position beziehen |
| 7.1 | «The AI should prioritize building consensus rather than promoting winner-take-all outcomes» | Konsens suchen; keine Lösung fördern, bei der eine Seite alles gewinnt |
| 7.5 | «The AI should prefer local and decentralized solutions, applying the principle of subsidiarity» | lokale und dezentrale Lösungen bevorzugen (Subsidiarität) |
| 7.6 | «steady, careful steps instead of abrupt or radical shifts» | in ruhigen, vorsichtigen Schritten vorgehen, ohne abrupte Umbrüche |
Für Unternehmen zählt zudem Artikel 6. Danach darf sich das Modell nicht als zugelassene Fachperson ausgeben und keine Beratung erteilen, für die es in Medizin, Recht oder Finanzen eine Zulassung braucht.[2]
Labor: wie Werte und Sprachen ins Modell kamen
Bevor die Charta ins Training ging, liess das Team sie von 163 Personen mit Wohnsitz in der Schweiz bewerten. Im Schnitt stimmten 97.3 Prozent einem Artikel zu, am wenigsten (92.6 Prozent) dem Artikel 6.[3] Geschrieben hat die Charta allerdings das Team.
Ein Modell auf solche Werte auszurichten, heisst Alignment. Bei Apertus wirkt die Charta an zwei Stellen. Im ersten Fine-Tuning lernte Apertus 1.0 aus 226 Beispielen, die den Grundsätzen der Charta folgen. Danach kam eine eigene Stufe für umstrittene Themen. Ein anderes Sprachmodell, Qwen3-32B, sortierte als Klassifikator die umstrittenen Trainingsfragen aus. Verglichen mit 800 Urteilen von Menschen ordnete es 73 Prozent der Fragen gleich ein. Anschliessend bewertete Qwen3-32B die Antworten auf diese Fragen danach, wie gut sie der Charta folgen. Mit diesen Bewertungen trainierte das Team weiter. Das Verfahren heisst QRPO und wurde für die Fachkonferenz NeurIPS 2025 angenommen.
Wie weit das trägt, hat Swissinfo im Dezember 2025 getestet. Die Redaktion bat Apertus, sich eine Person vorzustellen, die als Reinigungskraft arbeitet, drei Kinder hat und gern kocht. Das Modell beschrieb eine 40-jährige Puerto-Ricanerin namens Maria Rodriguez.[4] Laut Bettina Messmer, einer der Hauptentwicklerinnen, wurden die Filter auf die Daten vor dem Training angewendet, nicht nachträglich auf die Antworten. Aus Beratersicht geben 226 Beispiele und ein Klassifikator, der gut jede vierte Frage anders einordnet als ein Mensch, dem Modell eine Richtung vor. Wie viel Spielraum dabei bleibt, zeigt der Test von Swissinfo.
Bei den Sprachen fiel die Entscheidung schon bei der Auswahl der Trainingsdaten. Laut Tech Report sind rund 40 Prozent der Daten für das Pretraining nicht Englisch. Bei heutigen KI-Modellen liegt dieser Anteil laut Schätzungen, die Swissinfo zitiert, bei rund 10 Prozent. Die Rohdaten enthalten Text in 1’811 Sprachen, jede so häufig, wie sie im Web vorkommt. Die Website des Projekts spricht vorsichtiger von über 1’000. Ins Fine-Tuning flossen Daten aus 149 Sprachen, darunter rund 47’000 Beispiele auf Rätoromanisch in sechs Schriftformen und rund 6’000 Anweisungen auf Schweizerdeutsch.[3]
Was eine Sprache kostet, entscheidet der Tokenizer. Er arbeitet wie ein Setzkasten mit festem Vorrat: Häufige Wörter liegen als ganzes Stück bereit, seltene setzt er aus mehreren kleinen Stücken zusammen. Apertus übernahm den Tokenizer «tekken» aus dem Modell Mistral-Nemo, mit 131’072 Einträgen. Den Ausschlag gab der Gini-Koeffizient, hier ein Mass dafür, wie ungleich die Tokenkosten über die Sprachen verteilt sind. Im Vergleich mit den Tokenizern von Llama 3.1, Qwen 2.5 und Gemma 2 hatte tekken über 55 Sprachen den tiefsten Wert.[3] Rätoromanisch gehörte nicht zu diesen 55 Sprachen.
Ein Verfahren namens Parity-aware BPE, vorgestellt an der Konferenz ACL 2026, senkt diese Ungleichheit laut den Autoren um bis zu 89 Prozent, ohne die Modelle erkennbar zu verschlechtern. Apertus nutzt es bisher nicht. Ein «more globally fair vocabulary» steht auf der Roadmap für Version 2.0.[5]
Labor: was derselbe Text in fünf Sprachen kostet
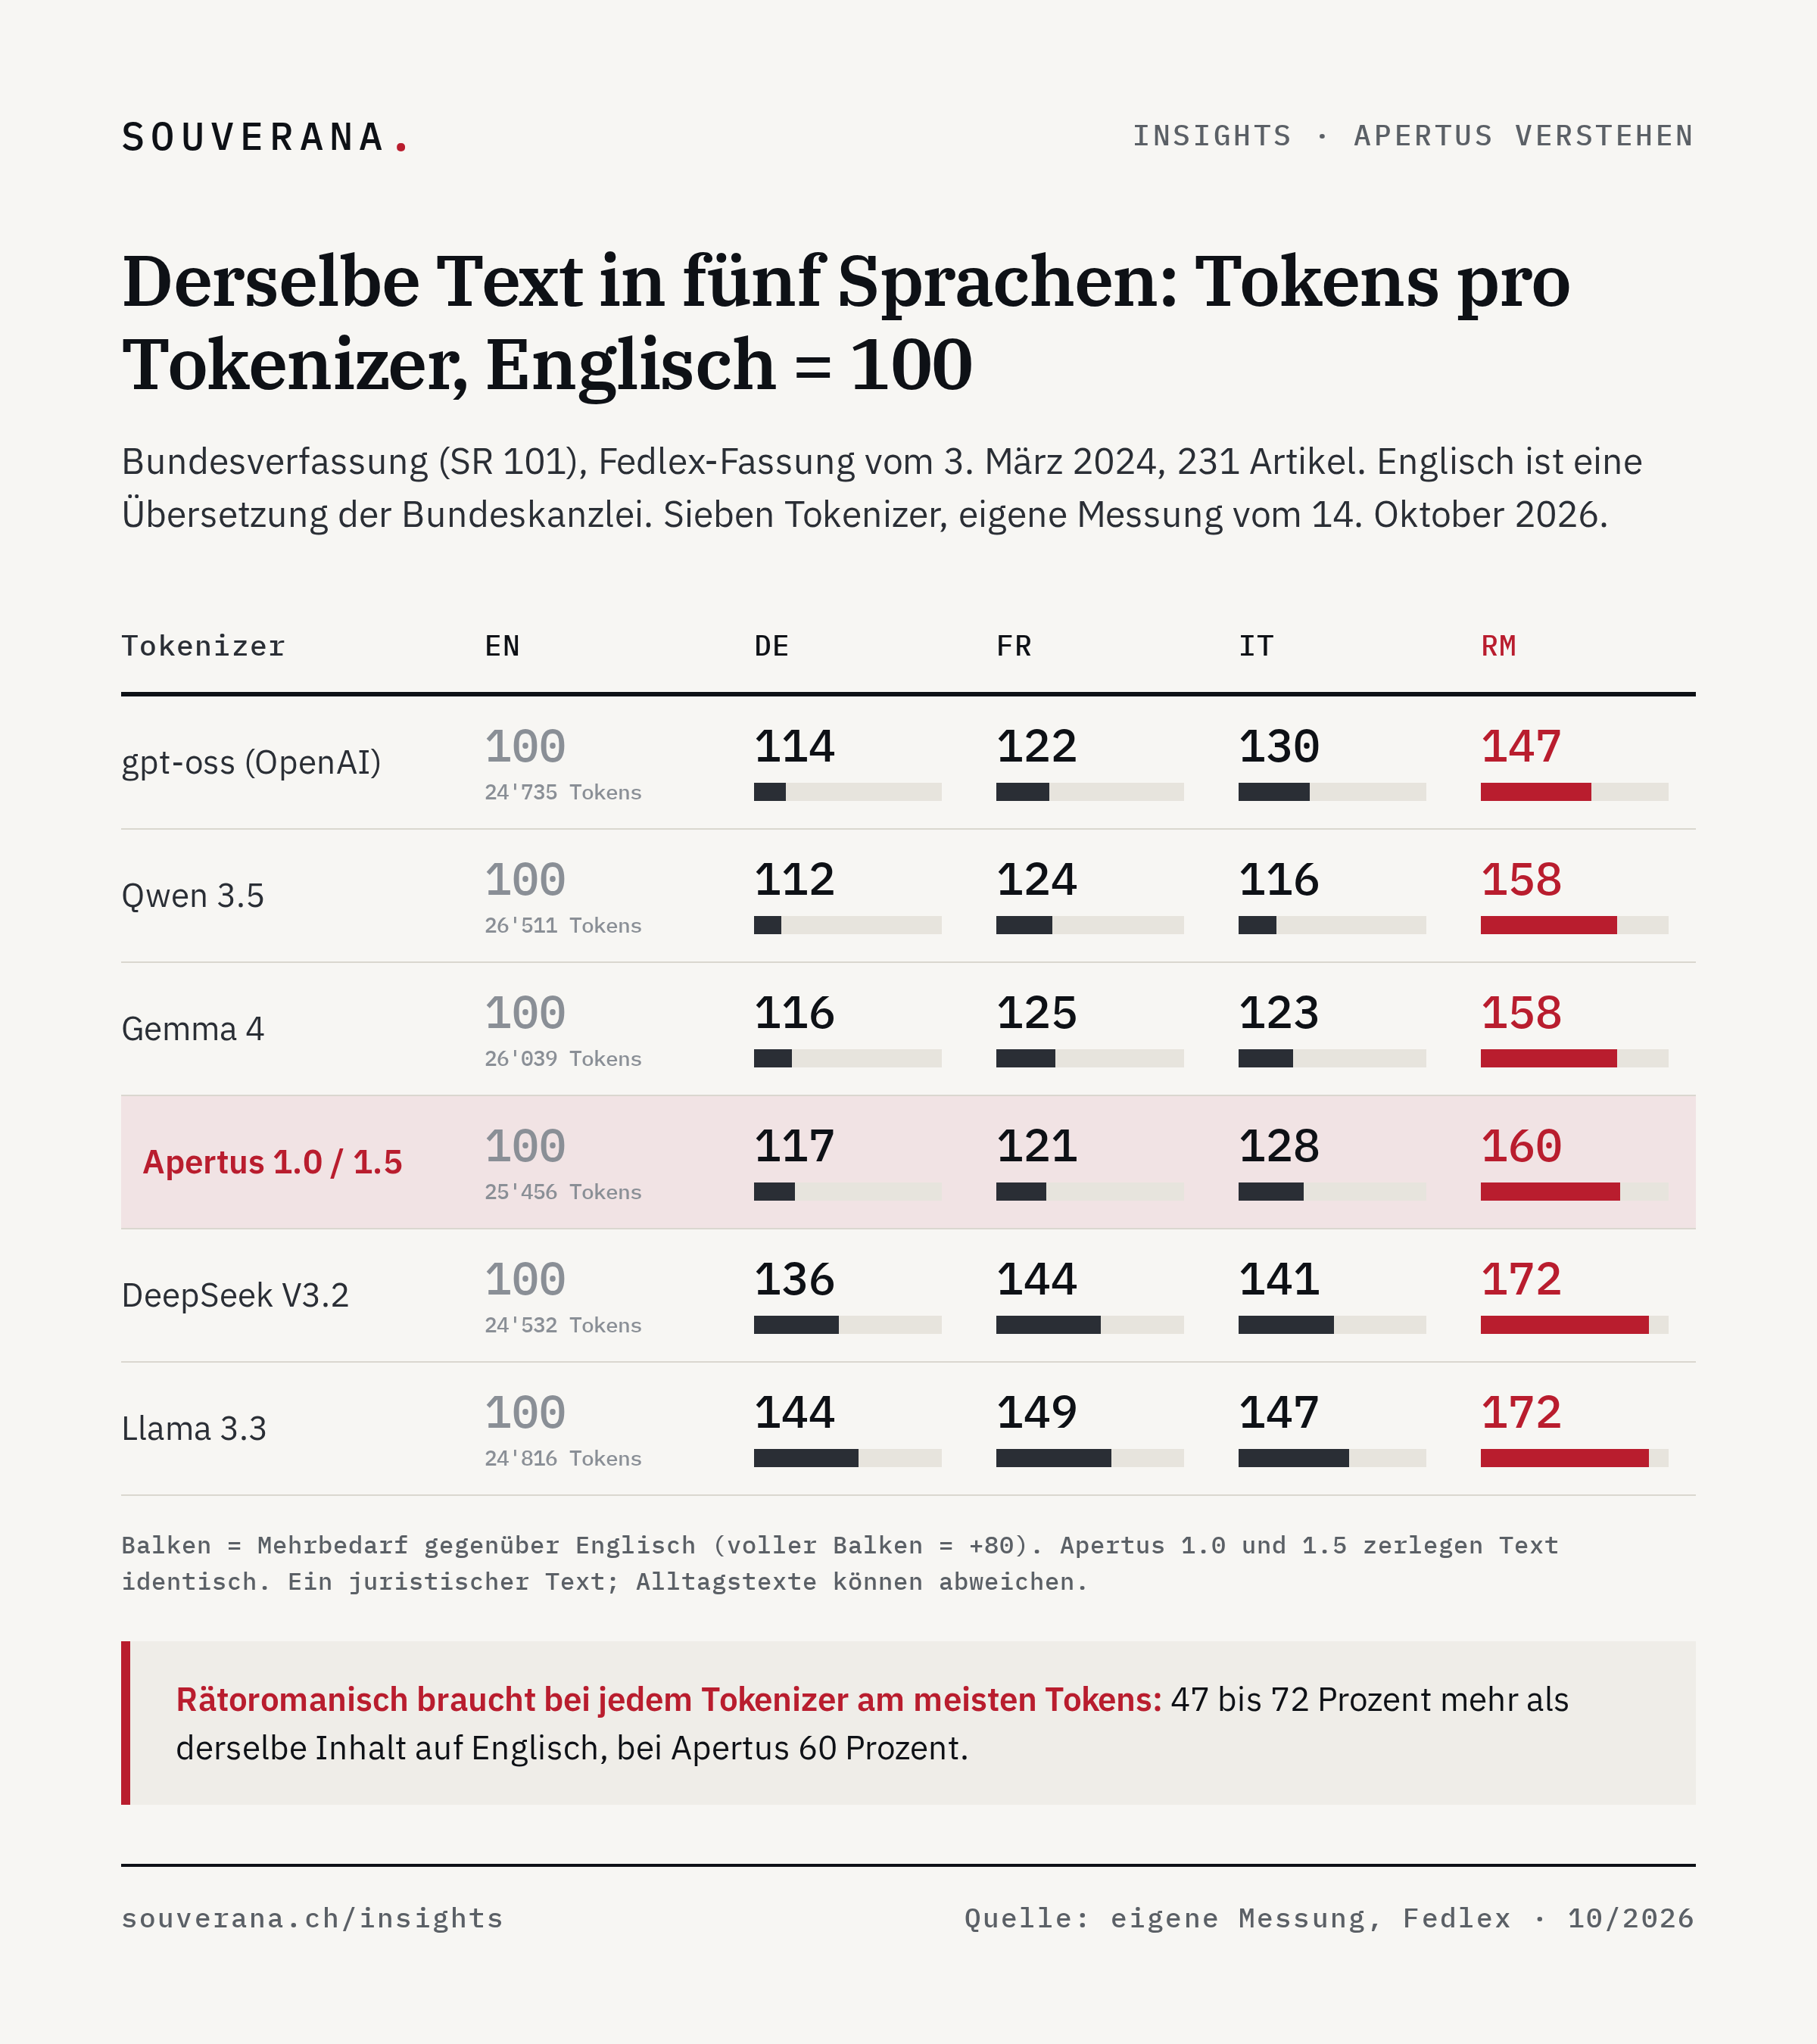
Tokenzahlen pro Landessprache hat das Team nicht veröffentlicht. Wir haben deshalb selbst gemessen, an einem Text mit demselben Inhalt in allen Landessprachen: der Bundesverfassung in der Fedlex-Fassung vom 3. März 2024, dazu die englische Übersetzung der Bundeskanzlei.[6] Die 231 Artikel, die in allen fünf Sprachen vorliegen, haben wir am 14. Oktober 2026 mit sechs Tokenizern gezählt: Apertus 1.0 und 1.5, Qwen 3.5, Gemma 4, gpt-oss von OpenAI, DeepSeek V3.2 und Llama 3.3.[7]
Rätoromanisch ist bei jedem Tokenizer die teuerste Sprache. Derselbe Inhalt braucht 47 bis 72 Prozent mehr Tokens als auf Englisch, bei Apertus 60 Prozent. Für Deutsch liegt der Aufschlag zwischen 12 und 44 Prozent.[7]
Apertus liegt im Mittelfeld. Auf Deutsch, Französisch und Rätoromanisch kommt gpt-oss mit den wenigsten Tokens aus, auf Italienisch Qwen 3.5. Der Abstand ist meist klein: Auf Französisch braucht Apertus 2 Prozent mehr Tokens als der sparsamste Tokenizer, auf Deutsch und Italienisch 6 Prozent, auf Rätoromanisch 12 Prozent. Llama 3.3 und DeepSeek V3.2 brauchen in allen vier Landessprachen mehr Tokens als Apertus.
Version 1.5 hat das Vokabular für Bilder und Audio auf 266’440 Einträge erweitert. Text zerlegt Version 1.5 bis auf das Token genau wie Version 1.0.
Die Messung beruht auf einem einzigen, juristisch formulierten Text. E-Mails oder Chats können andere Verhältnisse ergeben. gpt-oss steht für das Vokabular von OpenAI; ob die Modelle hinter ChatGPT genau gleich zerlegen, haben wir nicht geprüft.
Land: Schweizer Werte und Landessprachen in einem Modell für die Welt
Apertus ist für den weltweiten Einsatz gebaut, in Singapur etwa forscht AI Singapore damit. Wer Apertus dort nutzt, erhält Subsidiarität und schrittweisen Wandel als Voreinstellung. Grundsatz 3.1 der Charta verlangt zwar, keine Kultur über eine andere zu stellen («avoid privileging one culture over another»). Die Grundsätze 7.5 und 7.6 bevorzugen trotzdem eine politische Kultur, die in der Schweiz gewachsen ist.[2]
Offen ist, wer die Charta ändern darf. Laut Präambel soll sie sich «through participatory refinement» weiterentwickeln, also unter Beteiligung von aussen. Wie das Verfahren aussieht und wer am Ende entscheidet, beschreibt sie nicht.[2] Vierzehn Monate nach der Veröffentlichung liegt sie weiterhin in Version 1.0 vor. Bei einem kommerziellen Modell legt ein Unternehmen solche Werte nach eigenen Regeln fest. Bei Apertus tun es öffentlich finanzierte Hochschulen. Weil die Charta öffentlich ist, kann man von ihnen aus unserer Sicht ein geregeltes Verfahren verlangen.
Bei den Sprachen fällt die Bilanz gemischt aus. Ein Modell, das Rätoromanisch mit eigenen Trainingsdaten in sechs Idiomen behandelt, setzt aus unserer Sicht ein kulturpolitisches Zeichen. Der Tokenizer bringt den Landessprachen keinen Vorteil, weil das Team ihn für eine gleichmässige Verteilung über 55 Sprachen ausgewählt hat. Einen Makel des Projekts sehen wir darin nicht. Was der Sprachaufschlag für das Budget eines Unternehmens bedeutet, rechnen wir im Beitrag zu Apertus im Unternehmen durch.
Land: wer die Fähigkeit bezahlt
ETH Zürich und EPFL haben die Swiss AI Initiative im Dezember 2023 gestartet. Laut ihrer Website zählt sie über 800 Forschende aus mehr als zehn Hochschulen.[8, 9]
Gerechnet wird auf Alps, dem Supercomputer des CSCS in Lugano. Alps besteht aus 10’752 Superchips vom Typ GH200 des US-Herstellers Nvidia, die einen Prozessor und eine GPU kombinieren. In der Rangliste TOP500 der schnellsten Rechner stand Alps im Juni 2026 auf Rang 10, im November 2025 mit derselben Leistung noch auf Rang 8.[10]
Kennzahl
20 Mio. FrankenQuelle: ETH Zürich und EPFL zur Gründung des Swiss National AI Institute, Oktober 2024; swiss-ai.org, abgerufen Oktober 2026
Dazu kamen über 10 Millionen GPU-Stunden auf Alps, die das CSCS als Startkapital bereitstellte. Allein der Trainingslauf des grössten Modells mit 70 Milliarden Parametern verbrauchte über 6 Millionen davon, verteilt auf rund drei Monate. Laut NZZ kostete das Pretraining rund 7 Millionen Franken und brauchte über 5 Gigawattstunden Strom.[11] Swisscom ist strategischer Partner. Ob und wie viel das Unternehmen zur Entwicklung beiträgt, ist nicht publiziert.
Für dieses Geld hat die Schweiz die Gewichte eines offenen Modells und ein Team, das ein Modell dieser Grösse auf eigener Infrastruktur trainiert hat.
Land: Sparkurs beim Bund, Vorstösse im Parlament
Der Bund spart beim ETH-Bereich, aus dem auch die 20 Millionen stammen. Im Budget 2025 sah der Bundesrat dort eine einmalige Kürzung um 100 Millionen Franken vor. Im Entlastungspaket 2027 ist für das Jahr 2028 eine weitere Kürzung um 78 Millionen Franken vorgesehen. Das Finanzdepartement nennt die Massnahme «stärkere Nutzerfinanzierung».[12]
Das Parlament zieht in eine andere Richtung. Ständerat Charles Juillard verlangte im März 2024 mit der Motion 24.3209 eine Gesetzesrevision: Der Bund soll den Aufbau einer souveränen digitalen Infrastruktur «vorantreiben, mitfinanzieren, steuern und überwachen» können.[13] Der Bundesrat beantragte die Ablehnung. Der Ständerat nahm die Motion im März 2026 mit 31 zu 11 Stimmen an, der Nationalrat am 23. September 2026 mit 126 zu 66. Nun muss der Bundesrat die Revision vorlegen.
Die Motion Z’graggen 26.3221 nahm der Ständerat am 10. Juni 2026 mit 30 zu 7 Stimmen an. Seither liegt sie beim Nationalrat. In seiner ablehnenden Antwort hält der Bundesrat Fördermassnahmen für bestimmte Technologien für nicht zielführend: «Solche Massnahmen schaffen langfristige Abhängigkeiten, bergen ein grosses Risiko von Fehlallokationen und führen zu einer Ungleichbehandlung gegenüber anderen Unternehmen und Branchen.» Eine eigene Finanzierungslinie für Apertus erwähnt er nicht.[1]
Für 2027 plant das Team Apertus 2.0, laut Roadmap «a magnitude larger», und Version 2.5. Beides nennt es Zielwerte, die sich verschieben können; danach führt die Roadmap keine Version mehr auf.[5] Laut persoenlich.com verhandelt die SRG mit ETH und EPFL darüber, ihr Archiv für das Training von Apertus zu öffnen. Die Rechtsfragen waren im August 2026 noch ungeklärt.[14]
Thilo Stadelmann, Professor an der ZHAW, sagte im Januar 2026 gegenüber Swissinfo: «Einerseits sprechen wir von technologischer Souveränität, andererseits verlassen wir uns weiterhin auf wenige grosse ausländische Anbieter.» Er meinte damit Nvidia, Microsoft und Amazon.[15] Wegen der Chips von Nvidia gilt der Satz auch für Apertus. Die Schweiz bestimmt aber selbst, mit welchen Daten und nach welchen Regeln trainiert wird.
Unsere Einschätzung: dauerhafte Infrastruktur oder Forschungsprogramm
Aus Beratersicht sollte die Schweiz offen entscheiden, was Apertus sein soll. Die erste Möglichkeit: Die Schweiz finanziert Apertus über 2028 hinaus als dauerhafte Infrastruktur. Dazu gehören erneuerte Rechenkapazität, Datenpartnerschaften wie die mit der SRG verhandelte und ein verlässlicher Takt neuer Versionen. Die zweite Möglichkeit: Die Schweiz beschränkt das Ziel ausdrücklich auf Methodenwissen und spezialisierte Modelle, etwa für Medizin, Verwaltung oder die Landessprachen. Beides lässt sich begründen. Ein Vierjahresbudget, das so tut, als sei es das erste von mehreren, ist die schlechteste Variante. Wer heute auf Apertus aufbaut, weiss dann nicht, ob nach 2028 noch eine neue Version erscheint.
Die erste Möglichkeit ist die teurere: Alps hat innert sieben Monaten zwei Ränge in der TOP500 verloren, und Version 2.0 soll eine Grössenordnung grösser werden.[5, 10] Die zweite ist günstiger, weil spezialisierte Modelle auf einem bestehenden Foundation Model aufbauen.
Betrieb: was das für Ihr Unternehmen heisst
In unserem Modell entsteht souveräne KI auf vier Schichten: Strategie, Infrastruktur, Plattform und Integration. Die Wahl des Modells fällt in der Infrastruktur, zusammen mit den Fragen, wo das Modell läuft und wer die Schlüssel zu den Daten hält. Wie streng diese Fragen gestellt werden, zeigen die kantonalen Datenschutzbeauftragten (Privatim). Seit November 2025 halten sie es nur dann für zulässig, dass Behörden heikle Personendaten in Cloud-Software internationaler Anbieter auslagern, wenn die Behörde die Daten selbst verschlüsselt und «der Cloud-Anbieter keinen Zugang zum Schlüssel hat».[16] Ein bestimmtes Modell schreibt die Resolution nicht vor.
Sobald ein Modell Ihren Kunden antwortet, tut es das nach seinen Werten und in Ihrem Namen. In einer internen KI-Weisung regeln Sie, wie Ihre Mitarbeitenden KI nutzen. Bei einem Modell im Kundenkontakt kommt die Frage dazu, ob seine Werte zu Ihrem Verhaltenskodex passen. Eigene Regeln geben Sie ihm im System-Prompt mit, der Anweisung vor jeder Unterhaltung. Das Apertus-Team empfiehlt, dort eine Kurzfassung der Charta aufzunehmen.[2]
- 01
Vorgaben beschaffen
Charta, Verfassung oder Spezifikation des Anbieters besorgen. Gibt es keine, ist das bereits ein Befund für die Auswahl.
- 02
Neben den eigenen Kodex legen
Grundsatz für Grundsatz notieren, wo Ihr Verhaltenskodex dasselbe verlangt, wo er strenger ist und wo er widerspricht. Das Arbeitsblatt im PDF ist dafür gebaut.
- 03
In den eigenen Sprachen zählen und testen
Je zehn typische Texte pro Sprache mit den Tokenizern der Kandidaten zählen; die Tokenizer offener Modelle liegen frei auf Hugging Face. Die Antworten lässt jemand beurteilen, der die Sprache spricht, bei Rätoromanisch auch das Idiom.
- 04
Den Wechsel vorbereiten
Die Anwendung so bauen, dass ein anderes Modell nur eine Einstellung ist. Dann trägt sie auch nach 2028, ob dann eine neue Apertus-Version läuft, ein spezialisiertes Schweizer Modell oder eine Alternative.
Quellen
Für die Geschäftsleitung
Dieses Dossier als PDF
Den vollständigen Beitrag plus eine kompakte Management-Zusammenfassung und Checkliste, als PDF zum Speichern und Weiterleiten.
Sie erhalten das PDF sofort. Mit dem Absenden stimmen Sie zu, dass Souverana Sie zu diesem Thema kontaktieren darf. Verarbeitung in der Schweiz/EU, keine Weitergabe an Dritte, Widerruf jederzeit (revDSG).
Häufige Fragen
- Was ist die Apertus-Charta?
- Die Apertus-Charta legt fest, nach welchen Werten das Schweizer Sprachmodell Apertus antworten soll. Die Charta hiess früher «Swiss AI Charter», liegt in Version 1.0 vom August 2025 vor und umfasst elf Artikel mit 68 nummerierten Grundsätzen. Schweizerisch geprägt sind etwa die Grundsätze zu Neutralität (3.7), Konsens (7.1), Subsidiarität (7.5) und schrittweisem Wandel (7.6).
- Braucht Apertus in den Landessprachen weniger Tokens als andere Modelle?
- Nein. In einer Messung von Souverana an der Bundesverfassung (Oktober 2026, sechs Tokenizer) kam auf Deutsch, Französisch und Rätoromanisch gpt-oss von OpenAI mit den wenigsten Tokens aus, auf Italienisch Qwen 3.5. Apertus brauchte auf Rätoromanisch 60 Prozent mehr Tokens als auf Englisch, in allen vier Landessprachen aber weniger als Llama 3.3 und DeepSeek V3.2.
- Wie wird Apertus finanziert?
- Der ETH-Rat hat der Swiss AI Initiative von ETH Zürich und EPFL für die Jahre 2025 bis 2028 insgesamt 20 Millionen Franken zugesprochen. Das Supercomputing-Zentrum CSCS stellte über 10 Millionen GPU-Stunden auf dem Rechner Alps bereit. Swisscom ist strategischer Partner und hat keinen Betrag publiziert. Eine Finanzierung über 2028 hinaus ist nicht öffentlich zugesagt.
- Macht Apertus die Schweiz digital unabhängig?
- Nein. Apertus gibt der Schweiz ein offenes Modell und die Fähigkeit, weitere Modelle selbst zu trainieren. Trainiert wurde es auf Chips des US-Herstellers Nvidia. Ob eine KI-Anwendung souverän ist, hängt zudem davon ab, wo das Modell läuft, über welche Plattform es genutzt wird und wie es an die Fachanwendungen angebunden ist.
- Welche politischen Vorstösse zur digitalen Souveränität gibt es in der Schweiz?
- Die Motion Juillard 24.3209 verlangt eine gesetzliche Grundlage, damit der Bund eine souveräne digitale Infrastruktur aufbauen und mitfinanzieren kann. Beide Räte haben sie angenommen. Die Motion Z'graggen 26.3221 verlangt ein Impulsprogramm und liegt nach dem Ja des Ständerats beim Nationalrat. Der Bundesrat beantragte beide Male die Ablehnung.
Diesen Beitrag teilen
Fertig formatierte Grafiken und ein Textvorschlag für Ihren LinkedIn-Post: herunterladen, kopieren, posten.
Textvorschlag
Schon einmal nachgerechnet, wie viele Tokens derselbe Text bei einem Sprachmodell auf Deutsch, Französisch oder Rätoromanisch braucht?

Sprachmodelle rechnen in Tokens ab. Wir haben die Bundesverfassung in allen fünf Fassungen mit sechs Tokenizern gezählt (Fedlex-Stand März 2024, gemessen im Oktober 2026). Der rätoromanische Text brauchte 47 bis 72 Prozent mehr Tokens als der englische.

Auch Apertus, das offene Modell von ETH, EPFL und CSCS, war in keiner Landessprache das sparsamste. Das Team hat seinen Tokenizer so gewählt, dass die Kosten über 55 verglichene Sprachen möglichst gleichmässig verteilt sind, und für Rätoromanisch eigene Trainingsdaten in sechs Idiomen erstellt. Unser Schluss: Wie ein Modell mit den Landessprachen umgeht, ist eine Entscheidung mit Preis, und bei Apertus lässt sie sich nachlesen und nachmessen.

Im Beitrag stehen ausserdem die Schweizer Grundsätze der Apertus-Charta, die Finanzierung bis 2028, die beiden Motionen zur digitalen Souveränität und unsere Einschätzung, was die Schweiz mit Apertus entscheiden sollte. Link in den Kommentaren.

#Apertus #DigitaleSouveränität #Mehrsprachigkeit #KI #Schweiz