Apertus im Unternehmen: wo es heute trägt und wo nicht
Der Kanton Tessin hat laut Swissinfo entschieden, Verwaltungsdokumente mit Apertus übersetzen zu lassen. Bei Agenten liegt das Schweizer Modell nach dem Urteil der Tessiner Firma Artificialy noch hinter anderen offenen Modellen. Welche Aufgaben passen, was ein Einsatz kostet und wie Sie das an eigenen Daten prüfen.
Leitfaden · Veröffentlicht 14.10.2026 · Aktualisiert 21.10.2026 · Joel Barmettler
Wofür Apertus heute im Betrieb taugt
Für Übersetzungen in den Landessprachen taugt Apertus 1.5 heute, für Agenten, Code und Mathematik liegen laut Teambericht und Anwendern andere offene Modelle vorn. Das offene Modell von ETH Zürich, EPFL und CSCS läuft bei mehreren Schweizer Hostern und auf eigener Hardware.
Das Wichtigste in Kürze
- Beginnen Sie mit Übersetzungen in den Landessprachen. Die Tessiner Firma Artificialy zieht Apertus dafür anderen Modellen oft vor, besonders bei sensiblen Dokumenten (Swissinfo, September 2026).
- Planen Sie keine Agenten auf Apertus 1.5. Bei Abläufen, die das Modell in mehreren Schritten selbständig erledigt, liegt es laut Artificialy noch hinter anderen offenen Modellen.
- Rechnen Sie das Budget in Ihren Sprachen. Der italienische Text der Bundesverfassung braucht mit Apertus 28 Prozent mehr Tokens als der englische, bei gleichem Preis pro Token entsprechend höhere Kosten (Messung Souverana, Oktober 2026).
- Ein erster Test kostet wenig. Infomaniak verlangt für Apertus 1.5 70B 0.70 Franken pro Million Eingabe-Tokens und 2.50 Franken pro Million Ausgabe-Tokens (Stand Oktober 2026).
- Prüfen Sie die ganze Anwendung. In Tests der Zürcher Agentur Liip lag eine falsche Antwort auch an der Suche, die eine veraltete Quelle ausgewählt hatte.
Im März 2026 meldete das Apertus-Team, dass der Kanton Tessin sein Übersetzungswerkzeug für die Verwaltung umstellt: von Mixtral des französischen Anbieters Mistral AI auf Apertus. Die Tessiner Firma Artificialy hat dafür eine angepasste Fassung von Apertus-8B gebaut, dem kleineren Modell mit 8 Milliarden Parametern. Diese Fassung läuft auf Grafikkarten im Rechenzentrum des kantonalen Informatikzentrums CSI. Übersetzt wird unter anderem zwischen Italienisch, Deutsch, Französisch, Spanisch, Rumänisch und Ukrainisch. In einer ersten Phase testen rund 100 Angestellte das Werkzeug.[1]
In einem Test von Artificialy erreichte die angepasste Fassung 94 Prozent. Vor dem Fine-Tuning kam das 8B-Modell auf 90 Prozent, das grössere 70B-Modell ohne Fine-Tuning auf 92 Prozent.[1]
Dieser dritte Teil der Serie «Apertus verstehen» prüft, für welche weiteren Aufgaben sich Apertus eignet. Er geht dafür die drei Ebenen der Serie durch: was das Team im Labor gemessen hat, wer das Modell im Land schon einsetzt und was der Betrieb kostet.
Labor: was das Team für Version 1.5 angibt
Der Bericht zu Apertus 1.5 erschien am 11. Oktober 2026.[2] Alle Werte darin hat das Team selbst erhoben. Unabhängige Vergleiche gibt es bisher nur als Erfahrungsberichte von Anwendern.
Anweisungen befolgen. Unter den vollständig offenen Modellen seiner Klasse liegt das 8B-Modell bei Allgemeinwissen und kulturellem Wissen vorn. Beim Befolgen von Anweisungen übertrifft es laut Bericht alle verglichenen Modelle, auch jene, die nur ihre Gewichte offenlegen (Open Weight).[2] Diese Fähigkeit braucht eine Anwendung, wenn das Modell ein festes Format, einen Tonfall oder eine Länge einhalten soll.
Mathematik und Code. Hier führt laut demselben Bericht OLMo 3, ein vollständig offenes Modell des amerikanischen Instituts Ai2.[2] Den Denkmodus, den der erste Teil der Serie vorstellt, sollten Sie an eigenen Aufgaben prüfen. Beim 70B-Modell hebt er die Werte über alle Tests im Mittel um 6.6 Punkte. In einem Test mit naturwissenschaftlichen Fachfragen (GPQA) schneidet das 70B mit Denkmodus jedoch schlechter ab.
Bilder. Seit Version 1.5 verarbeitet Apertus auch Bilder, es ist also multimodal. Das 70B-Modell bringt hier laut Bericht wenig mehr als das 8B, obwohl es neunmal grösser ist.[2] Wer Bilder auswerten lassen will, kann deshalb mit dem 8B beginnen. Am schwächsten ist Apertus bei der Texterkennung in Bildern (OCR). Dort liegt es hinter anderen offenen Modellen. Für gescannte Dokumente setzen Sie besser ein eigenes OCR-Modell vor das Sprachmodell.
Kleine Modelle für Endgeräte. Die Modelle der Familie Apertus Mini hat das Team auch in komprimierten Fassungen für Grafikkarten von NVIDIA und für Geräte von Apple veröffentlicht. Dieses Verfahren heisst Quantisierung. Die komprimierten Dialogmodelle erreichen laut Mini-Bericht 90 bis 104 Prozent der Genauigkeit der unkomprimierten Fassung, gemessen mit wenigen Beispielen im Prompt.[3] Aus Beratersicht eignen sich diese kleinen Modelle für Notebooks ohne Netzverbindung und für einfache Aufgaben wie Zusammenfassen und Sortieren.
Land: wer Apertus schon einsetzt
Im Tessin profitiert laut Swissinfo das kantonale Migrationsamt am meisten vom neuen Übersetzungswerkzeug. Das Amt bearbeite persönliche Dokumente in vielen Sprachen und brauche genaue Übersetzungen mit starkem Datenschutz.
Damiano Binaghi leitet bei Artificialy das Deep Learning. «We often prefer Apertus to other models for our clients’ translation tasks, especially when they involve Switzerland’s four national languages or sensitive documents», sagte er im September 2026 gegenüber Swissinfo. Die Wahl begründet er mit der Qualität: «We’re not doing charity. We don’t use Apertus because we have to, but because it’s a good model.»
Vor dem Start von Version 1.5 haben 15 Organisationen die Gewichte des 8B- und des 70B-Modells geprüft, vertreten durch rund 50 Fachleute. Darunter waren das Bundesgericht, Swisscom, Switch, Infomaniak, Liip und Artificialy. Swisscom betreibt das 70B-Modell auf der Swiss AI Platform in einem Schweizer Rechenzentrum.
Auch die Forschung baut auf Apertus. Mit der medizinischen Pipeline MeditronFO der EPFL stieg das 70B-Modell im Mittel von vier medizinischen Tests von 47.2 auf 53.8 Punkte (Bericht der Autoren, arXiv:2605.16215).
In Singapur nutzt AI Singapore Apertus für die Forschung, weil man dort wissen müsse, mit welchen Daten ein Modell trainiert wurde. Den Preis dieser Offenheit benennt Leslie Teo von AI Singapore gegenüber Swissinfo selbst: «Being truly open-source means being unlikely to use some data, and this has consequences on performance and general capabilities.»
Betrieb: Erfahrungen, Preise und eigene Hardware
Was Anwender bemängeln
Die Agentur Liip hat Apertus in ZüriCityGPT getestet, einer KI-Suche, die Fragen der Bevölkerung zur Stadt Zürich beantwortet. Laut Josef Kruckenberg, der bei Liip die Projekte mit generativer KI leitet, gibt Version 1.5 nützlichere Antworten, befolgt Anweisungen besser und verweigert eher eine Antwort, wenn ihr Informationen fehlen. Beim Kriterium, das Liip am wichtigsten ist, liegt Apertus aber zurück. Es heisst Faithfulness, auf Deutsch Quellentreue: Jede Aussage einer Antwort muss durch die gefundenen Quellen gedeckt sein. «So far, we haven’t used Apertus in client projects. We felt it wasn’t ready yet», sagte Kruckenberg im September 2026 gegenüber Swissinfo.[4]
An einem Fehler aus diesen Tests war auch die Suche beteiligt. Auf eine Frage zur Einwohnerzahl Zürichs antwortete das System falsch, und die Suche hatte nicht die aktuellste Quelle ausgewählt. Bei einer Anwendung, die Antworten aus eigenen Dokumenten erzeugt (RAG), prüfen Sie deshalb Suche und Modell getrennt.
Auch Artificialy sieht Grenzen. Bei agentischen Fähigkeiten sei Apertus trotz beträchtlicher Fortschritte noch nicht auf dem Niveau anderer offener Modelle, sagt Binaghi. Gemeint sind Abläufe, die das Modell in mehreren Schritten selbständig erledigt. Federico Magnolfi leitet bei Artificialy die Sprachverarbeitung. Laut Swissinfo schätzt er, dass Version 1.0 beim Start rund zwei Jahre hinter den besten amerikanischen Modellen lag.[4]
Wo Apertus läuft und was es kostet
Auf seiner Liste vom September 2026 nennt das Apertus-Team sieben Schweizer Anbieter. Swisscom, Infomaniak, PHOENIQS und Safe Swiss Cloud hosten das 70B-Modell, stepping stone das 8B. OnPrem.ai installiert komprimierte Fassungen auf Servern des Kunden. Für die Schweizer Cloud Exoscale gibt es eine Anleitung, mit der Sie beide Grössen selbst betreiben.[5] Die Hoster bieten das Modell über eine Programmierschnittstelle (API) an, an die Sie Ihre eigene Anwendung anschliessen.
| Anbieter | Modell | Eingabe pro 1 Mio. Tokens | Ausgabe pro 1 Mio. Tokens |
|---|---|---|---|
| PHOENIQS (kvant) | Apertus 1.5 70B | CHF 0.6195 | CHF 2.2201[6] |
| Infomaniak | Apertus 1.5 70B | CHF 0.70 | CHF 2.50[7] |
| Swisscom | Apertus 70B | kein öffentlicher Preis | kein öffentlicher Preis |
Stand: Oktober 2026, öffentliche Preislisten der Anbieter.
Aus einem Preis geht nicht hervor, in welcher Präzision das Modell läuft. Fragen Sie danach, denn eine stark komprimierte Fassung kann schlechter antworten.
Auch das lange Kontextfenster hat einen Preis. Apertus 1.5 verarbeitet bis zu 262’144 Tokens auf einmal.[2] Beim 70B belegt ein Gespräch dieser Länge in voller Präzision (BF16) rund 86 GB Zwischenspeicher (KV-Cache). Das ist mehr, als eine Rechenzentrumskarte mit 80 GB fasst.
Was die Landessprachen an Tokens kosten
Ein Sprachmodell rechnet in Tokens ab. Sein Tokenizer zerlegt jeden Text zuerst in solche Stücke, je nach Sprache unterschiedlich fein. Gemessen haben wir das an der Bundesverfassung, die in allen vier Landessprachen und auf Englisch vorliegt. Die ganze Messung mit sechs Tokenizern steht im Beitrag über Apertus und die digitale Souveränität. Hier geht es um die Folgen für Rechnung und Kontextfenster.
Für den deutschen Text braucht Apertus 17 Prozent mehr Tokens als für den englischen, für den französischen 21 und für den italienischen 28 Prozent mehr.[8] Wer ein Budget mit englischen Testtexten rechnet und danach auf Deutsch arbeitet, unterschätzt die Tokenmenge um diesen Aufschlag. Auch ins Kontextfenster passt weniger: Vom deutschen Verfassungstext fasst es rund 15 Prozent weniger als vom englischen. Die Zahlen gelten für einen juristischen Text. E-Mails oder Chats können andere Verhältnisse ergeben.
Auch die Wahl des Modells verändert die Menge. Für den deutschen Text braucht Llama 3.3 von Meta 27 Prozent mehr Tokens als gpt-oss von OpenAI, das in dieser Messung auf Deutsch am wenigsten brauchte. Bei gleichem Preis pro Token wäre die Rechnung mit Llama 3.3 um 27 Prozent höher.[8]
Was ein Token kostet, legt jeder Anbieter selbst fest, und Modelle verbrauchen für dieselbe Aufgabe unterschiedlich viele Tokens. Wie diese Grössen zusammenwirken, zeigt unser Beitrag zu den Kosten pro Token. Für die Modellwahl heisst das: Zählen Sie die Tokens Ihrer eigenen Texte in Ihren Sprachen und rechnen Sie erst danach mit dem Preis des Anbieters.
Apertus auf eigener Hardware
Das 8B-Modell der Version 1.0 lief in unserer Messung vom August 2026 auf einer einzelnen Grafikkarte (GPU), einer RTX 4090 mit 24 GB. Gemessen haben wir eine typische RAG-Last: Acht Nutzer stellten gleichzeitig Fragen zu denselben 8’000 Tokens Kontext. Die Server-Software vLLM verarbeitet den gemeinsamen Anfang aller Anfragen auf Wunsch nur einmal und speichert ihn zwischen. Diese Funktion heisst Prefix-Caching. Mit ihr fiel die Wartezeit bis zum ersten Zeichen (Time to first token) von 17.9 auf 0.9 Sekunden.[9]
Kennzahl
17.9 → 0.9 sQuelle: Eigene Messung, August 2026
Bei Apertus funktioniert Prefix-Caching, weil das Modell nur aus einer Art von Schichten besteht. Bei Hybridmodellen, die verschiedene Schichttypen mischen, schaltet vLLM das Prefix-Caching ab. Die ganze Messreihe steht in unserem Vergleich der Server-Software.
Die Einschätzung nach Aufgabe
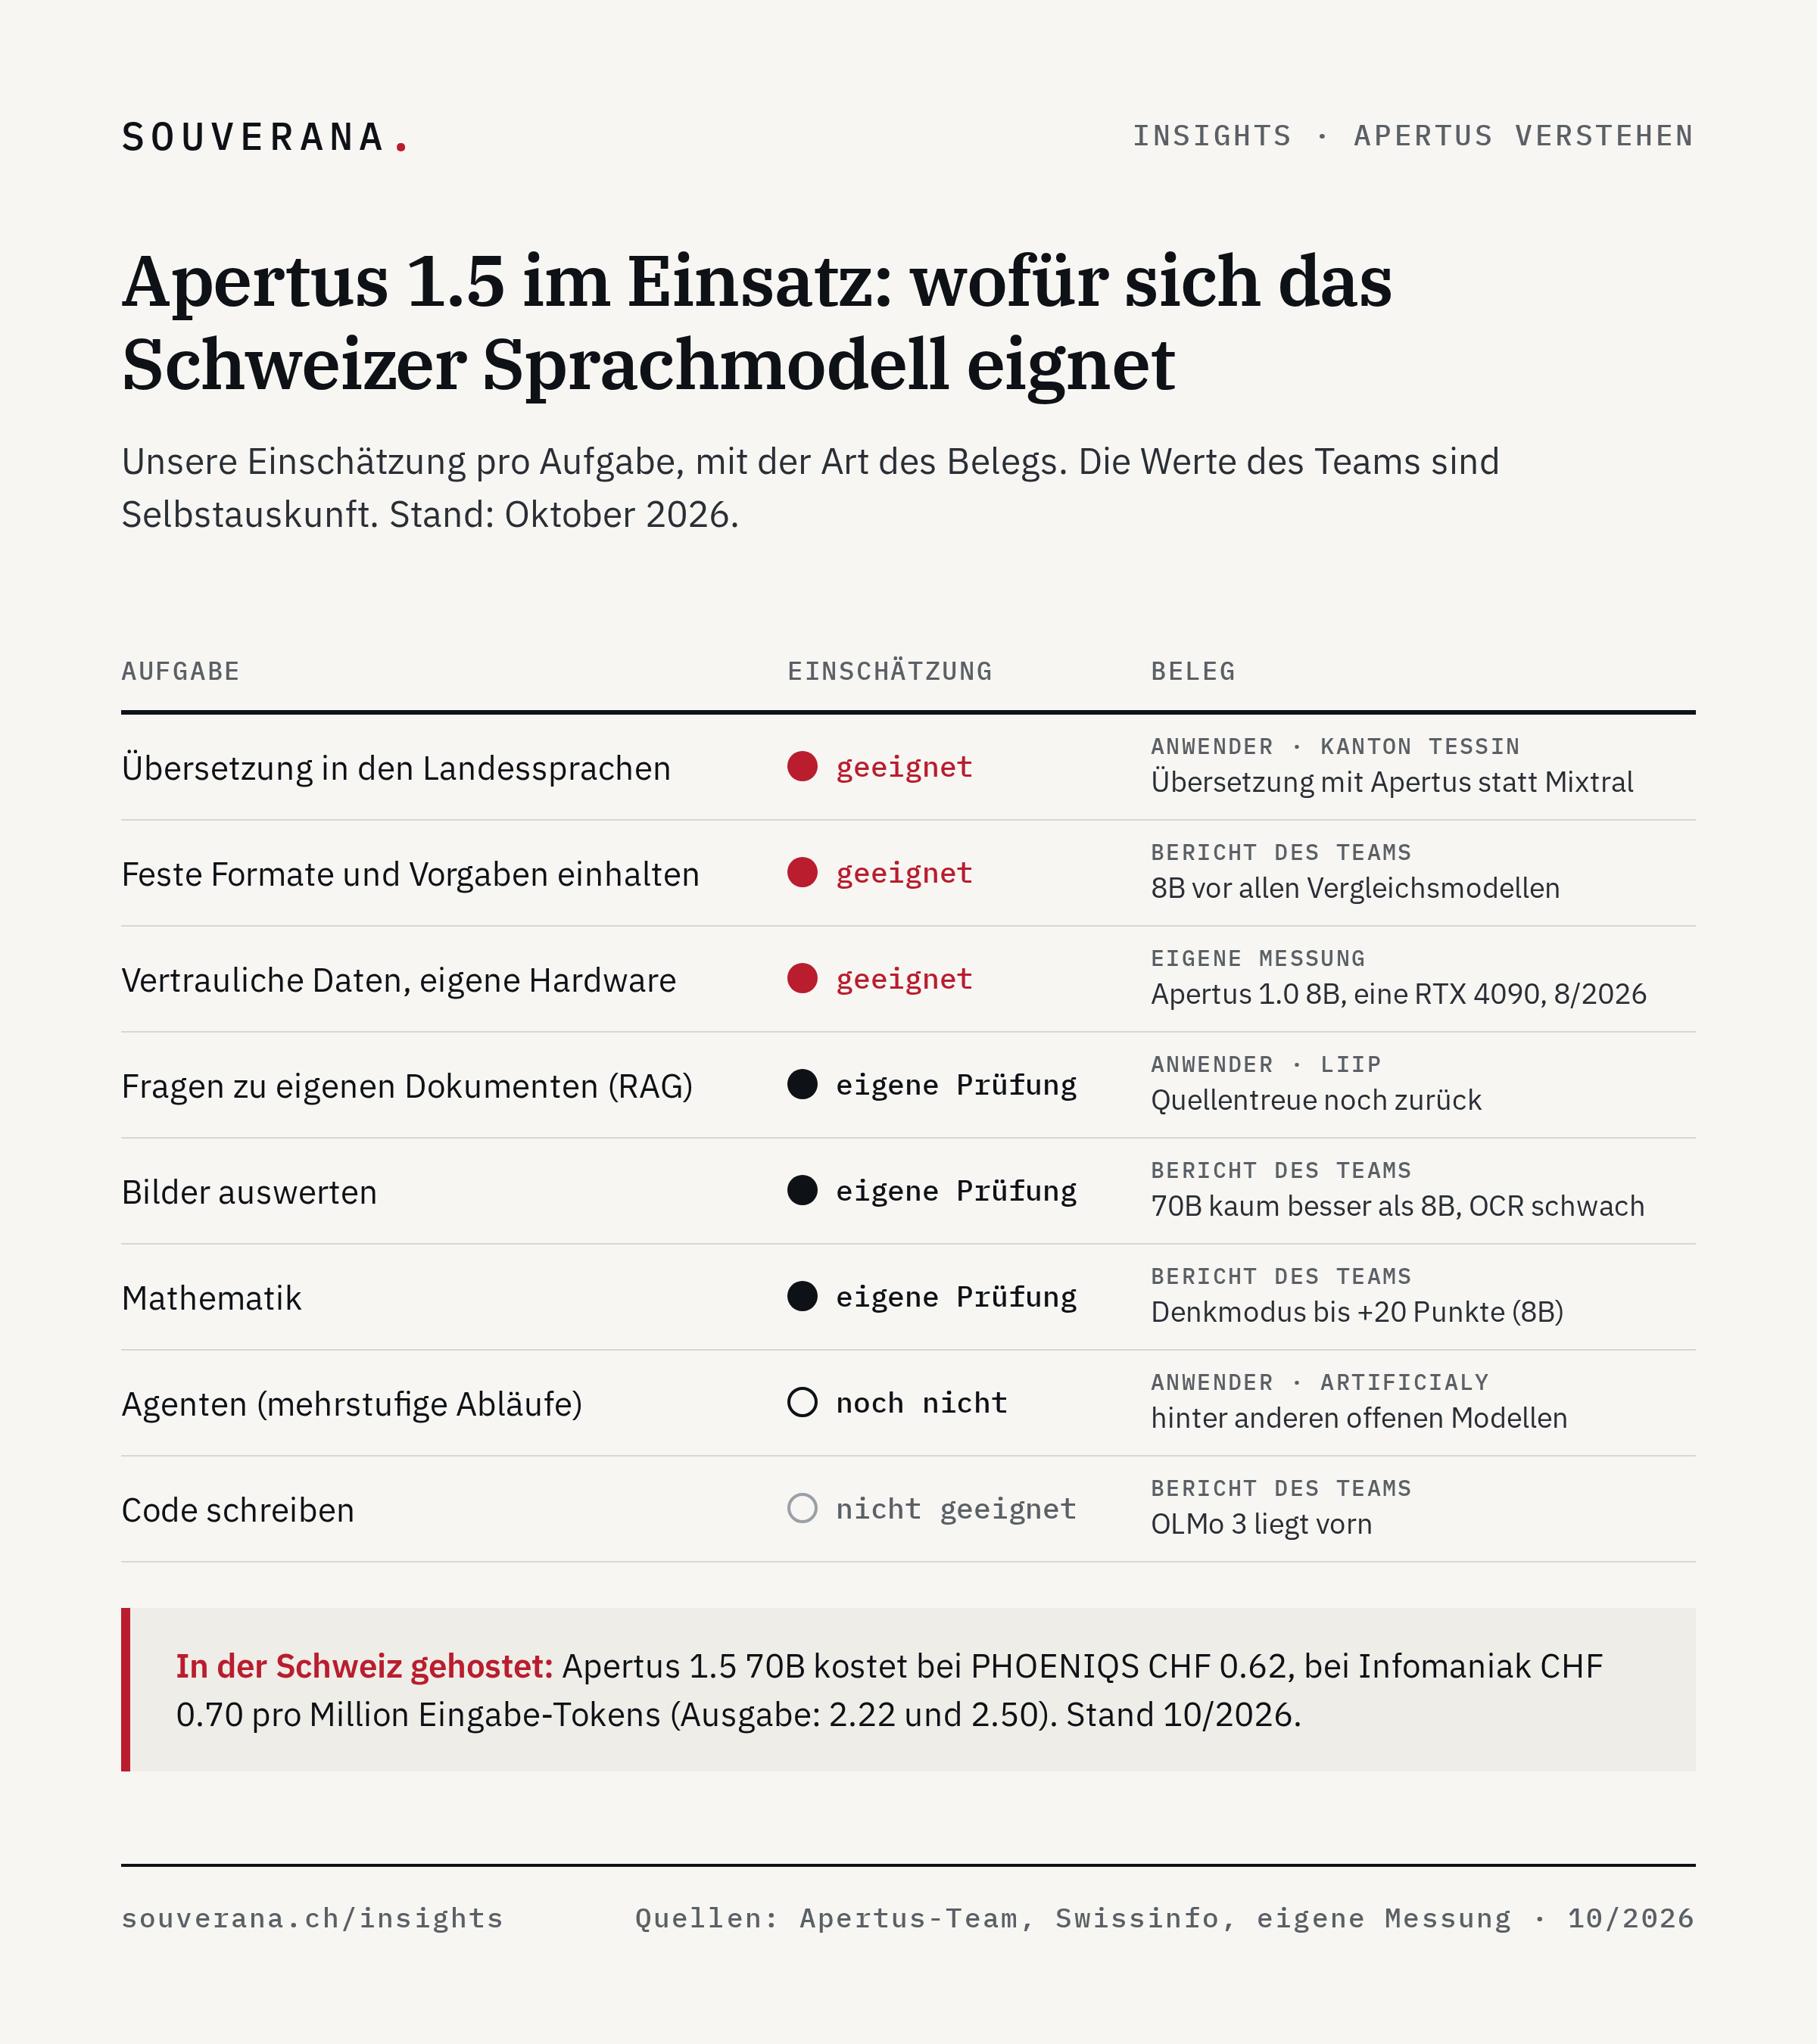
Die Tabelle fasst zusammen, wofür wir Apertus 1.5 heute einsetzen würden. Die letzte Spalte nennt, worauf die Einschätzung beruht.
| Aufgabe | Einschätzung | Beleg |
|---|---|---|
| Übersetzung in den Landessprachen | geeignet | Anwender: Artificialy, Kanton Tessin |
| Feste Formate und Vorgaben einhalten | geeignet | Bericht des Teams |
| Vertrauliche Daten auf eigener Hardware | geeignet, 8B auf einer Karte | eigene Messung (Version 1.0) |
| Fragen zu eigenen Dokumenten (RAG) | mit eigener Prüfung | Anwender: Liip; eigene Messung |
| Bilder auswerten | mit eigener Prüfung, 8B genügt, Scans mit OCR-Modell | Bericht des Teams |
| Mathematik | nur mit Denkmodus und eigener Prüfung | Bericht des Teams |
| Agenten | noch nicht | Anwender: Artificialy |
| Code | nein | Bericht des Teams |
Antwortet das Modell direkt Ihren Kunden, prüfen Sie zusätzlich, ob seine veröffentlichte Werte-Charta zu Ihren eigenen Richtlinien passt.
So setzen Sie Apertus ein
Für den Einstieg empfehlen wir drei Schritte.
- 01
Eine Aufgabe wählen
Nehmen Sie eine begrenzte Aufgabe in mehreren Landessprachen, bei der die Herkunft der Trainingsdaten zählt, etwa die Übersetzung interner Dokumente oder Antworten aus einem Handbuch.
- 02
Gegen ein starkes offenes Modell vergleichen
Lassen Sie Apertus und ein starkes Modell mit offenen Gewichten dieselben zehn Testfälle aus Ihrem Alltag lösen, mit Ihren eigenen Dokumenten und in Ihren Sprachen. Bewerten Sie Suche und Antwort getrennt und notieren Sie die Tokens pro Sprache.
- 03
Den Wechsel einplanen
Bauen Sie die Anwendung so, dass das Modell hinter einer Standardschnittstelle steht. Dann wechseln Sie später mit einer geänderten Einstellung auf Apertus 2.0 oder auf ein anderes Modell.
Quellen
Für die Geschäftsleitung
Dieses Dossier als PDF
Den vollständigen Beitrag plus eine kompakte Management-Zusammenfassung und Checkliste, als PDF zum Speichern und Weiterleiten.
Sie erhalten das PDF sofort. Mit dem Absenden stimmen Sie zu, dass Souverana Sie zu diesem Thema kontaktieren darf. Verarbeitung in der Schweiz/EU, keine Weitergabe an Dritte, Widerruf jederzeit (revDSG).
Häufige Fragen
- Wofür eignet sich Apertus im Unternehmen?
- Apertus 1.5 eignet sich für Übersetzungen in den Landessprachen und für Aufgaben, bei denen belegt sein muss, womit das Modell trainiert wurde. Laut dem Bericht des Teams befolgt das 8B-Modell Anweisungen besser als alle verglichenen Modelle. Antworten aus eigenen Dokumenten verlangen eine eigene Prüfung. Für Agenten, Code und Mathematik liegen andere offene Modelle vorn.
- Wo kann man Apertus in der Schweiz als API nutzen, und was kostet es?
- Laut Apertus-Team bieten unter anderem Swisscom, Infomaniak, PHOENIQS und Safe Swiss Cloud das 70B-Modell in der Schweiz an (Stand September 2026). Für Apertus 1.5 70B verlangt Infomaniak 0.70 Franken pro Million Eingabe-Tokens und 2.50 Franken pro Million Ausgabe-Tokens, PHOENIQS 0.6195 und 2.2201 Franken (Stand Oktober 2026). Swisscom veröffentlicht keinen Preis.
- Ist Apertus für Agenten und Programmieraufgaben geeignet?
- Heute nicht. Laut dem Bericht zu Apertus 1.5 liegt das offene Modell OLMo 3 bei Mathematik und Code vorn. Damiano Binaghi von der Tessiner Firma Artificialy, die Apertus für Übersetzungen einsetzt, sieht das Modell bei agentischen Aufgaben noch nicht auf dem Niveau anderer offener Modelle (Swissinfo, September 2026).
- Braucht Apertus auf Deutsch mehr Tokens als auf Englisch?
- Ja. In einer Messung von Souverana an der Bundesverfassung (Oktober 2026) brauchte Apertus für den deutschen Text 17 Prozent mehr Tokens als für den englischen, für den französischen 21 und für den italienischen 28 Prozent mehr. Vom deutschen Text passt deshalb rund 15 Prozent weniger ins Kontextfenster als vom englischen. Was ein Token kostet, legt der Anbieter fest.
- Kann man Apertus auf eigener Hardware betreiben?
- Ja. Das 8B-Modell der Version 1.0 lief in einer Messung von Souverana (August 2026) auf einer einzelnen Grafikkarte, einer RTX 4090 mit der Server-Software vLLM. Mit acht Nutzern und 8'000 Tokens geteiltem Kontext sank die Wartezeit auf das erste Zeichen dank Prefix-Caching von 17.9 auf 0.9 Sekunden.
- Wer setzt Apertus bereits ein?
- Der Kanton Tessin stellt sein Übersetzungswerkzeug für Verwaltungsdokumente auf ein feinjustiertes Apertus-8B im kantonalen Rechenzentrum um, in einer ersten Phase testen es rund 100 Angestellte. Die EPFL nutzt Apertus als Basis ihrer medizinischen Pipeline MeditronFO, AI Singapore setzt es in der Forschung ein. Vor dem Start von Version 1.5 haben 15 Organisationen die Gewichte geprüft, darunter das Bundesgericht und Swisscom.
Diesen Beitrag teilen
Fertig formatierte Grafiken und ein Textvorschlag für Ihren LinkedIn-Post: herunterladen, kopieren, posten.
Textvorschlag
Prüfen Sie gerade, ob sich das Schweizer Sprachmodell Apertus für Ihren Betrieb eignet?

Der Kanton Tessin hat laut Swissinfo entschieden, Verwaltungsdokumente künftig mit Apertus zu übersetzen. Das Werkzeug läuft auf einem feinjustierten Apertus-8B im Rechenzentrum der kantonalen Informatik, in einer ersten Phase testen es rund 100 Angestellte. Schweizer Hoster bieten Version 1.5 mit 70 Milliarden Parametern an, Infomaniak zum Beispiel für 0.70 Franken pro Million Eingabe-Tokens (Stand Oktober 2026).

Wir haben den Bericht des Teams, die Erfahrungen von Liip und Artificialy und unsere eigenen Messungen nach Aufgaben geordnet. Für Übersetzungen in den Landessprachen zieht Artificialy Apertus anderen Modellen oft vor, besonders bei sensiblen Dokumenten. Bei Agenten liegt es nach Einschätzung derselben Firma noch hinter anderen offenen Modellen, bei Mathematik und Code laut dem Bericht des Teams hinter OLMo 3.

Unser Schluss: Apertus lohnt sich heute für einzelne Aufgaben in den Landessprachen, bei denen Sie belegen müssen, womit das Modell trainiert wurde.

Im Beitrag stehen die Schweizer Hoster mit ihren Preisen, was ein deutscher Text gegenüber einem englischen an Tokens kostet, unsere Messung mit Apertus-8B auf einer einzelnen Grafikkarte und ein Arbeitsblatt mit zehn Testfällen für den Vergleich an eigenen Daten. Link in den Kommentaren.

#Apertus #KI #Schweiz #Datensouveränität #OpenSource