LLM-Quantisierung verstehen und richtig einsetzen
Quantisierung speichert die Zahlen eines Modells mit weniger Bits, damit ein grosses Modell auf bezahlbare Grafikkarten passt und schneller antwortet. Der Beitrag zeigt, wie das funktioniert, wie Sie selbst quantisieren und wie Sie die Stufe finden, bei der die Qualität hält.
Technik · Veröffentlicht 14.08.2026 · Aktualisiert 14.08.2026 · Joel Barmettler
Wie setze ich Quantisierung richtig ein?
Quantisierung speichert die Zahlen eines KI-Modells mit weniger Bits. Die 4-Bit-Datei des offenen Modells Qwen3.6-27B belegt 17.1 GB gegenüber 29.0 GB bei 8 Bit. In unserer Messung mit der Software llama.cpp im August 2026 kostete dieser Schritt bei keiner der drei geprüften Aufgaben mehr als vier Prozentpunkte. Unter 3 Bit brach das Rechnen ein.
Das Wichtigste in Kürze
- Quantisierung ist der wirksamste Hebel im Betrieb. Beim Modell Qwen3.6-27B (eigene Messung, August 2026) braucht die 4-Bit-Datei mit 17 bis 19 GB rund ein Drittel der 57 GB einer 16-Bit-Fassung. Bei einem Nutzer lief die 4-Bit-Fassung unter vLLM auf unseren zwei RTX 4090 mehr als doppelt so schnell wie die 8-Bit-Fassung (65.9 gegenüber 30.3 Tokens pro Sekunde), und auf derselben Grafikkarte bedient sie mehr Nutzer gleichzeitig.
- Starten Sie bei 4 Bit: mit Q4_K_M, wenn Sie die Software llama.cpp nutzen, mit AWQ bei vLLM, einer Serversoftware für Modelle. Der Schritt von 8 auf 4 Bit kostete bei uns fast nichts. Der gesparte Platz auf der Karte steht dem KV-Cache zur Verfügung, dem Zwischenspeicher, der mit jedem gleichzeitigen Nutzer wächst.
- Der Dateiname nennt nur die Bitzahl und sagt nichts über die Qualität. Unsere 5-Bit-Datei (Q5_K_M) rechnete schlechter als die 4-Bit-Datei, und zwar bei den Fassungen von zwei unabhängigen Anbietern.
- Ein Wissenstest (Fragen zu Fakten) genügt nie für die Abnahme. Wissen überlebt bis 2 Bit fast unversehrt, das Rechnen bricht deutlich früher ein. Beim Programmieren gewann die Q4_K_M-Datei, beim Rechnen die grösste Datei: Dieselben Dateien landen je nach Aufgabe auf anderen Rängen.
- Für die Abnahme reicht ein Nachmittag: je Stufe rund eine Stunde für zwei Standard-Benchmarks gegen den eigenen Server.
Quantisierung ist der Grund, warum lokale KI auf bezahlbarer Hardware funktioniert. Im ersten Teil dieser Serie lief ein Modell auf dem Niveau von GPT-5.1 auf zwei Consumer-Grafikkarten, im zweiten wurde aus dem gesparten Speicher Platz für gleichzeitige Nutzer. Beides gibt es nur quantisiert, und wer den Mechanismus versteht, kann auf derselben Hardware ein grösseres Modell betreiben.
Verstehen lohnt sich auch aus einem zweiten Grund. Auf Hugging Face, der Plattform für Modelldateien, liegen für unser 27-Milliarden-Modell dutzende fertig quantisierte Dateien, erzeugt von Dritten, mit Namen wie Q4_K_M oder IQ2_XXS. Der Name nennt die Bits. Was die Datei kann, nennt er nicht, und ein zu grob quantisiertes Modell stürzt nicht ab, es antwortet einfach öfter falsch.
Dieser Beitrag zeigt deshalb, wie Quantisierung arbeitet, einmal selbst durchgespielt, und was sie kostet, gemessen an sieben Stufen desselben Modells auf drei Aufgaben.
Was Quantisierung ist
Die Gewichte eines Sprachmodells sind Milliarden von Kommazahlen, gespeichert in 16 Bit je Zahl. Quantisierung speichert dieselben Zahlen gröber, mit 8, 4 oder noch weniger Bits. Ein 27-Milliarden-Modell schrumpft so im Speicher von 57 auf rund 19 GB und passt damit überhaupt erst auf bezahlbare Karten.
Stumpfes Runden würde das Modell zerstören, denn mit 4 Bit lassen sich nur 16 verschiedene Werte darstellen. Der Trick ist, in kleinen Gruppen zu arbeiten: Die Gewichte werden in Blöcke von 32 Zahlen geteilt, jeder Block speichert einen eigenen, fein aufgelösten Massstab, und jede Zahl speichert nur noch ihre Position auf diesem Massstab. Weil benachbarte Gewichte ähnliche Grössenordnungen haben, funktioniert das gut, und der Verlust je Zahl bleibt klein.
Wie viel Verlust am Ende bei den Antworten ankommt, entscheidet sich an einer anderen Stelle: bei der Frage, welche Schichten wie viele Bits bekommen. Das zeigt das folgende Beispiel am besten.
Quantisieren Sie einmal selbst
Der ganze Vorgang besteht aus zwei Kommandos und braucht keine GPU. Wir haben ihn für ein kleines Modell auf unserer Maschine durchgespielt:
# 1. Originalgewichte in das GGUF-Format überführen, volle Präzision
docker run --rm -v ~/.cache/huggingface/hub:/hub -v $PWD:/out   ghcr.io/ggml-org/llama.cpp:full   --convert /hub/models--Qwen--Qwen3.5-0.8B/snapshots/<hash>   --outfile /out/f16.gguf --outtype f16

# 2. Auf 4 Bit quantisieren
docker run --rm -v $PWD:/out ghcr.io/ggml-org/llama.cpp:full   --quantize /out/f16.gguf /out/q4_k_m.gguf Q4_K_M
Der erste Schritt dauerte 6 Sekunden, der zweite 3.5. Aus 1’475 MB wurden 506.
Interessanter als das Ergebnis ist das Protokoll. Das Werkzeug entscheidet je Schicht, wie grob sie werden darf:
token_embd.weight      f16 -> q6_K   485.0 MB -> 198.9 MB
blk.0.attn_qkv.weight  f16 -> q6_K    12.0 MB ->   4.9 MB
blk.0.ffn_gate.weight  f16 -> q4_K     7.0 MB ->   2.0 MB
output_norm.weight     f32  (bleibt unangetastet)
Das Embedding (die Tabelle, die Wörter in Zahlen übersetzt) und die Attention (der Teil, der Bezüge zwischen Wörtern herstellt) bekommen 6 Bit, die Feed-Forward-Schichten (der grösste Teil der Gewichte) 4 Bit, und die Normierungen bleiben in voller Präzision. Deshalb steht im Log auch 5.50 Bits je Gewicht für eine Datei, die «Q4» heisst: Der Name nennt das Budget, die Verteilung über die Schichten entscheidet der Autor des Werkzeugs. Merken Sie sich diesen Satz, er erklärt weiter unten einen Messbefund.
Die Formate: GGUF, AWQ und die anderen
Quantisierte Dateien begegnen Ihnen in mehreren Formaten, und die Wahl folgt der Engine, mit der Sie hosten (der Software, die das Modell ausführt). Die Spalte «Kalibrierung» nennt, ob beim Quantisieren Beispieldaten durch das Modell laufen:
| Format | Kalibrierung | Wo es läuft |
|---|---|---|
| GGUF Q8_0, Q6_K, Q5_K_M, Q4_K_M | keine | llama.cpp, Ollama |
| GGUF IQ-Stufen (IQ2_XXS …) | meist mit Kalibrierdaten | llama.cpp, unter 3 Bit |
| AWQ | Kalibrierdaten | vLLM, SGLang |
| GPTQ | Kalibrierdaten | vLLM, älterer Standard |
| bitsandbytes (NF4) | keine, quantisiert beim Laden | transformers, Fine-Tuning |
| FP8 | keine, echtes Zahlenformat | vLLM, oft direkt vom Hersteller |
Zum Lesen der GGUF-Namen: Die Zahl nennt das grobe Bit-Budget, das K steht für die eben gezeigte Mischtechnik, der Buchstabe am Ende (S, M, L) für deren Varianten. IQ-Stufen komprimieren unter 3 Bit und stützen sich dafür meist auf eine Wichtigkeitsmatrix aus Kalibrierdaten.
AWQ und GPTQ gehen einen Schritt weiter als GGUF: Sie schicken beim Quantisieren Beispieldaten durch das Modell und schützen gezielt die Gewichte, die für die Ausgaben am wichtigsten sind. bitsandbytes quantisiert erst beim Laden und erzeugt gar keine Datei. Es ist bequem für Experimente und Fine-Tuning, für den Produktivbetrieb aber weniger geeignet. FP8 schliesslich ist ein echtes 8-Bit-Zahlenformat, das neuere Karten direkt rechnen können. Hersteller wie Qwen liefern manche Modelle offiziell so aus.
Ob die Formatwahl die Qualität beeinflusst, haben wir ebenfalls gemessen, das Ergebnis steht weiter unten.
Sieben Stufen, drei Aufgaben
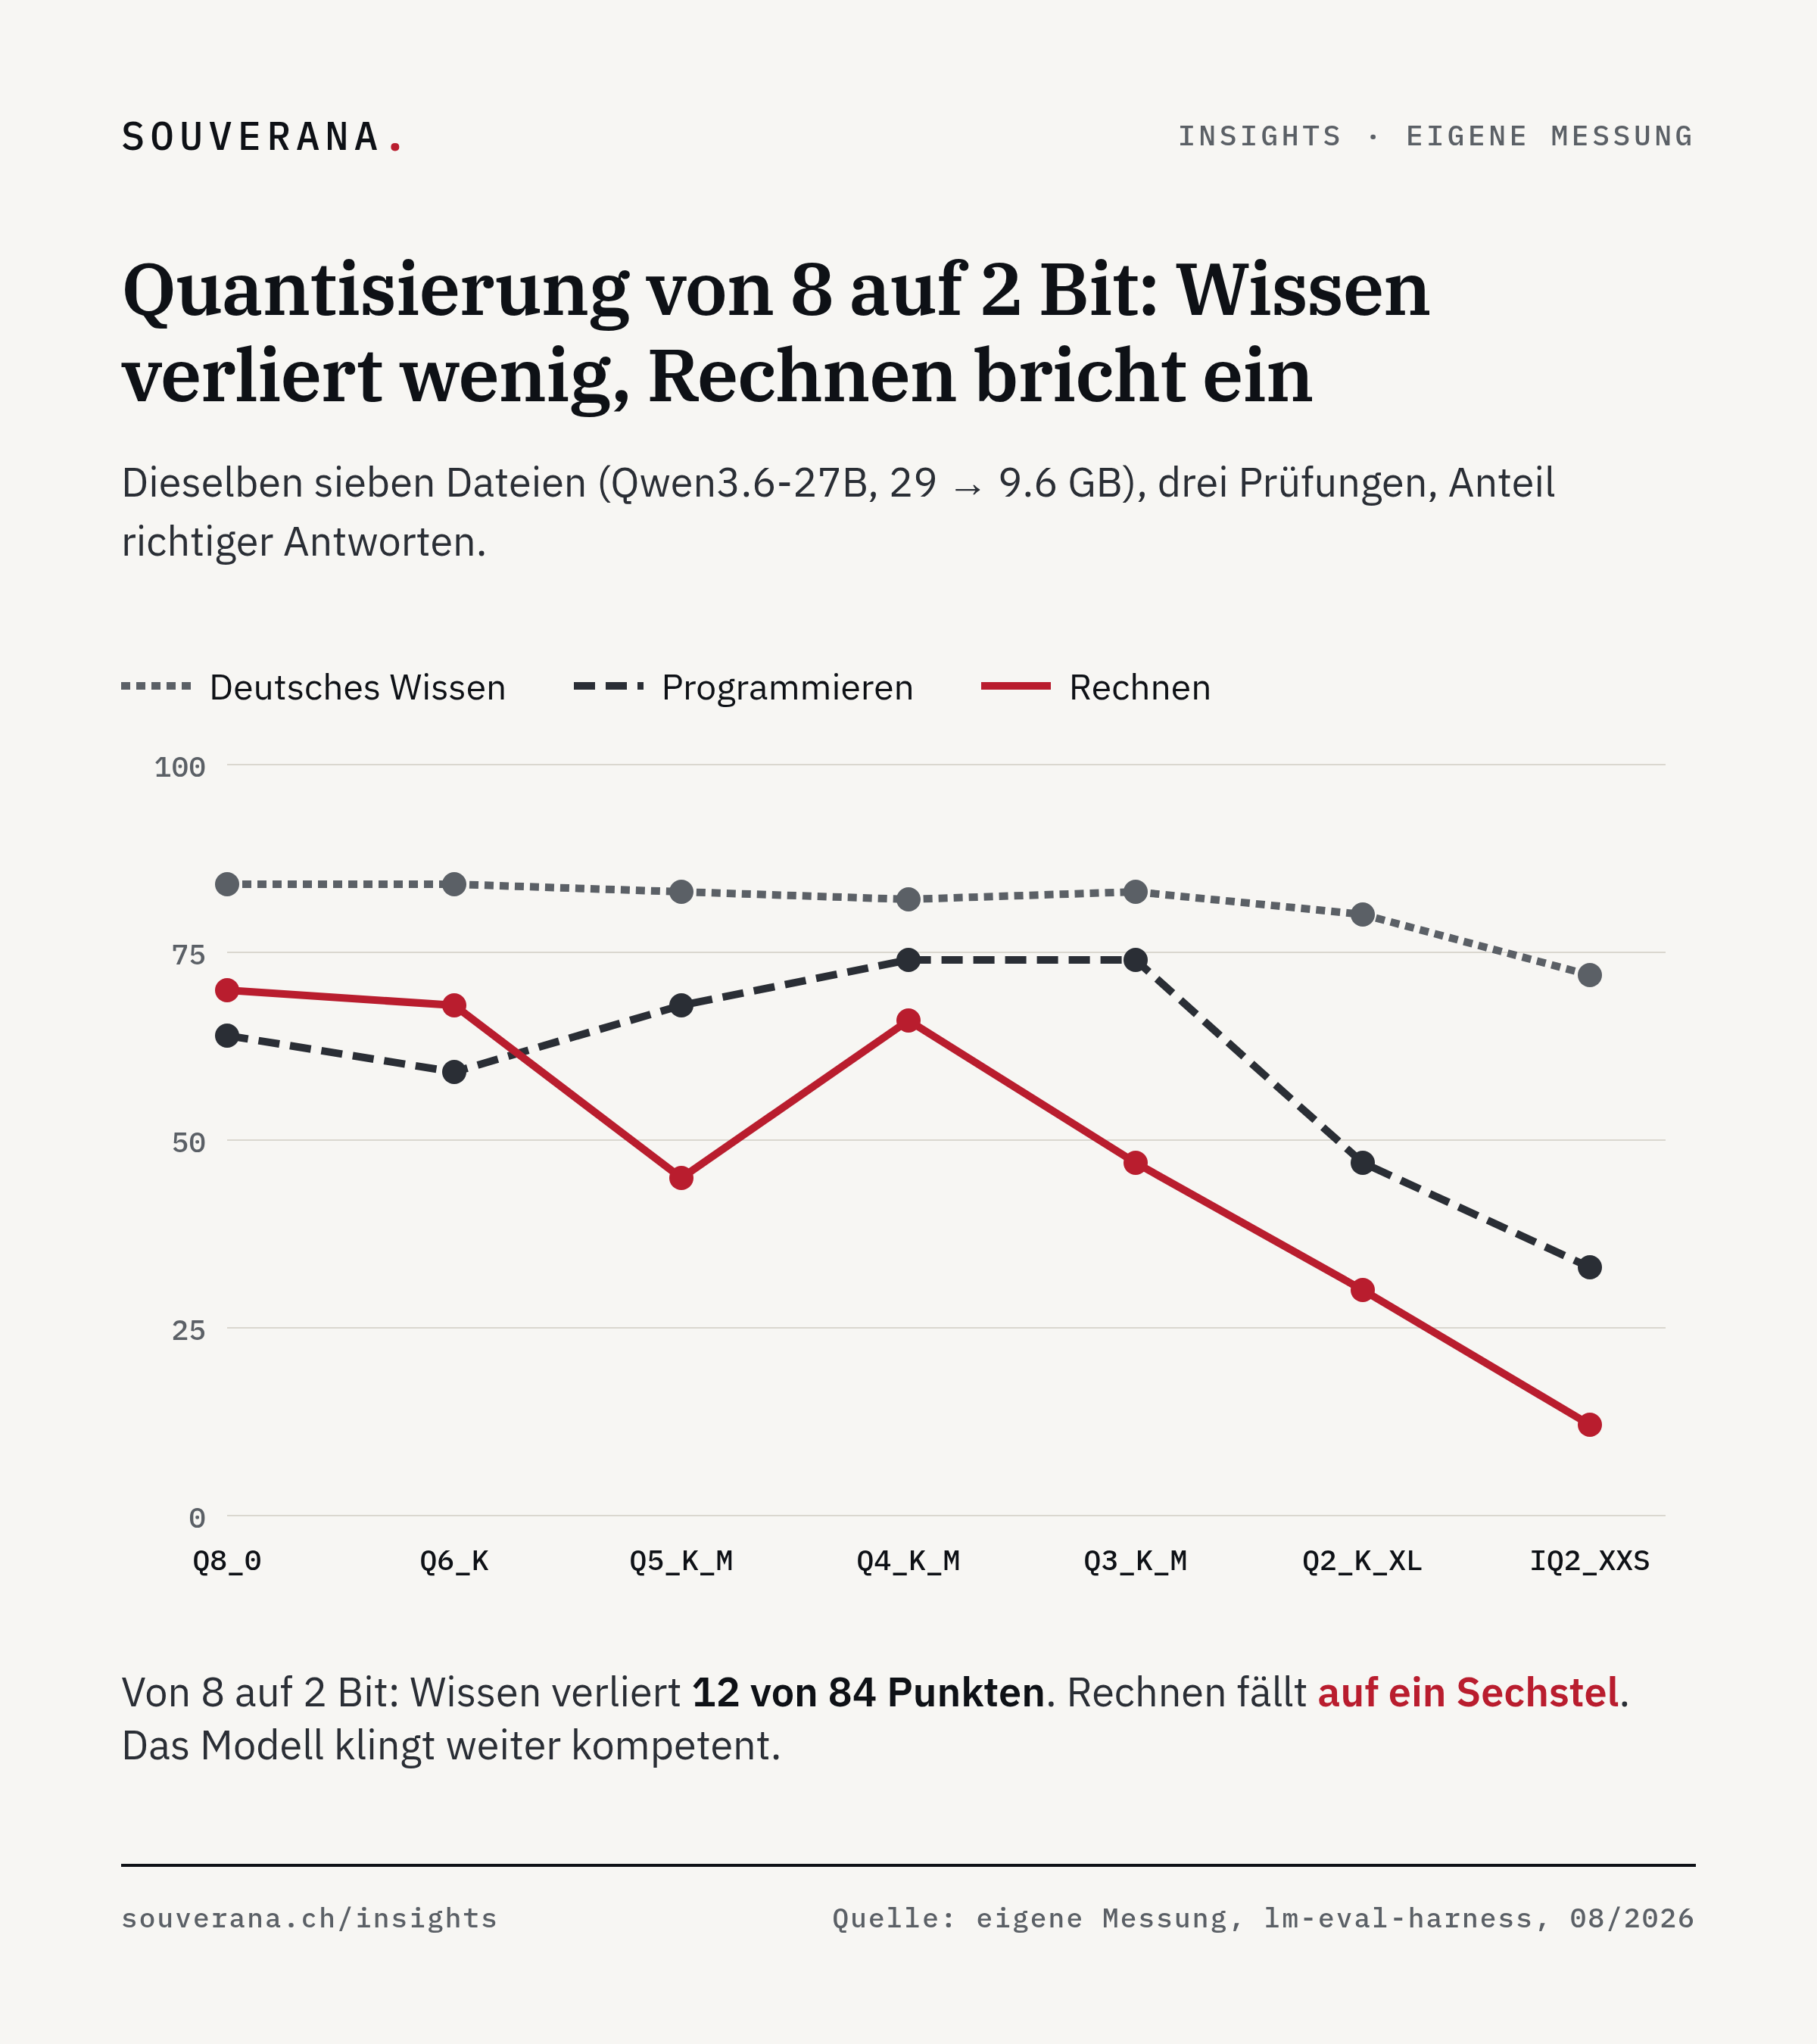
Gemessen haben wir Qwen3.6-27B mit llama.cpp auf einer oder zwei RTX 4090 (die grössten Stufen passen nicht auf eine einzelne Karte), jede Stufe mit denselben drei Prüfungen (Benchmarks, also standardisierte Tests mit festen Fragen): Rechenaufgaben in Textform (GSM8K), Programmieraufgaben mit ausführbarer Lösung (MBPP) und deutsche Wissensfragen (Global-MMLU). Je 200 Fragen, beim deutschen Wissen 100; angegeben ist der Anteil richtiger Antworten. Unterschiede unter etwa 7 Punkten (Deutsch: 10) sind bei diesen Stichproben nicht belastbar.
| Stufe | Datei | Rechnen | Programmieren | Deutsches Wissen |
|---|---|---|---|---|
| Q8_0 | 29.0 GB | 70 % | 64 % | 84 % |
| Q6_K | 22.9 GB | 68 % | 59 % | 84 % |
| Q5_K_M | 19.8 GB | 45 % | 68 % | 83 % |
| Q4_K_M | 17.1 GB | 66 % | 74 % | 82 % |
| Q3_K_M | 13.8 GB | 47 % | 74 % | 83 % |
| Q2_K_XL | 12.0 GB | 30 % | 47 % | 80 % |
| IQ2_XXS | 9.6 GB | 12 % | 33 % | 72 % |
Die Tabelle zeigt drei Befunde.
Von 8 auf 4 Bit passiert fast nichts. Beim Rechnen verliert das Modell vier Punkte, beim Deutschen zwei, beim Programmieren wird die kleinere Datei sogar besser. Dabei schrumpft die Datei von 29 auf 17 GB. Der gesparte Platz auf der Karte steht dem KV-Cache zur Verfügung und damit weiteren gleichzeitigen Nutzern.
Zwischen 3 und 2 Bit bricht die Qualität ein. Q3_K_M programmiert noch exakt so gut wie Q4_K_M und verliert beim Rechnen bereits ein Drittel. Ab Q2 sinken alle drei Werte: IQ2_XXS löst beim Rechnen noch 12 Prozent der Aufgaben, also fast keine.
Und das Modell läuft dabei immer weiter. Warum die sinkende Qualität niemandem auffällt, der nur Antworten überfliegt, zeigt der Abschnitt «Wissen überlebt, Rechnen nicht».
Diese Messreihe stammt von einem einzigen Modell. Ob der Einbruch bei anderen Modellen an derselben Stelle liegt, haben wir nicht gemessen. Wo er bei Ihrem liegt, zeigt nur die eigene Messung.
Eine grössere Datei kann schlechter antworten
Der Ausreisser in der Tabelle ist Q5_K_M: 45 Prozent beim Rechnen, zwanzig Punkte unter der kleineren Q4_K_M-Datei. Ein solcher Wert ist normalerweise ein Messfehler, deshalb haben wir kontrolliert: drei unabhängige Läufe derselben Datei (45, 44, 47 Prozent), danach dieselbe Stufe von einem zweiten Anbieter (51 Prozent). Ein defekter Download scheidet damit aus. Diese Stufe rechnet bei diesem Modell bei zwei Anbietern schlechter als die Stufe darunter.
Die Ursache können wir nicht beweisen. Der Mechanismus aus dem Quantize-Log oben liefert aber eine Erklärung: Der Name nennt das Bit-Budget, die Verteilung über die Schichten wählt das Werkzeug. Unser Modell ist ein Hybrid mit rekurrenten Schichten (sie reichen einen Zustand von Wort zu Wort weiter), und vermutlich verteilt die Q5-Mischung die Bits für genau diese Schichten ungünstig.
Code und Mathematik sortieren dieselben Dateien gegenläufig
Lesen Sie die Tabelle einmal nur mit der Rechnen-Spalte und einmal nur mit der Programmieren-Spalte. Beim Rechnen gewinnt die grösste Datei (70 Prozent), beim Programmieren die Q4_K_M-Datei (74 Prozent, die viertkleinste), und die zweitgrösste Datei liegt dort mit 59 Prozent hinter jeder Datei bis hinunter zu 3 Bit.
Wer nur den Mathematiktest gefahren hätte, hätte Q8_0 gewählt und beim Programmieren zehn Punkte weniger erreicht als mit der besten Datei. Wer nur den Codetest gefahren hätte, hätte Q3_K_M gewählt und beim Rechnen ein Drittel eingebüsst.
Deshalb taugt kein einzelner Benchmark als Freigabe. Es braucht zwei bis drei, und sie müssen der eigenen Aufgabe entsprechen: Wer Code erzeugen lässt, misst Code. Wer deutsche Fachfragen beantworten lässt, misst deutsche Fachfragen.
Wissen überlebt, Rechnen nicht
Die deutsche Spalte verhält sich über alle sieben Stufen anders als die beiden anderen. Das ist der wichtigste Befund der Messreihe:
| Q8_0 | IQ2_XXS | Verlust | |
|---|---|---|---|
| Rechnen | 70 % | 12 % | auf ein Sechstel |
| Programmieren | 64 % | 33 % | fast halbiert |
| Deutsches Wissen | 84 % | 72 % | 12 Punkte (14 Prozent) |
Von 8 auf 2 Bit verliert das Modell fast seine gesamte Rechenfähigkeit und behält fast sein gesamtes Wissen. Ein zu stark quantisiertes Modell weiss weiterhin, was das revidierte Datenschutzgesetz ist, formuliert noch sauber, und hängt keine drei Denkschritte mehr korrekt aneinander.
Für die Abnahme heisst das: Ein Wissenstest gibt ein Modell frei, das nicht mehr zuverlässig rechnen kann. Wer prüft, ob eine Quantisierung taugt, muss das Modell Rechenaufgaben oder mehrstufige Aufgaben lösen lassen, denn dort bricht die Qualität zuerst ein.
«Nativ» ist kein Qualitätsversprechen
Neben den Community-Dateien bieten manche Hersteller eigene quantisierte Fassungen an. Qwen liefert das 27-Milliarden-Modell offiziell in FP8, also mit 8 Bit je Parameter, vom Hersteller selbst erzeugt. Das klingt nach der sicheren Wahl gegenüber einer 4-Bit-Datei aus der Community.
In unserer Messung ist die Community-Fassung bei Speicher und Tempo besser und beim Rechnen gleichauf:
| AWQ (Community, 4 Bit) | FP8 (Hersteller, 8 Bit) | |
|---|---|---|
| Speicher je Karte | 9.7 GB | 14.5 GB |
| Tempo bei einem Nutzer | 65.9 Tok/s | 30.3 Tok/s |
| Rechnen | 65 % | 62 % |
Die FP8-Fassung hat doppelt so viele Bits, erreicht nur das halbe Tempo (Tok/s steht für Token pro Sekunde) und braucht anderthalbmal so viel Speicher. Der Qualitätsunterschied liegt innerhalb des Messfehlers. Warum die 4-Bit-Fassung so viel schneller ist, haben wir nicht isoliert. Vermutlich laufen die 4-Bit-Kernels der Engine (die Rechenroutinen für die Grafikkarte) auf unseren RTX 4090 besonders schnell. Auf einer anderen Kartengeneration kann dieselbe Wahl anders ausgehen.
Der Vergleich dient zugleich als Gegenprobe für die Messreihe: AWQ unter vLLM (65 Prozent) und Q4_K_M unter llama.cpp (66 Prozent) sind zwei verschiedene 4-Bit-Verfahren auf zwei verschiedenen Engines und landen beim selben Wert. Die Messung ist also stabil, und der Q5-Ausreisser fällt umso mehr auf.
Beim Einkauf von Rechenleistung gilt dieselbe Vorsicht: Hoster betreiben unter dem Namen eines Modells oft eine stillschweigend quantisierte Fassung. Was das für den Preisvergleich bedeutet, steht im Beitrag zu den LLM-Kosten.
So messen Sie selbst
Fertige Benchmarks reichen, wenn sie zur Aufgabe passen. Für die Durchführung eignet sich das lm-evaluation-harness von EleutherAI, ein Werkzeug, das Benchmarks gegen OpenAI-kompatible Server fährt, also auch gegen Ihren eigenen. Mit zwei Tests à 200 Fragen kostet eine Stufe rund eine Stunde, die ganze Abnahme über drei Stufen einen Nachmittag. So gehen Sie vor:
- 01
Zwei bis drei Benchmarks wählen, die zur Aufgabe passen
Für Code MBPP oder HumanEval, für Rechnen und mehrstufiges Arbeiten GSM8K, für deutsches Fachwissen Global-MMLU. Mindestens einer davon muss mehrstufiges Schliessen prüfen.
- 02
Mit 200 Fragen je Test fahren
Das begrenzt den Standardfehler auf rund 3.5 Punkte: gut genug für 20-Punkte-Ausreisser wie unseren, zu grob für Feinvergleiche. Für die Wahl zwischen zwei Stufen reicht es.
- 03
Die Kandidaten-Stufen mit gleichen Einstellungen messen
Q4_K_M als Startpunkt, dazu die Stufe darüber und darunter. Ändern Sie zwischen den Läufen nur die Datei, sonst lässt sich ein Unterschied nicht mehr zuordnen.
- 04
Bei jedem Wechsel neu messen
Neue Modellversion, neuer Anbieter der Quantisierung, neue Engine-Version: derselbe Durchgang noch einmal. Der Q5-Fall zeigt, dass sich das nicht vorhersagen lässt.
Zwei Fallen haben uns dabei je einen Fehlversuch gekostet, beide erzeugen falsche Zahlen ohne Fehlermeldung. Code-Benchmarks führen den erzeugten Code aus und brauchen dafür zwei ausdrückliche Freigaben; fehlt eine davon, läuft der Test scheinbar durch und liefert eine leere Tabelle. Und ein Reasoning-Modell (es denkt vor der Antwort in einem Zwischentext) verbraucht sein Antwortbudget unsichtbar in diesem Denkteil. Bleibt das Reasoning eingeschaltet, steht am Ende exakt 0.0. Das sieht nach einem kaputten Modell aus, ist aber ein falsch konfigurierter Messaufbau. Die Kommandos, die beide Fallen umgehen, stehen im Anhang der PDF-Fassung.
Mit der Quantisierung ist das Modell gewählt und geprüft. Welche Software es ausliefert, klärt der vierte Teil der Serie, und der fünfte rechnet aus, was der ganze Aufbau kostet.
Für die Geschäftsleitung
Dieses Dossier als PDF
Den vollständigen Beitrag plus eine kompakte Management-Zusammenfassung und Checkliste, als PDF zum Speichern und Weiterleiten.
Sie erhalten das PDF sofort. Mit dem Absenden stimmen Sie zu, dass Souverana Sie zu diesem Thema kontaktieren darf. Verarbeitung in der Schweiz/EU, keine Weitergabe an Dritte, Widerruf jederzeit (revDSG).
Häufige Fragen
- Welche Quantisierung soll ich für ein lokales LLM wählen?
- Beginnen Sie mit 4 Bit: Q4_K_M für die Software llama.cpp, AWQ für die Serversoftware vLLM. In unserer Messung kostete der Schritt von 8 auf 4 Bit auf keiner der drei geprüften Aufgaben mehr als vier Prozentpunkte, sparte aber 41 Prozent des Speichers. Unter 3 Bit brach die Rechenfähigkeit ein.
- Verliert ein Modell durch Quantisierung an Qualität?
- Je nach Aufgabe verschieden stark. Zwischen 8 und 4 Bit lagen in unserer Messung nur wenige Prozentpunkte, teils war die kleinere Datei besser. Ab 2 Bit fiel die Rechenfähigkeit auf ein Sechstel, während deutsches Fachwissen 14 Prozent verlor. Das Modell wirkt dann weiterhin kompetent und rechnet trotzdem falsch.
- Was bedeutet Q4_K_M?
- Eine Quantisierungsstufe im Dateiformat GGUF, das die Software llama.cpp liest: rund 4 Bit je Parameter, wobei die K-Verfahren wichtige Schichten genauer speichern als unwichtige. Die Buchstaben dahinter (S, M, L) bezeichnen Varianten dieser Mischung. Wie gut diese Mischung zu Ihrer Aufgabe passt, zeigt der Dateiname nicht.
- Ist AWQ besser als GGUF?
- AWQ und GGUF sind zwei Formate für quantisierte Modelle. Bei gleicher Bitzahl lagen beide in unserer Messung gleichauf: AWQ unter vLLM erreichte 65 Prozent auf dem Mathematiktest, Q4_K_M unter llama.cpp 66. Die Wahl hängt von der Engine ab, also der Software, die das Modell ausführt: GGUF gehört zu llama.cpp und Ollama, AWQ zu vLLM.
- Wie prüfe ich, ob eine Quantisierung für meine Aufgabe reicht?
- Mit zwei bis drei Standard-Benchmarks, die Ihrer Aufgabe entsprechen, ausgeführt mit dem Testwerkzeug lm-evaluation-harness gegen den eigenen Server. Mit 200 Fragen je Test dauert das etwa eine Stunde je Stufe. Wichtig ist ein Test, der Rechnen oder mehrstufiges Arbeiten prüft, denn genau das bricht zuerst.
Diesen Beitrag teilen
Fertig formatierte Grafiken und ein Textvorschlag für Ihren LinkedIn-Post: herunterladen, kopieren, posten.
Textvorschlag
Wollen Sie ein grösseres Modell auf Ihre Grafikkarte bringen? Dann führt der Weg über Quantisierung.

Quantisierung speichert die Zahlen eines Modells mit weniger Bits. Deshalb schrumpft ein Modell von 29 GB bei 8 Bit auf 9.6 GB bei 2 Bit und läuft auf Hardware, die im eigenen Betrieb stehen kann. Die Frage ist, was dabei verloren geht.

Wir haben dasselbe Modell über sieben Stufen vermessen, mit drei Prüfungen (lm-eval-harness). Von 8 auf 2 Bit verliert deutsches Fachwissen 12 von 84 Punkten, Rechnen fällt auf ein Sechstel. Und der Dateiname allein genügt nicht: Unsere 5-Bit-Datei rechnete schlechter als die 4-Bit-Datei, bei zwei unabhängigen Anbietern.

Unser Schluss: Ein zu stark quantisiertes Modell klingt weiter kompetent, weil das Wissen am längsten erhalten bleibt. Es rechnet nur nicht mehr zuverlässig. Messen Sie die gewählte Stufe deshalb an Ihrer eigenen Aufgabe, eine Stunde je Stufe genügt.

Im Beitrag stehen die ganze Messreihe, der Unterschied zwischen GGUF, AWQ und FP8 sowie eine Anleitung, wie Sie ein Modell selbst quantisieren. Link in den Kommentaren.

#KI #LLM #Quantisierung #Schweiz